
تکنیکهای پرامپت نویسی کمک میکنند از «امتحانکردن چند جمله» به «فهمیدن اینکه چرا یک پرامپت بهتر است» برسید. در قسمت اول دیدیم پرامپت از دستور، محتوا و زمینه ساخته میشود. حالا وقت آن است که روشهای مشخصی برای حل مسائل سختتر یاد بگیریم.
در این مقاله هفت تکنیک اصلی را با مثال واقعی مرور میکنیم. بعد یاد میگیرید با پارامتر temperature، پاسخ مدل را ثابتتر یا متنوعتر کنید. این متن قسمت دوم از مجموعهی «از پرامپت تا دستیار هوش مصنوعی» است و همهی این روشها روی هر مدل زبانی قابل اجرا هستند.
چرا پرامپت ساده کافی نیست؟
یک پرامپت ساده مثل «ده سؤال جغرافیا بساز» را در نظر بگیرید. در همین یک جمله دو تکنیک پنهان است. اول، زمینه را مشخص کردهاید: جغرافیا. دوم، خروجی را محدود کردهاید: حداکثر ده سؤال.
اما احتمالاً دقیقاً به چیزی که میخواهید نمیرسید. شما هم تجربهاش را داشتهاید؟ این اتفاق دو دلیل اصلی دارد:
- موضوع خیلی گسترده است: معلوم نیست سؤالها دربارهی کشورها باشند، پایتختها یا رودخانهها.
- قالب مشخص نیست: شاید سؤال چهارگزینهای بخواهید یا جدولی با پاسخ. مدل این را حدس نمیزند.
نکتهی جالب این است که پرامپتنویسی یک ویژگی «ساختهشده» در مدل نیست. قابلیتی است که هنگام استفاده از مدل کشف میکنیم. برای همین این تکنیکها را باید مثل ابزار دید، نه قانون.
تکنیکهای پرامپت نویسی در یک نگاه
پیش از ورود به جزئیات، جدول زیر هر هفت تکنیک را کنار هم میگذارد. ستون آخر نشان میدهد هر کدام برای چه نوع کاری مناسبتر است.
| تکنیک | ایدهی اصلی | مناسب برای |
|---|---|---|
| Zero-shot | فقط دستور، بدون نمونه | پرسشهای عمومی و ساده |
| Few-shot | چند نمونه از خروجی دلخواه | سبک، لحن و قالب ثابت |
| زنجیرهی فکر | نشاندادن مراحل حل یک مسئلهی مشابه | محاسبه و استدلال چندمرحلهای |
| دانش تولیدشده | افزودن دادهی خودتان به پرامپت | پاسخ بر اساس اطلاعات سازمان |
| کمترینبهبیشترین | شکستن مسئله به زیرمسئلهها | پروژهها و کارهای بزرگ |
| خوداصلاحی | نقد پاسخ و درخواست نسخهی بهتر | کد، متن و طرح اولیه |
| پرسش سقراطی | توضیح جزءبهجزء پاسخ | بررسی سازگاری و درستی |
هفت تکنیک پرامپت نویسی با مثال
هر تکنیک را با یک مثال کوتاه بررسی میکنیم. پیشنهاد میکنم همزمان با خواندن، مثالها را در ChatGPT یا هر دستیار دیگری امتحان کنید و خروجی را با متن مقایسه کنید.
Zero-shot؛ سادهترین شکل پرسیدن
در zero-shot فقط یک درخواست میفرستید و مدل بر اساس دانستههای خودش جواب میدهد. مثلاً میپرسید «جبر چیست؟» و پاسخ میگیرید: «شاخهای از ریاضیات که نمادها و قواعد کار با آنها را بررسی میکند.»
این همان روشی است که بیشتر ما کار با هوش مصنوعی را با آن شروع میکنیم. برای پرسشهای عمومی کافی است. اما هرچه کار تخصصیتر شود، کنترل شما بر قالب و دقت پاسخ کمتر میشود.
Few-shot؛ نشاندادن بهجای توضیحدادن
در few-shot چند نمونه از خروجی مطلوب را همراه درخواست میفرستید. مثلاً سه غزل از حافظ را میآورید و بعد مینویسید «حالا در همین سبک غزلی دربارهی ماه بگو». مدل وزن، لحن و قالب را از روی نمونهها تشخیص میدهد.
نمونهها به مدل زمینه، قالب و سبک میدهند. این کار مخصوصاً وقتی مفید است که توضیح دادن سبک با کلمات سخت باشد. بهجای ده خط توصیف لحن برند، دو نمونهی خوب از متنهای قبلی را نشان دهید.
یک نکتهی عملی هم دارد: نمونهها را متنوع انتخاب کنید. اگر همهی نمونهها کوتاه باشند، مدل هم پاسخ کوتاه میدهد؛ حتی اگر چنین چیزی نخواسته باشید.
زنجیرهی فکر (Chain-of-Thought)
زنجیرهی فکر یعنی به مدل نشان دهید یک مسئله را چطور مرحلهبهمرحله حل کند. این همان کاری است که کتابهای کمکدرسی با «مثال حلشده» میکنند؛ دانشآموز اول راهحل یک تمرین را میبیند و بعد تمرین مشابه را خودش حل میکند.
مثال درسنامه ساده اما گویاست: «علی ۵ سیب دارد، ۳ تا را دور میاندازد، ۲ تا به رضا میدهد و رضا یکی را پس میدهد. علی چند سیب دارد؟» مدل در آزمایش اصلی جواب داد ۵، در حالی که پاسخ درست ۱ است.
راهحل این است که پیش از سؤال اصلی، یک مسئلهی مشابه را همراه محاسبهاش بیاورید:
سارا ۷ سیب دارد، ۱ سیب را دور میاندازد، ۴ تا به مریم میدهد و مریم یکی را پس میدهد:
7 - 1 = 6
6 - 4 = 2
2 + 1 = 3
علی ۵ سیب دارد، ۳ تا را دور میاندازد، ۲ تا به رضا میدهد و رضا یکی را پس میدهد. علی چند سیب دارد؟این بار مدل همان الگوی محاسبه را دنبال میکند و به عدد ۱ میرسد. پرامپت طولانیتر شده، اما دقت پاسخ بهوضوح بالا رفته است. در بسیاری از مدلها حتی جملهی کوتاه «مرحلهبهمرحله فکر کن» هم بخشی از همین اثر را دارد.
دانش تولیدشده؛ پرامپت با دادهی خودتان
اغلب میخواهید مدل بر اساس دادهی سازمان شما جواب بدهد، نه دانش عمومیاش. این کار شبیه دادن کاتالوگ و لیست قیمت به فروشندهی تازهکار یک فروشگاه است؛ او دیگر از حافظه قیمت نمیگوید. در این روش بخشی از پرامپت را از دادههای خودتان میسازید. معمولاً یک قالب با متغیرهایی مثل {{products}} دارید که برنامه آن را با دادهی واقعی پر میکند.
درسنامه یک شرکت بیمه را مثال میزند. فهرست بیمهها و قیمتها در پرامپت آمده و از مدل خواسته شده با بودجهی ۱۰۰۰ دلار، بیمهی خودرو، خانه و عمر پیشنهاد دهد. پاسخ اول هر سه بیمهی ارزان را پیشنهاد کرد و جمع هزینه به ۱۲۰۰ دلار رسید؛ یعنی بیشتر از بودجه. پس از چند بار آزمون، پرامپت اینطور اصلاح شد:
Insurance company: ACME Insurance
Insurance products (cost per month):
- type: Car, cheap, cost: 500 USD
- type: Car, expensive, cost: 1100 USD
- type: Home, cheap, cost: 600 USD
- type: Home, expensive, cost: 1200 USD
- type: Life, cheap, cost: 100 USD

Please suggest an insurance given the following budget and requirements:
Budget: $1000 restrict choice to types: Car, Home
افزودن برچسبهای type و cost و کلمهی restrict کافی بود تا مدل فقط در محدودهی درست پیشنهاد بدهد. این بار پاسخ فقط بیمهی ارزان خودرو با ۵۰۰ دلار در ماه بود که در بودجه جا میشود. درس اصلی این مثال روشن است: حتی با دادهی درست، باز هم باید پرامپت را آزمود و بهینه کرد.
بیشتر بخوانید: آموزش پرامپت نویسی از صفر؛ اصول مهندسی پرامپت با مثال
کمترینبهبیشترین (Least-to-Most)
در این تکنیک یک مسئلهی بزرگ را به زیرمسئلههای کوچکتر میشکنید. مثل بازسازی خانه که یکباره انجام نمیشود؛ اول لولهکشی، بعد گچکاری و در آخر رنگ. مثلاً میپرسید «علم داده را در پنج مرحله چطور انجام دهم؟» و مدل پاسخ میدهد: جمعآوری داده، پاکسازی، تحلیل، نمودارسازی و ارائه.
حالا هر مرحله را جداگانه و به ترتیب از مدل میخواهید. این روش شبیه زنجیرهی فکر است، با این تفاوت که مسیر حل را خود مدل پیشنهاد میدهد و شما قدمبهقدم جلو میروید. برای پروژههایی که یکجا در یک پاسخ جا نمیشوند بسیار کاربردی است.
خوداصلاحی (Self-Refine)
خروجی مدل را نمیشود چشمبسته پذیرفت. مدل محتملترین ادامه را مینویسد، نه لزوماً درستترین را. در خوداصلاحی، پاسخ اول را میگیرید و آن را نقد میکنید یا از خود مدل میخواهید نقدش کند. سپس نسخهی بهتر را درخواست میکنید. درست مثل نویسندهای که پیشنویسش را یک بار با چشم ویراستار میخواند.
در مثال درسنامه، مدل یک API ساده با Flask (چارچوب سبک ساخت وبسرویس در پایتون) نوشت. بعد از آن خواسته شد «سه پیشنهاد برای بهبود این کد بده». مدل خطای import را پیدا کرد، اجرای برنامه را اضافه کرد و خروجی مسیرها را پویا کرد. نسخهی دوم بهوضوح از نسخهی اول بهتر بود.
این چرخه را میتوانید چند بار تکرار کنید. فقط تعداد پیشنهادها را محدود کنید و جهت بهبود را مشخص کنید؛ مثلاً امنیت، کارایی یا خوانایی.
پرسش سقراطی (Maieutic)
این تکنیک شبیه خوداصلاحی است، اما تمرکزش روی «توضیح خواستن» است. مثل ممتحنی که در جلسهی دفاع برای هر ادعا میپرسد «چرا؟» تا تناقضها پیدا شوند. اول پاسخ را میگیرید. بعد برای هر بخش از پاسخ، توضیح دقیقتر میخواهید. اگر توضیحها با هم ناسازگار بودند، آن بخش را کنار میگذارید.
مثلاً از مدل پنج گام برای برنامهی مدیریت بحران همهگیری میخواهید. بعد دربارهی گام اول و ریسکهایش سؤال میکنید و در ادامه میپرسید «دو ریسک بزرگ کداماند؟». اگر پاسخها در هر مرحله با هم سازگار بمانند، با اطمینان بیشتری جلو میروید. با این حال، اعتماد کورکورانه هیچوقت درست نیست.
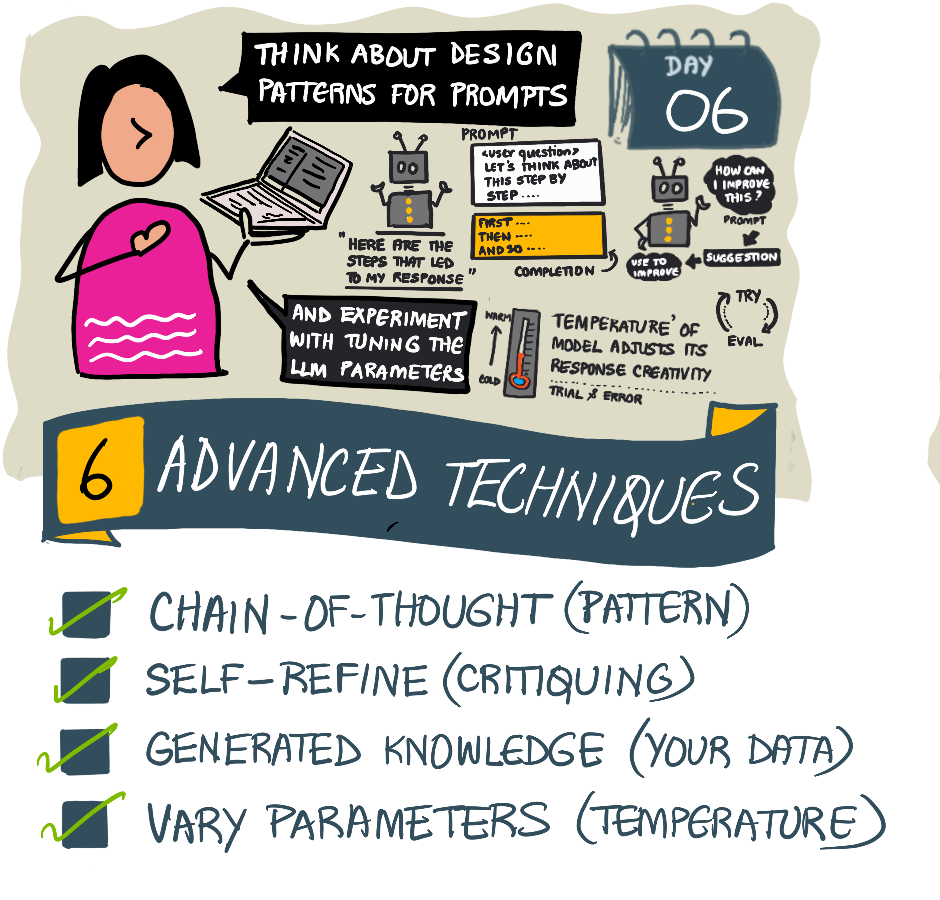
این تکنیکها در عمل با هم ترکیب میشوند. تصویر زیر چهار الگوی پرکاربرد را کنار هم نشان میدهد: زنجیرهی فکر، خوداصلاحی، دانش تولیدشده و تنظیم پارامترها.
کنترل تنوع خروجی با temperature
مدلهای زبانی ذاتاً غیرقطعیاند. یک پرامپت یکسان را دو بار اجرا کنید؛ دو پاسخ متفاوت میگیرید. در درسنامه، درخواست «کد یک Web API با پایتون بنویس» یک بار API ساده داد و بار دوم یک API کامل کتابها.
temperature چیست و چطور تنظیمش کنیم؟
temperature (دما) پارامتری است که میزان تصادفی بودن انتخاب کلمهی بعدی را تعیین میکند. تصور کنید در رستوران همیشگی سفارش میدهید؛ با دمای پایین همیشه پرطرفدارترین غذا را میگیرید و با دمای بالا گاهی غذای کمتر شناختهشده را امتحان میکنید. البته دمای بالا یعنی ریسک بیشتر، نه لزوماً خلاقیت بهتر.
هرچه temperature به صفر نزدیکتر باشد، پاسخ قطعیتر و تکرارپذیرتر است. در مقابل، هرچه بالاتر برود، پاسخ متنوعتر میشود. درسنامه بازه را ۰ تا ۱ و پیشفرض را ۰٫۷ میگوید، اما این عددها در هر سرویس فرق دارد. برای نمونه، در API پیامهای Anthropic بازه ۰ تا ۱ و در API اوپنایآی ۰ تا ۲ است و پیشفرض هر دو ۱ است.
در آزمایش درسنامه، با temperature برابر ۰٫۱ دو اجرای پشتسرهم تقریباً یک کد را تولید کردند. با ۰٫۹، دو اجرا آنقدر متفاوت بودند که انگار دو برنامهنویس جداگانه نوشته بودند. پس تنوع خروجی لزوماً مشکل نیست؛ بستگی دارد چه میخواهید.
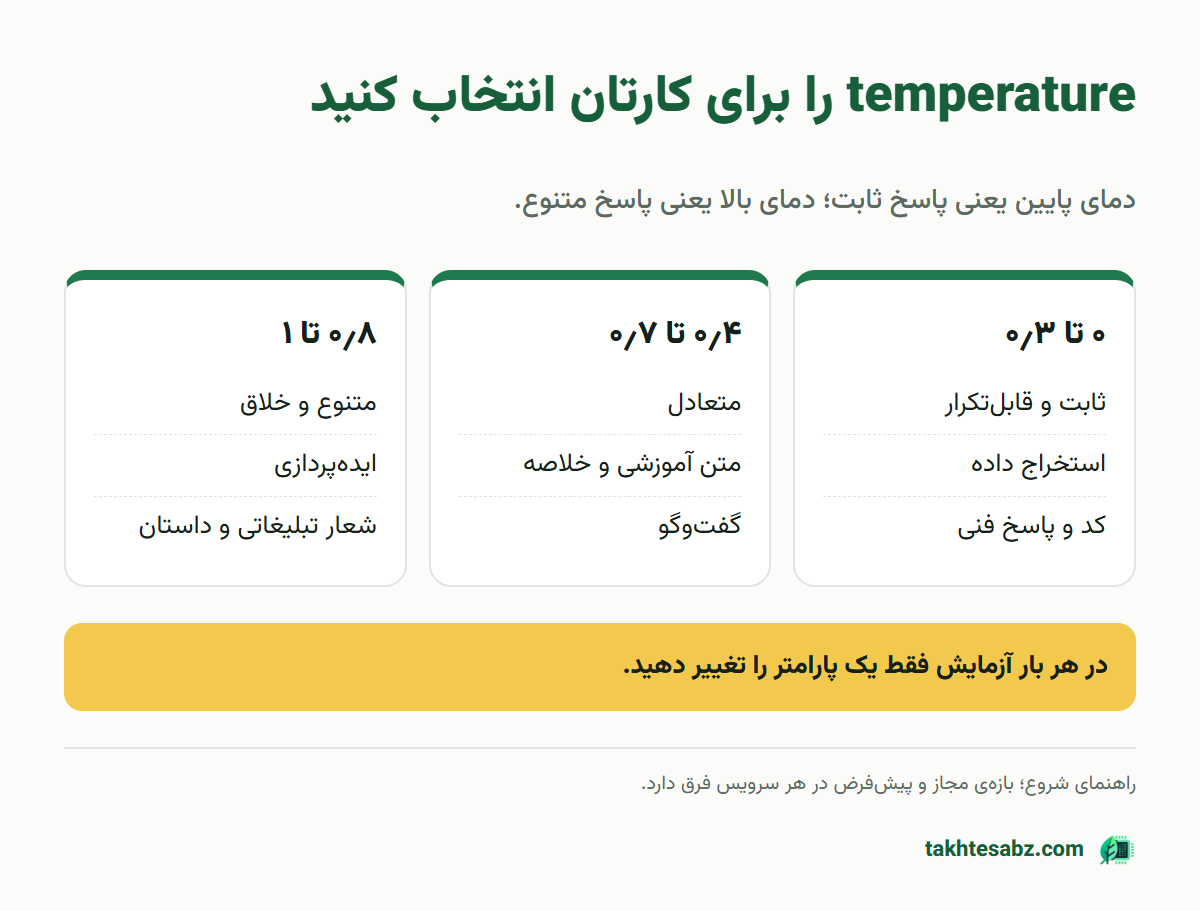
اگر پاسخ مشخص و ثابت لازم دارید، temperature را پایین بیاورید. اگر ایدههای متنوع میخواهید، آن را بالا ببرید. جدول و تصویر زیر یک راهنمای شروعاند، نه قانون.
| مقدار temperature | رفتار مدل | کاربرد پیشنهادی |
|---|---|---|
| ۰ تا ۰٫۳ | ثابت و قابلتکرار | استخراج داده، کد، پاسخ فنی |
| ۰٫۴ تا ۰٫۷ | متعادل | متن آموزشی، خلاصه، گفتوگو |
| ۰٫۸ تا ۱ | متنوع و خلاق | ایدهپردازی، شعار تبلیغاتی، داستان |
پارامترهای دیگر برای تنظیم پاسخ
temperature تنها ابزار کنترل نیست. پارامترهایی مثل top-p و top-k هم دامنهی کلمههای قابل انتخاب را محدود میکنند. جریمهی تکرار هم جلوی تکرار عبارتها را میگیرد.
در شروع کار لازم نیست همه را تنظیم کنید. معمولاً تغییر temperature کافی است. فقط همزمان چند پارامتر را عوض نکنید؛ وگرنه نمیفهمید کدام تغییر روی نتیجه اثر گذاشته است.
پنج عادت خوب در پرامپت نویسی
علاوه بر تکنیکها، چند عادت ساده کیفیت پاسخ را بالا میبرد. با تمرین، سبک شخصی خودتان را هم پیدا میکنید:
- زمینه را مشخص کنید: حوزه، موضوع و مخاطب را بگویید.
- خروجی را محدود کنید: تعداد مورد یا طول دقیق را تعیین کنید.
- هم «چه» و هم «چطور» را بگویید: مثلاً «یک API با مسیرهای محصولات و مشتریان بساز و آن را در سه فایل تقسیم کن».
- از قالب استفاده کنید: دادهی سازمان را با متغیرهای قالب وارد پرامپت کنید.
- درست بنویسید: املا و نگارش درست، پاسخ دقیقتری به همراه دارد.
این پنج عادت روی هر هفت تکنیک اثر مثبت دارند. پرامپتی که زمینه، محدودیت و قالب روشنی دارد، با هر تکنیکی نتیجهی بهتری میدهد.
تمرین عملی؛ خوداصلاحی روی یک کد ساده
کد کوچک زیر یک API ساده با Flask است. اول با pip install flask کتابخانه را نصب کنید و فایل را با python app.py اجرا کنید؛ سپس آدرس http://127.0.0.1:5000/?name=Sara را در مرورگر باز کنید تا خروجی را ببینید:
from flask import Flask, request

app = Flask(__name__)

@app.route('/')
def hello():
    name = request.args.get('name', 'World')
    return f'Hello, {name}!'

if __name__ == '__main__':
    app.run()
حالا کد را به یک دستیار هوش مصنوعی بدهید و تکنیک خوداصلاحی را در سه گام اجرا کنید:
- پرامپت اول: «سه پیشنهاد برای بهبود امنیت این کد بده و دلیل هر کدام را در یک جمله بگو.»
- پرامپت دوم: «پیشنهادها را اعمال کن و نسخهی کامل کد را بنویس.»
- پرامپت سوم: «نسخهی جدید را دوباره نقد کن؛ آیا مشکلی باقی مانده است؟»
در پایان نسخهی اول و آخر را مقایسه کنید و هر تغییر را خودتان اجرا و آزمایش کنید. برای پروژهی مشترک مجموعه هم همین کار را روی پرامپت دستیار دورهها انجام دهید.
سخن پایانی
تکنیکهای پرامپت نویسی جادو نیستند، اما فاصلهی «جواب تصادفی» تا «جواب قابلاعتماد» را کم میکنند. few-shot سبک را منتقل میکند و زنجیرهی فکر استدلال را بهتر میکند. همچنین دانش تولیدشده دادهی شما را وارد بازی میکند و خوداصلاحی کیفیت را مرحلهبهمرحله بالا میبرد. در نهایت temperature تعیین میکند پاسخها تا چه حد ثابت یا متنوع باشند.
در قسمت سوم از پنجرهی چت فاصله میگیریم و اولین برنامهی تولید متن را با کد میسازیم.
این آموزش بر پایهی درس Creating Advanced Prompts از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- آموزش پرامپت نویسی از صفر: قسمت اول همین مجموعه؛ توکن، پیام سیستمی و ساختار پرامپت؛ برای مبتدی.
- Creating Advanced Prompts (انگلیسی): درس اصلی مایکروسافت با همهی مثالهای این مقاله و تمرین؛ برای مبتدی.
- Prompt Engineering Guide؛ بخش Techniques (انگلیسی): فهرست کامل تکنیکها با مثال و لینک مقالهی هر کدام؛ برای متوسط.
- Chain-of-Thought Prompting Elicits Reasoning in Large Language Models (انگلیسی): مقالهی اصلی زنجیرهی فکر از گوگل؛ برای پیشرفته.
- Self-Refine: Iterative Refinement with Self-Feedback (انگلیسی): پژوهش اصلی خوداصلاحی و اندازهگیری اثر آن؛ برای پیشرفته.
پرسشهای پرتکرار
بهترین تکنیک پرامپت نویسی برای مسائل محاسباتی کدام است؟
زنجیرهی فکر (Chain-of-Thought). یک مسئلهی مشابه را همراه راهحل مرحلهبهمرحله در پرامپت بیاورید تا مدل همان روش را روی مسئلهی اصلی اجرا کند.
temperature را روی چه عددی بگذارم؟
برای کارهای دقیق مثل استخراج داده، کد یا پاسخ فنی عددی نزدیک صفر مثل ۰٫۱ تا ۰٫۳ مناسب است. برای ایدهپردازی و متن خلاقانه عددهای بالاتر مثل ۰٫۸ تا ۰٫۹ تنوع بیشتری میدهند. بازهی مجاز در هر سرویس فرق دارد، پس مستندات همان سرویس را ببینید.
فرق خوداصلاحی و پرسش سقراطی چیست؟
در خوداصلاحی از مدل میخواهید پاسخ خودش را نقد و بهتر کند. در پرسش سقراطی از مدل میخواهید هر بخش پاسخ را جداگانه توضیح دهد تا بخشهای ناسازگار پیدا و حذف شوند.
آیا با این تکنیکها دیگر لازم نیست پاسخ مدل را بررسی کنم؟
نه. این تکنیکها احتمال خطا را کم میکنند اما آن را صفر نمیکنند. مدل محتملترین ادامه را مینویسد، نه لزوماً درستترین را؛ پس خروجی مهم را همیشه خودتان بررسی کنید.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.