
آموزش پرامپت نویسی اولین قدم برای گرفتن پاسخ دقیق از هوش مصنوعی است. بیشتر ما کار با ChatGPT یا مدلهای مشابه را با یک سؤال ساده شروع میکنیم. گاهی جواب عالی است و گاهی کاملاً بیربط. تفاوت این دو حالت معمولاً به مدل برنمیگردد؛ به متنی برمیگردد که برایش نوشتهایم.
در این مقاله یاد میگیرید مدل زبانی پرامپت را چطور میخواند، یک پرامپت از چه بخشهایی ساخته میشود و چطور با مثال، نشانه و قالب، خروجی قابلپیشبینی بگیرید. این متن قسمت اول از مجموعهی بیستقسمتی «از پرامپت تا دستیار هوش مصنوعی» است. در پایان هر بخش هم یک تمرین کوچک برای پروژهی مشترک مجموعه داریم.
مهندسی پرامپت چیست و چرا اهمیت دارد؟
هوش مصنوعی مولد میتواند متن، تصویر، صدا و کد تازه بسازد. این کار را با مدلهای زبانی بزرگ (LLM) انجام میدهد. شما یک متن ورودی میفرستید که به آن «پرامپت» میگویند و مدل یک پاسخ برمیگرداند. بعد میتوانید در چند نوبت گفتوگو، درخواست را اصلاح کنید تا پاسخ به خواستهتان نزدیک شود.
به همین دلیل پرامپت عملاً «رابط برنامهنویسی» هوش مصنوعی مولد شده است. مهندسی پرامپت یعنی طراحی و بهینهسازی همین ورودیها تا در مقیاس بالا هم پاسخ ثابت و باکیفیت بگیریم. این کار دو مرحله دارد: طراحی پرامپت اولیه برای یک هدف مشخص و اصلاح مرحلهبهمرحلهی آن تا کیفیت پاسخ بهتر شود.
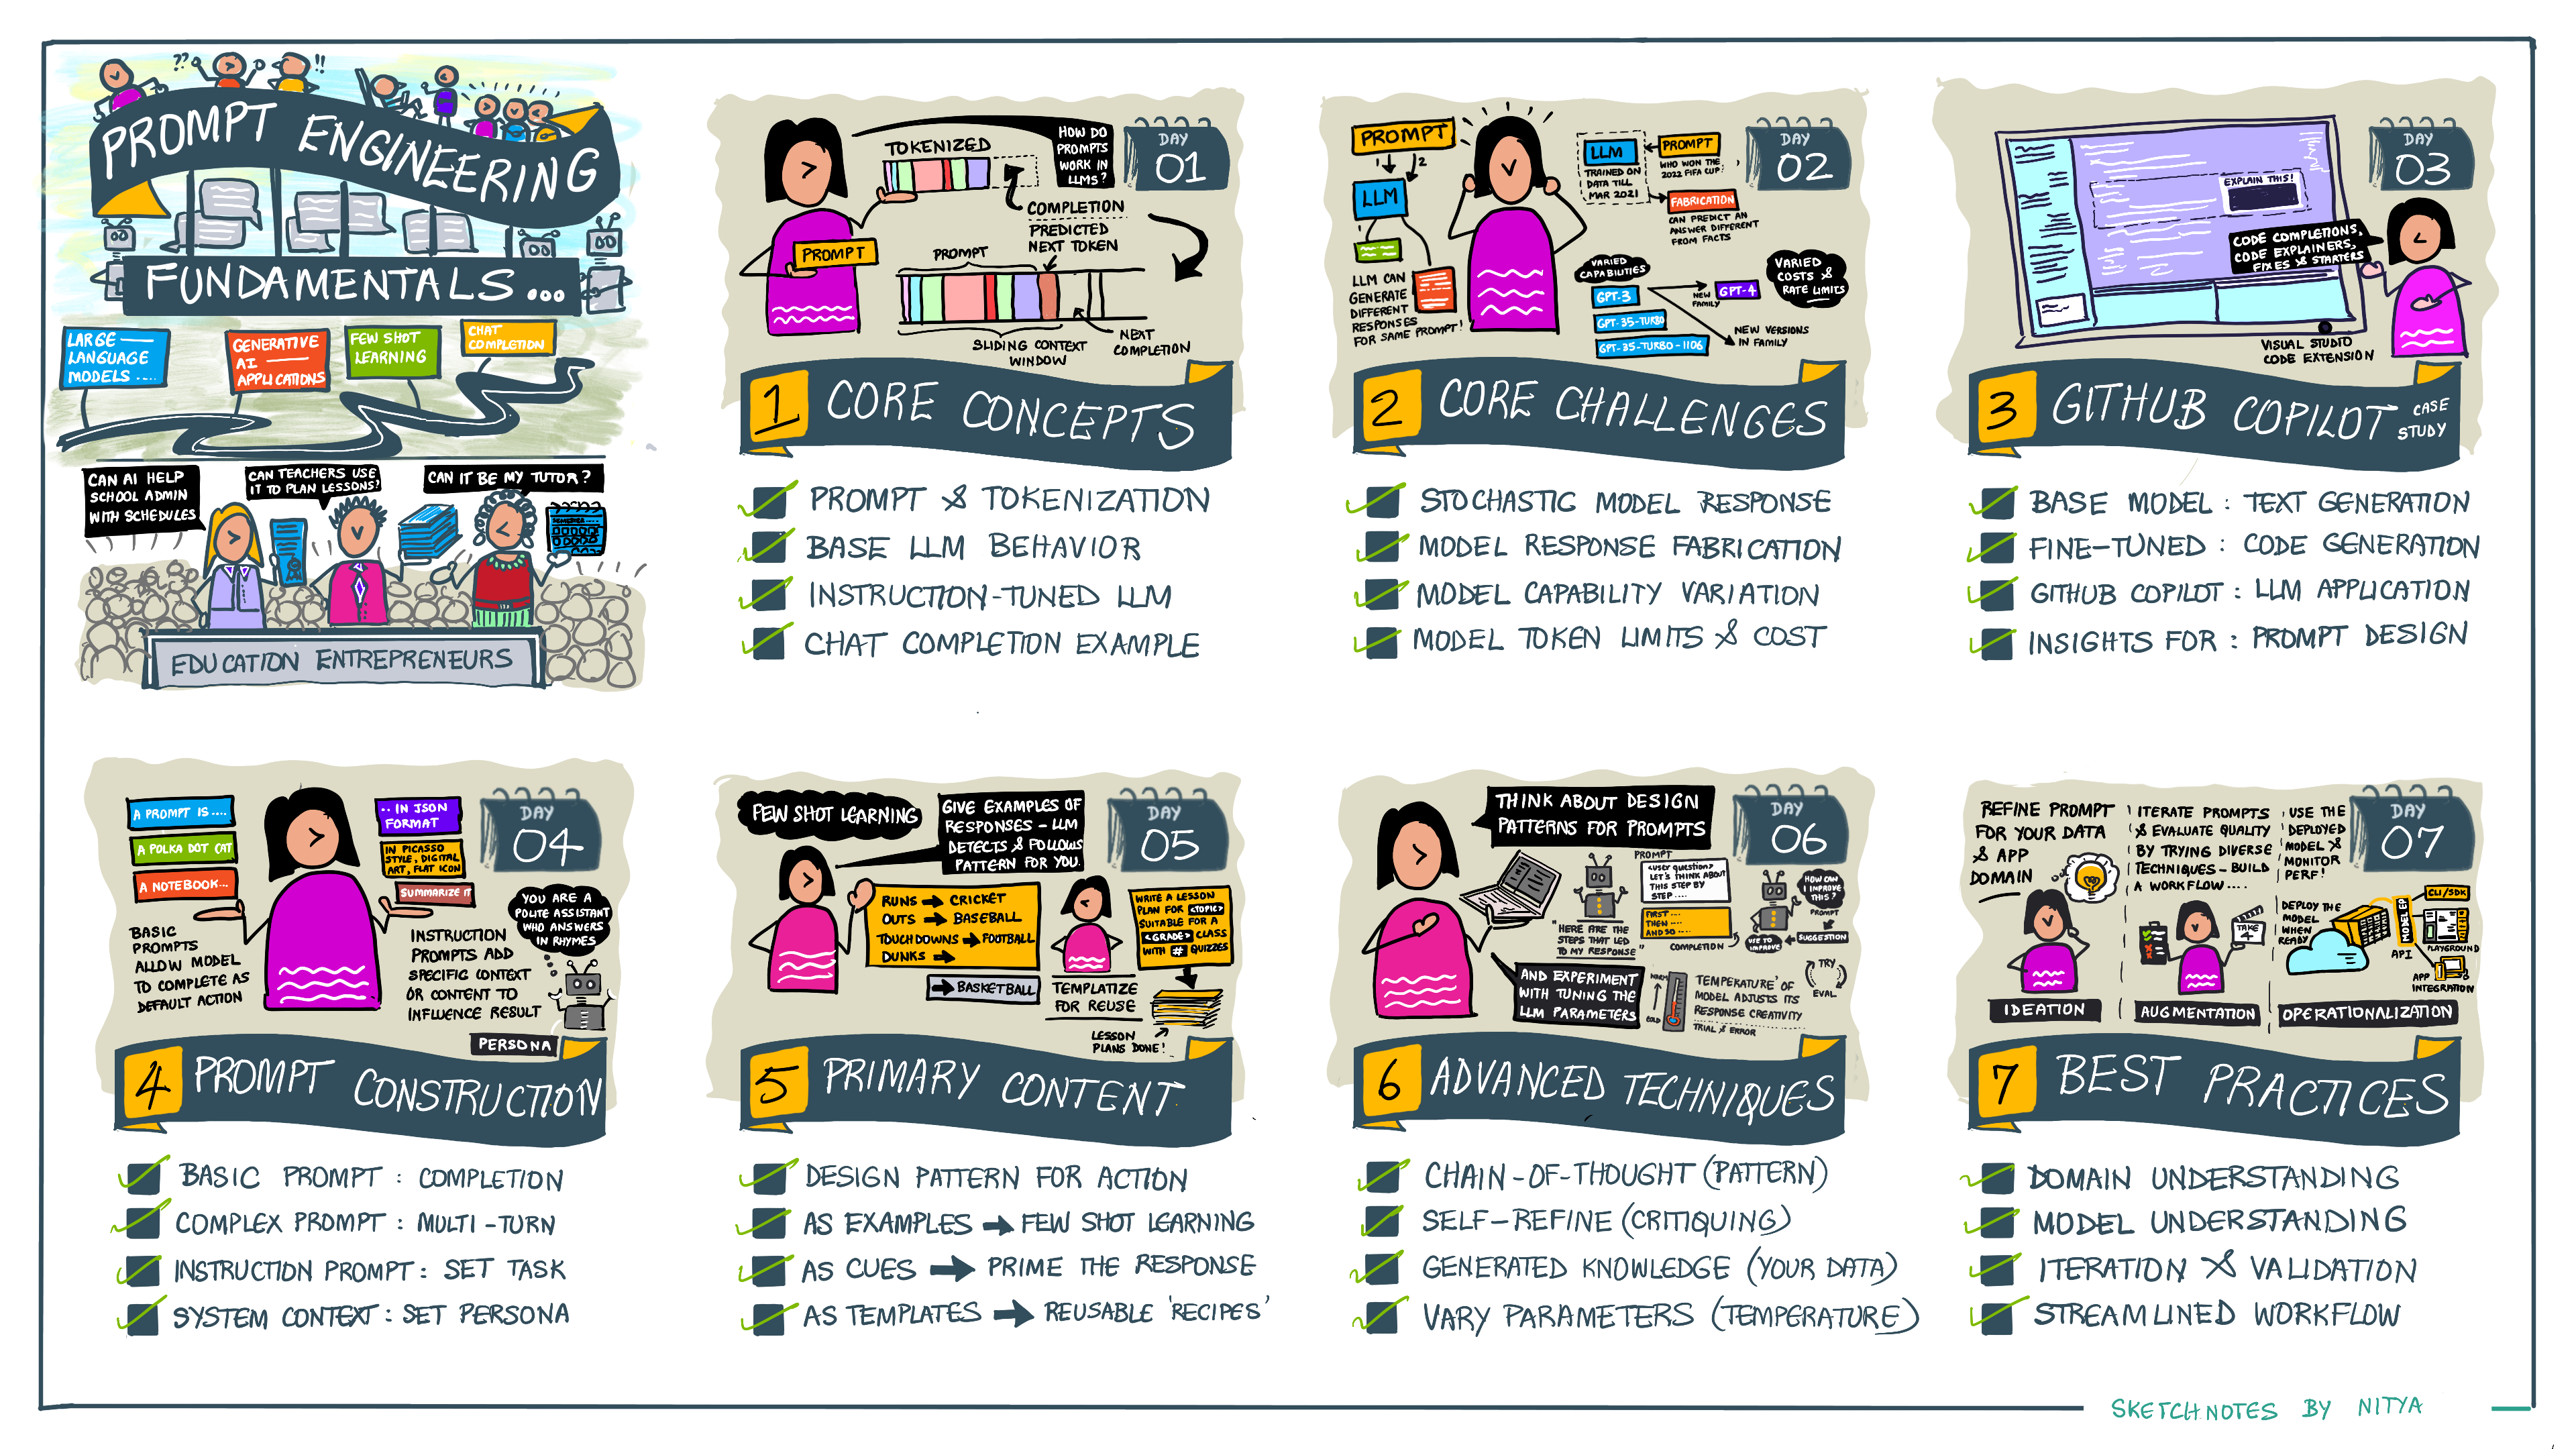
نقشهی تصویری زیر کل مسیر این درس را نشان میدهد؛ از مفاهیم پایه و چالشها تا ساختار پرامپت و بهترین روشها.
مدل زبانی پرامپت را چطور میبیند؟
برای اینکه بفهمیم چرا نوع نوشتن پرامپت اینقدر مهم است، باید سه مفهوم پایه را بشناسیم. این سه مفهوم نشان میدهند مدل متن را چطور میبیند، چطور پردازش میکند و چطور «دستور» را از «سؤال» تشخیص میدهد.
توکنسازی؛ اولین قدم در آموزش پرامپت نویسی
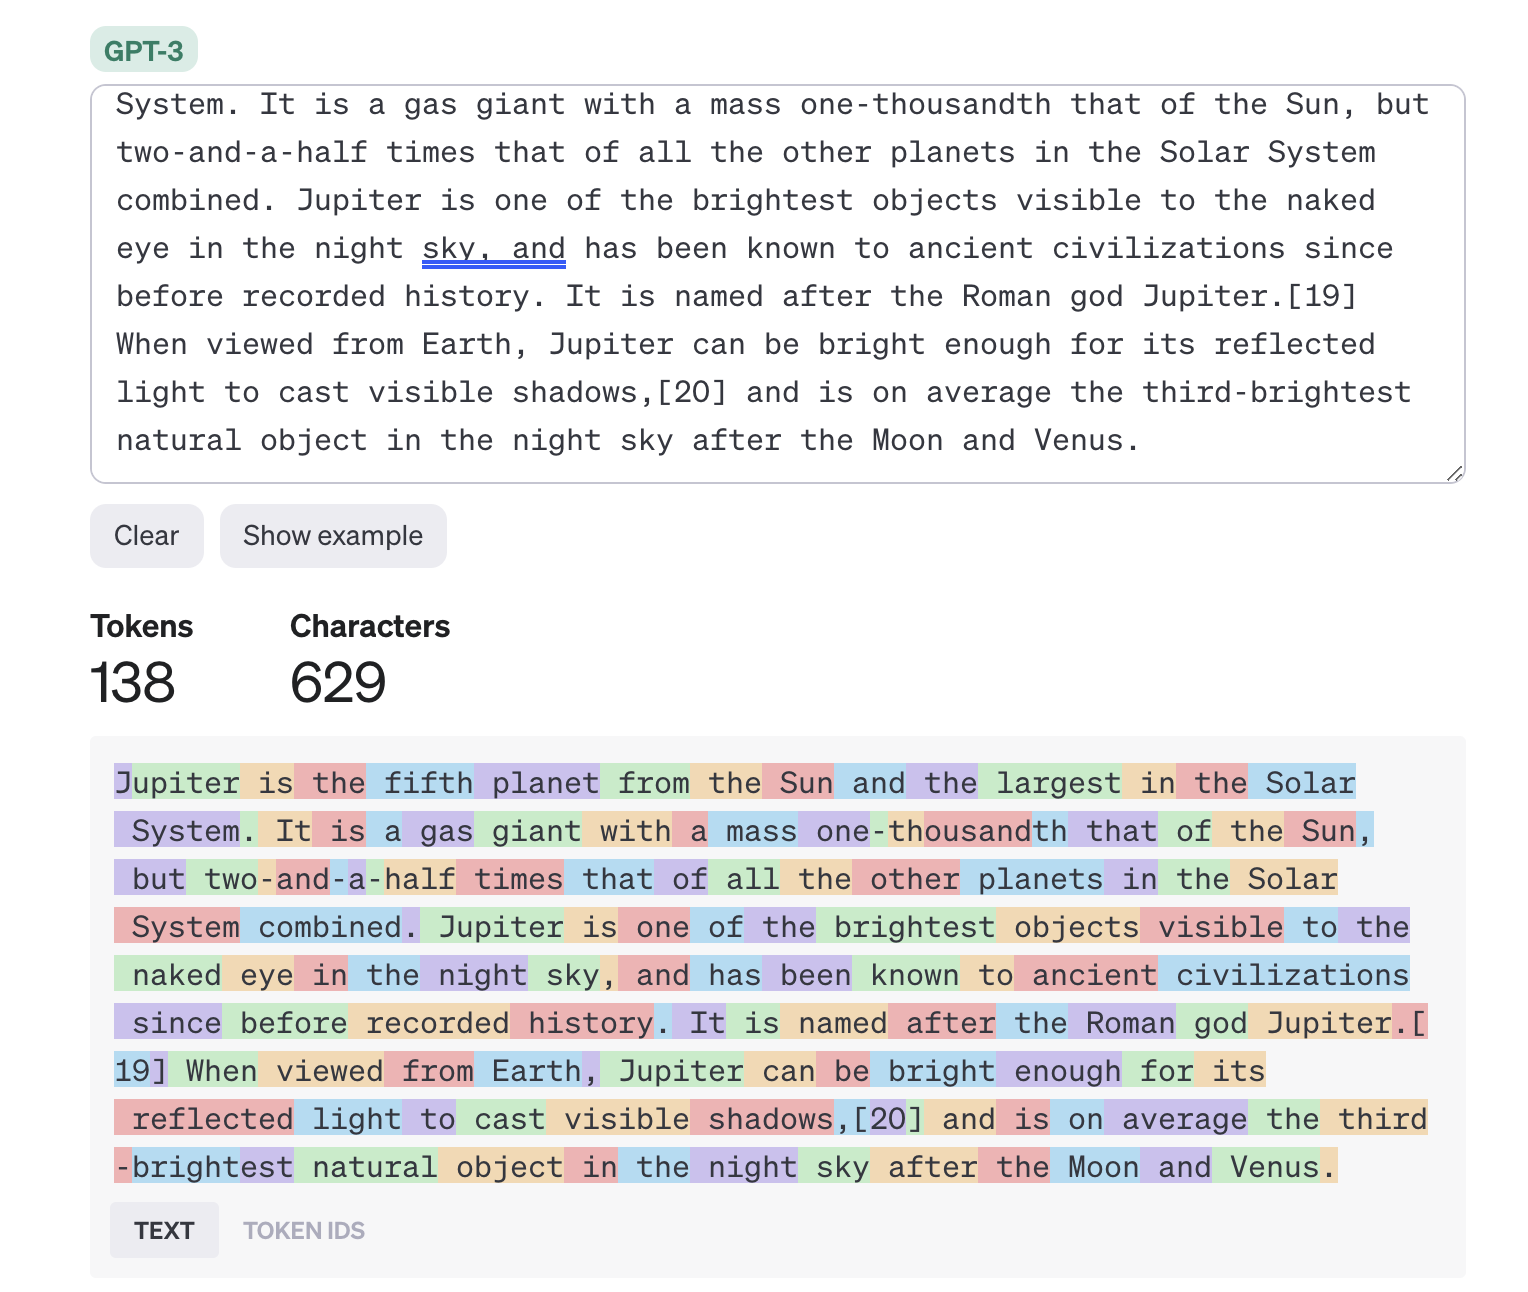
مدل زبانی متن شما را مستقیم نمیخواند. اول آن را به قطعههای کوچکی به نام «توکن» تقسیم میکند. یک توکن میتواند یک کلمه، بخشی از کلمه یا حتی یک علامت نگارشی باشد. مدل روی توکنها آموزش دیده است، نه روی متن خام.
نکتهی مهم اینجاست که مدلهای مختلف یک جمله را به شکلهای متفاوتی توکن میکنند. فاصلهها، علامتها و حتی زبان متن روی تعداد توکنها اثر دارد. متن فارسی معمولاً توکنهای بیشتری از معادل انگلیسیاش مصرف میکند. این موضوع هم روی هزینه اثر میگذارد و هم روی طول متنی که مدل همزمان میتواند ببیند.
برای دیدن این فرایند میتوانید متن خود را در ابزار Tokenizer شرکت OpenAI بچسبانید. تصویر زیر نشان میدهد یک جمله چطور به توکنهای رنگی تقسیم میشود.
مدل پایه فقط ادامهی متن را حدس میزند
بعد از توکنسازی، مدل پایه یک کار اصلی دارد: پیشبینی توکن بعدی. این مدل روی حجم عظیمی از متن آموزش دیده و رابطهی آماری میان توکنها را میشناسد. بنابراین میتواند با اطمینان نسبی حدس بزند چه کلمهای باید بیاید.
اما مدل پایه معنای جمله را به شکل انسانی «نمیفهمد». فقط الگویی میبیند و آن را کامل میکند. اگر ابتدای یک شعر معروف را بنویسید، احتمالاً ادامهی شعر را تحویل میگیرید، نه تحلیل آن را. این رفتار برای کارهای دقیق کافی نیست.
مدلهای دستورپذیر چه فرقی دارند؟
مدل دستورپذیر (Instruction-Tuned) همان مدل پایه است که دوباره با نمونههای «دستور و پاسخ» آموزش دیده است. در این مرحله از روشهایی مثل یادگیری تقویتی با بازخورد انسانی (RLHF) استفاده میشود. نتیجه مدلی است که دستور را دنبال میکند و از بازخورد یاد میگیرد.
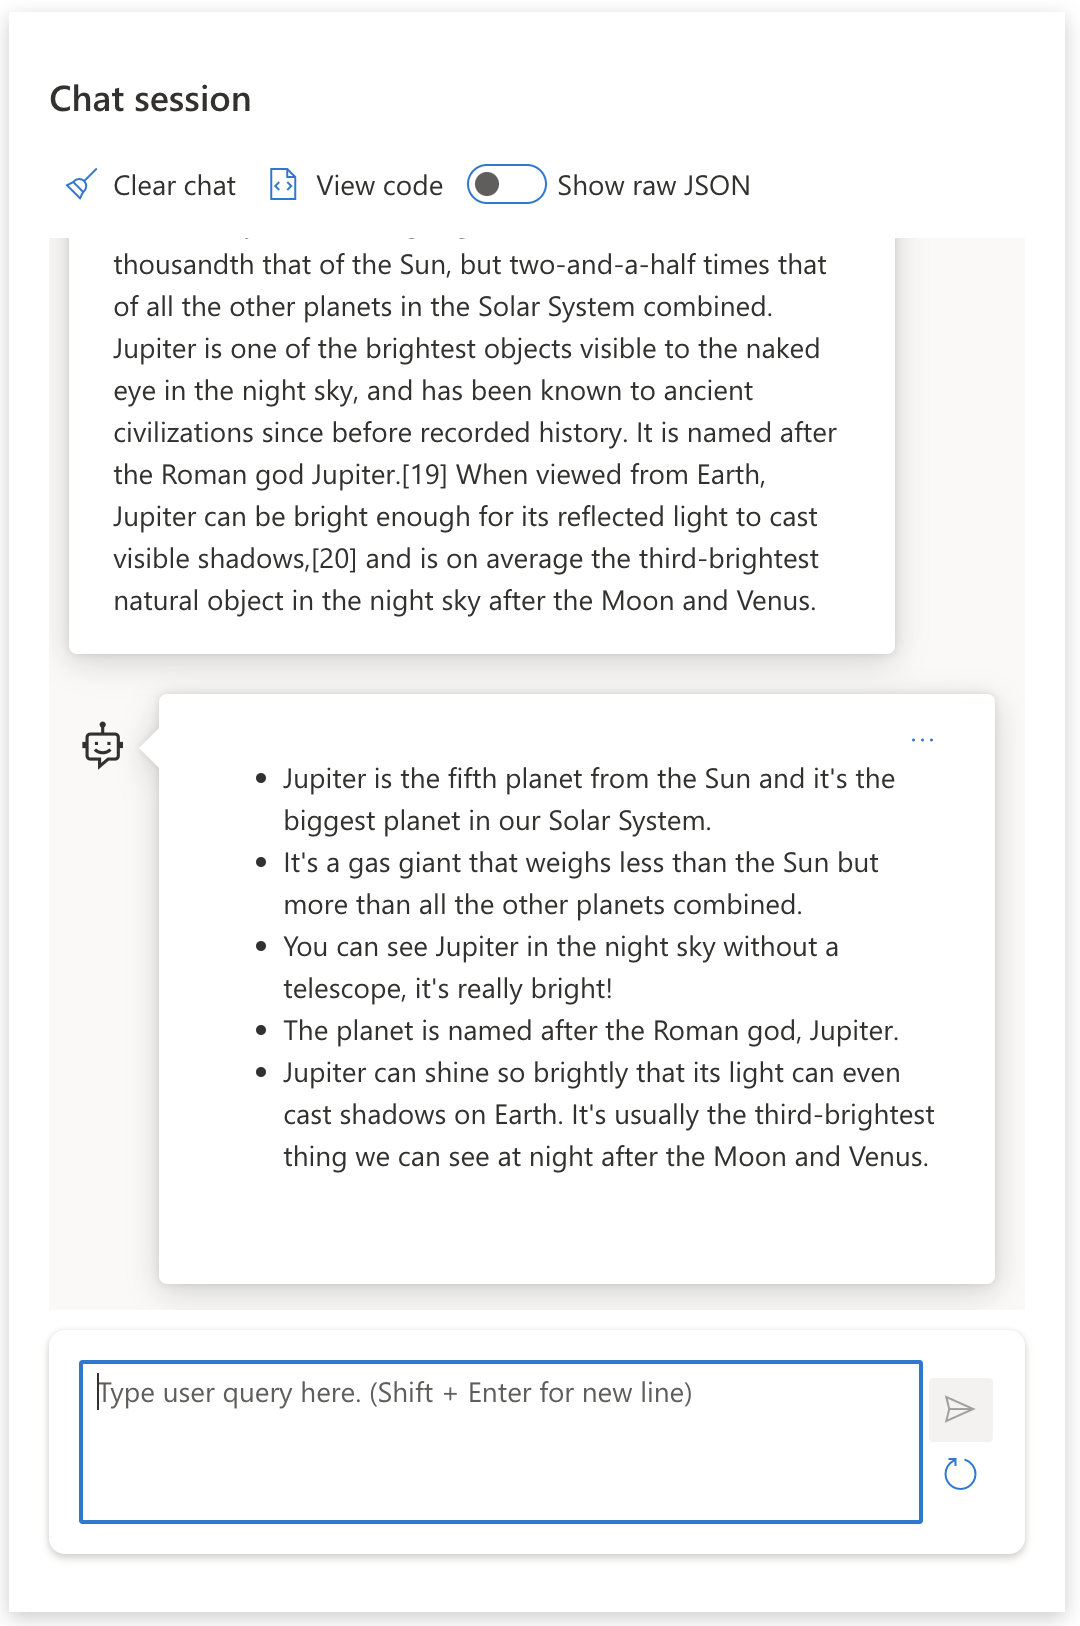
فرض کنید یک متن علمی دربارهی سیارهی مشتری دارید. اگر در پیام سیستمی بنویسید «این متن را برای دانشآموز کلاس دوم در یک پاراگراف و سه تا پنج بولت خلاصه کن»، خروجی دقیقاً با همین قالب برمیگردد. معلم میتواند همان پاسخ را مستقیم در اسلاید کلاس بگذارد.
سه چالش که پرامپت خوب را ضروری میکند
مدلهای امروزی قدرتمندند، اما سه ویژگی دارند که گرفتن پاسخ ثابت را سخت میکند. مهندسی پرامپت دقیقاً برای مدیریت همین ویژگیها به وجود آمده است:
- پاسخها تصادفیاند: یک پرامپت یکسان در مدلهای مختلف، و حتی در یک مدل در زمانهای مختلف، جواب متفاوت میدهد. دستور دقیق این تفاوت را محدود میکند.
- مدل ممکن است جواب بسازد: مدل با دادههای محدود آموزش دیده است. وقتی جواب را نمیداند، ممکن است متنی قانعکننده اما نادرست تولید کند. به این رفتار «ساختن پاسخ» یا توهم میگویند.
- توانایی مدلها یکسان نیست: مدلهای جدیدتر قویترند، اما هزینه و رفتار خاص خودشان را دارند. پرامپت خوب کمک میکند روش کارتان به یک مدل خاص وابسته نماند.
برای آزمایش مورد دوم، درسنامهی مایکروسافت از مدلها خواسته بود برای «جنگ مریخ در سال ۲۰۷۶» طرح درس بنویسند. چنین رویدادی وجود ندارد، اما هر سه مدل آزمایششده طرح درسی کاملاً باورپذیر نوشتند. پس اگر به منبع و راه خروج فکر نکنید، مدل با اطمینان کامل اشتباه میکند.
ساختار پرامپت؛ از ساده تا پیچیده
حالا که میدانیم مدل پرامپت را چطور پردازش میکند، سراغ ساختن آن میرویم. پرامپتها از یک جملهی ساده شروع میشوند و تا یک گفتوگوی چندپیامی با قالب خروجی مشخص پیش میروند.
پرامپت ساده
پرامپت ساده فقط یک متن است، بدون هیچ زمینه یا دستوری. مثلاً چند کلمهی اول یک سرود معروف را میفرستید و مدل بلافاصله ادامهاش را مینویسد. این همان رفتار «پیشبینی ادامه» است که بالاتر دیدیم.
این نوع پرامپت برای پرسشهای عمومی بد نیست. اما کنترل کمی به شما میدهد. مدل خودش تصمیم میگیرد چه بخشی از دانستههایش مرتبط است و خروجی را در چه قالب و طولی بنویسد.
پرامپت چندپیامی با پیام سیستمی
در رابطهای گفتوگومحور، پرامپت مجموعهای از پیامهاست. پیام سیستمی شخصیت و رفتار دستیار را تعیین میکند. پیامهای کاربر و پاسخهای قبلی دستیار هم زمینهی گفتوگو را میسازند. به این ترتیب مدل سؤال بعدی را در بستر همان گفتوگو میفهمد.
در کد زیر، سؤال آخر («کجا برگزار شد؟») بدون پیامهای قبلی معنایی ندارد. مدل با دیدن تاریخچه میفهمد منظور کدام مسابقه است:
response = client.responses.create(
    model="gpt-5-mini",
    input=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Who won the world series in 2020?"},
        {"role": "assistant", "content": "The Los Angeles Dodgers won the World Series in 2020."},
        {"role": "user", "content": "Where was it played?"}
    ]
)
تغییر پیام سیستمی گاهی به اندازهی خود سؤال کاربر روی کیفیت پاسخ اثر دارد. برای همین در پروژههای واقعی، پیام سیستمی را با دقت مینویسند و نسخهبندی میکنند.
پرامپت دستوری
در پرامپت دستوری، کار را با جزئیات کامل مشخص میکنید. هرچه دستور دقیقتر باشد، خروجی قابلپیشبینیتر میشود. جدول زیر سه سطح از یک درخواست دربارهی جنگ داخلی آمریکا را مقایسه میکند.
سطح سوم حتی قالب JSON را هم تعیین کرده است. چنین خروجیای را میتوان مستقیم در یک برنامه استفاده کرد.
| پرامپت | خروجی | نوع دستور |
|---|---|---|
محتوای اصلی؛ مثال، نشانه و قالب
در الگوی «محتوای اصلی»، پرامپت دو بخش دارد: یک دستور و محتوایی که دستور روی آن اجرا میشود. مثلاً یک متن دربارهی مشتری میآورید و در پایانش مینویسید «این را در دو جمله خلاصه کن». از همین محتوا به سه شکل میتوان برای هدایت بهتر مدل استفاده کرد.
یادگیری با مثال (zero-shot و few-shot)
بهجای اینکه فقط بگویید چه کاری انجام شود، چند نمونه از خروجی دلخواه را نشان میدهید. مدل الگو را از روی نمونهها تشخیص میدهد. اگر هیچ نمونهای ندهید zero-shot است، با یک نمونه one-shot و با چند نمونه few-shot.
مثال درسنامه جالب است. چند جملهی ورزشی میآید و جلوی هر کدام نام ورزش: «بازیکن توپ را به سبد کوبید» میشود بسکتبال و «بازیکن شش امتیاز گرفت» میشود کریکت. در انتها فقط یک جملهی تازه بدون جواب میآید. مدل بدون هیچ دستور صریحی میفهمد باید نام ورزش را بنویسد.
در عمل، کار را با zero-shot شروع کنید. اگر خروجی قالب یا لحن درستی نداشت، دو یا سه نمونه اضافه کنید. همین کار ساده اغلب بیشتر از بازنویسی چندبارهی دستور اثر دارد.
نشانه (cue) برای شروع پاسخ
روش دوم دادن «نشانه» است. بهجای نمونه، ابتدای پاسخ را خودتان مینویسید و مدل همان مسیر را ادامه میدهد. مثلاً بعد از متن و دستور «خلاصه کن»، مینویسید «سه نکتهی مهمی که یاد گرفتیم:» و مدل پاسخ را به شکل فهرست سهتایی کامل میکند.
نشانه بهخصوص وقتی مفید است که قالب ثابتی میخواهید، اما نمیخواهید پرامپت با نمونههای طولانی سنگین شود. نتیجهی همین روش در تصویر زیر دیده میشود؛ پیام سیستمی و نشانه، خلاصه را به فهرست کوتاه و ساده تبدیل کردهاند.
قالب پرامپت برای استفادهی دوباره
قالب پرامپت یک «دستور پخت» آماده است که جای خالی دارد. مثلاً «برای [مخاطب] دربارهی [موضوع] یک طرح درس [تعداد] جلسهای بنویس». هر بار فقط متغیرها را عوض میکنید و بقیهی ساختار ثابت میماند.
ارزش واقعی قالبها در ساختن «کتابخانهی پرامپت» برای یک حوزهی مشخص است. مخزن Prompts for Edu مایکروسافت نمونهی خوبی است که پرامپتهای آموزشی مثل طراحی درس و تدریس خصوصی را یکجا جمع کرده است. ابزارهایی مثل LangChain هم امکان پرکردن خودکار این جای خالیها را از دادههای مختلف فراهم میکنند.
محتوای پشتیبان؛ زمینهای که خروجی را جهت میدهد
اگر دستور را «کار» و محتوای اصلی را «هدف» بدانیم، محتوای پشتیبان زمینهای است که شکل خروجی را تنظیم میکند. این زمینه میتواند دستهبندی موضوعی، قواعد قالببندی یا فهرست اولویتها باشد.
فرض کنید فهرست کامل دورههای یک آموزشگاه را دارید. دستور میدهید «فهرست دورههای پاییز را خلاصه کن». با محتوای اصلی چند نمونه خلاصه نشان میدهید. با محتوای پشتیبان هم پنج برچسب مهم را مشخص میکنید. حالا مدل خلاصه را در قالب نمونهها مینویسد و هنگام انتخاب، آن پنج برچسب را در اولویت قرار میدهد.
بهترین روشهای پرامپت نویسی
پرامپت نویسی بیشتر به تجربه و آزمونوخطا شبیه است تا یک فرمول ثابت. با این حال، هشت روش زیر در بیشتر پروژهها جواب دادهاند:
- مدلهای جدید را ارزیابی کنید: نسلهای تازه معمولاً کیفیت بهتری دارند، اما هزینهشان هم ممکن است بیشتر باشد. قبل از مهاجرت، اثرشان را بسنجید.
- دستور و زمینه را جدا کنید: با جداکنندههایی مثل سه خط تیره یا تگ، مرز دستور و محتوا را مشخص کنید تا مدل وزن هر بخش را درست تشخیص دهد.
- دقیق و روشن بنویسید: زمینه، نتیجهی مورد انتظار، طول، قالب و لحن را بگویید.
- مثال بزنید: اول zero-shot را امتحان کنید و اگر لازم شد چند نمونه اضافه کنید.
- با نشانه شروع کنید: چند کلمهی اول پاسخ را بنویسید تا مدل مسیر را پیدا کند.
- تأکید را تکرار کنید: گاهی لازم است دستور را قبل و بعد از محتوا تکرار کنید.
- به ترتیب اطلاعات دقت کنید: جای قرارگرفتن اطلاعات در پرامپت روی خروجی اثر دارد؛ ترتیبهای مختلف را امتحان کنید.
- یک راه خروج بدهید: بگویید اگر جواب را نمیداند چه بنویسد. این کار احتمال پاسخ ساختگی را کم میکند.
این روشها نقطهی شروعاند، نه قانون قطعی. نتیجه به مدل، نوع کار و حوزهی شما بستگی دارد. پس هر روش را روی دادهی واقعی خودتان آزمایش کنید و نتیجهها را یادداشت کنید تا کمکم کتابخانهی پرامپت خودتان را بسازید.
تمرین عملی؛ دستیار پاسخگوی دورههای آموزشی
پروژهی مشترک این مجموعه دستیاری است که به کاربران در انتخاب دوره و پیدا کردن محتوای آموزشی کمک میکند. در این قسمت فقط پرامپت پایهی آن را میسازیم:
- یک درخواست مبهم بنویسید؛ مثلاً «یک دورهی خوب پیشنهاد بده».
- مخاطب، اطلاعات مرجع (فهرست چند دوره) و قالب پاسخ را به آن اضافه کنید.
- هر دو نسخه را روی پنج سؤال یکسان اجرا کنید و پاسخها را کنار هم بگذارید.
خروجی این تمرین یک قالب پرامپت قابلاستفادهی دوباره است، همراه با پنج نمونه پاسخ. در قسمتهای بعدی همین قالب را کاملتر میکنیم و در نهایت آن را به یک دستیار واقعی تبدیل میکنیم.
سخن پایانی
آموزش پرامپت نویسی با یک نکتهی ساده شروع میشود: مدل ذهن شما را نمیخواند، فقط متن شما را میخواند. وقتی بدانید مدل متن را توکن میکند، ادامه را پیشبینی میکند و به دستور واکنش نشان میدهد، راحتتر میفهمید چرا یک پرامپت کار میکند و دیگری نه. از امروز هر درخواست را با چهار سؤال بسنجید: کار چیست، زمینه کدام است، خروجی چه شکلی دارد و اگر مدل جواب را نداند چه کند؟
در قسمت دوم این مجموعه سراغ تکنیکهای پیشرفتهتر میرویم؛ از زنجیرهی فکر تا بازبینی پاسخ توسط خود مدل.
این آموزش بر پایهی درس Prompt Engineering Fundamentals از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است. تصاویر متعلق به همان منبعاند.
پرسشهای پرتکرار
پرامپت نویسی دقیقاً چیست؟
پرامپت نویسی یعنی طراحی متنی که به مدل هوش مصنوعی میدهید تا کار مشخصی را انجام دهد. مهندسی پرامپت یک قدم جلوتر است و شامل آزمودن و بهبود همان متن تا رسیدن به پاسخ ثابت و باکیفیت میشود.
برای یادگیری پرامپت نویسی باید برنامهنویسی بلد باشم؟
نه. اصول پرامپت نویسی را میتوانید در همان پنجرهی چت یاد بگیرید. برنامهنویسی فقط وقتی لازم میشود که بخواهید پرامپت را داخل یک برنامه و از طریق API به کار ببرید.
فرق zero-shot و few-shot چیست؟
در zero-shot فقط دستور میدهید و هیچ نمونهای نمیآورید. در few-shot چند نمونه از خروجی دلخواه را هم در پرامپت میگذارید تا مدل الگو را خودش تشخیص دهد و دقیقتر پاسخ دهد.
چرا یک پرامپت ثابت هر بار جواب متفاوتی میدهد؟
مدلهای زبانی ذاتاً احتمالاتی هستند و کلمهی بعدی را با احتمال انتخاب میکنند. دستور دقیق، قالب خروجی مشخص و تنظیم پارامترهایی مثل temperature این تفاوتها را کم میکند.
چطور جلوی جواب ساختگی هوش مصنوعی را بگیرم؟
منبع یا متن مرجع را در پرامپت بگذارید، از مدل بخواهید فقط بر اساس همان متن پاسخ دهد و یک راه خروج هم تعریف کنید؛ مثلاً اگر جواب را نمیدانی، بنویس «اطلاعات کافی ندارم».
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.