
ارزیابی ایجنت هوش مصنوعی مرحلهای است که بیشتر پروژهها از آن جا میمانند. ایجنت در نمایش اول عالی کار میکند، اما در محیط واقعی گاهی کند است، گاهی پرهزینه و گاهی پاسخ اشتباه میدهد. بدون سنجش دقیق، حتی نمیدانید این مشکلات چقدر رایجاند. شما از کجا میفهمید ایجنتتان هفتهی گذشته چند بار اشتباه جواب داده است؟
در این قسمت از مجموعهی «از پرامپت تا دستیار هوش مصنوعی» یاد میگیریم ایجنت را از یک «جعبهی سیاه» به سیستمی شفاف و قابلسنجش تبدیل کنیم. اول مشاهدهپذیری را میبینیم و بعد دو روش اصلی ارزیابی، یعنی آفلاین و آنلاین، را مرور میکنیم.
مشاهدهپذیری در ایجنت هوش مصنوعی
مشاهدهپذیری (Observability) یعنی بفهمید درون ایجنت چه میگذرد؛ از روی نشانههای بیرونی مثل لاگ، معیار و ردپای اجرا. برای ایجنتها یعنی ثبت اقدامها، استفاده از ابزارها، فراخوانیهای مدل و پاسخها تا بتوانید خطا را پیدا کنید و عملکرد را بهتر کنید.
چرا بدون مشاهدهپذیری کور هستیم؟
بدون مشاهدهپذیری، ایجنت یک جعبهی سیاه است. سؤالی وارد میشود و جوابی بیرون میآید، اما نمیدانید در این میان چه اتفاقی افتاد. مشاهدهپذیری کار همان «جعبهی سیاه» هواپیما را میکند. تفاوتش این است که هر روز خوانده میشود، نه فقط بعد از حادثه. ابزارهای مشاهدهپذیری ایجنت را شفاف میکنند و به شما اجازه میدهند:
- هزینه و دقت را بسنجید: بفهمید بین این دو چه تعادلی برقرار است.
- زمان پاسخ را اندازه بگیرید: بدانید کدام قدم کار را کند میکند.
- محتوای مضر را شناسایی کنید: زبان توهینآمیز و تزریق پرامپت را تشخیص دهید.
- بازخورد کاربران را پایش کنید: بدانید کاربران از کدام پاسخها راضی نیستند.
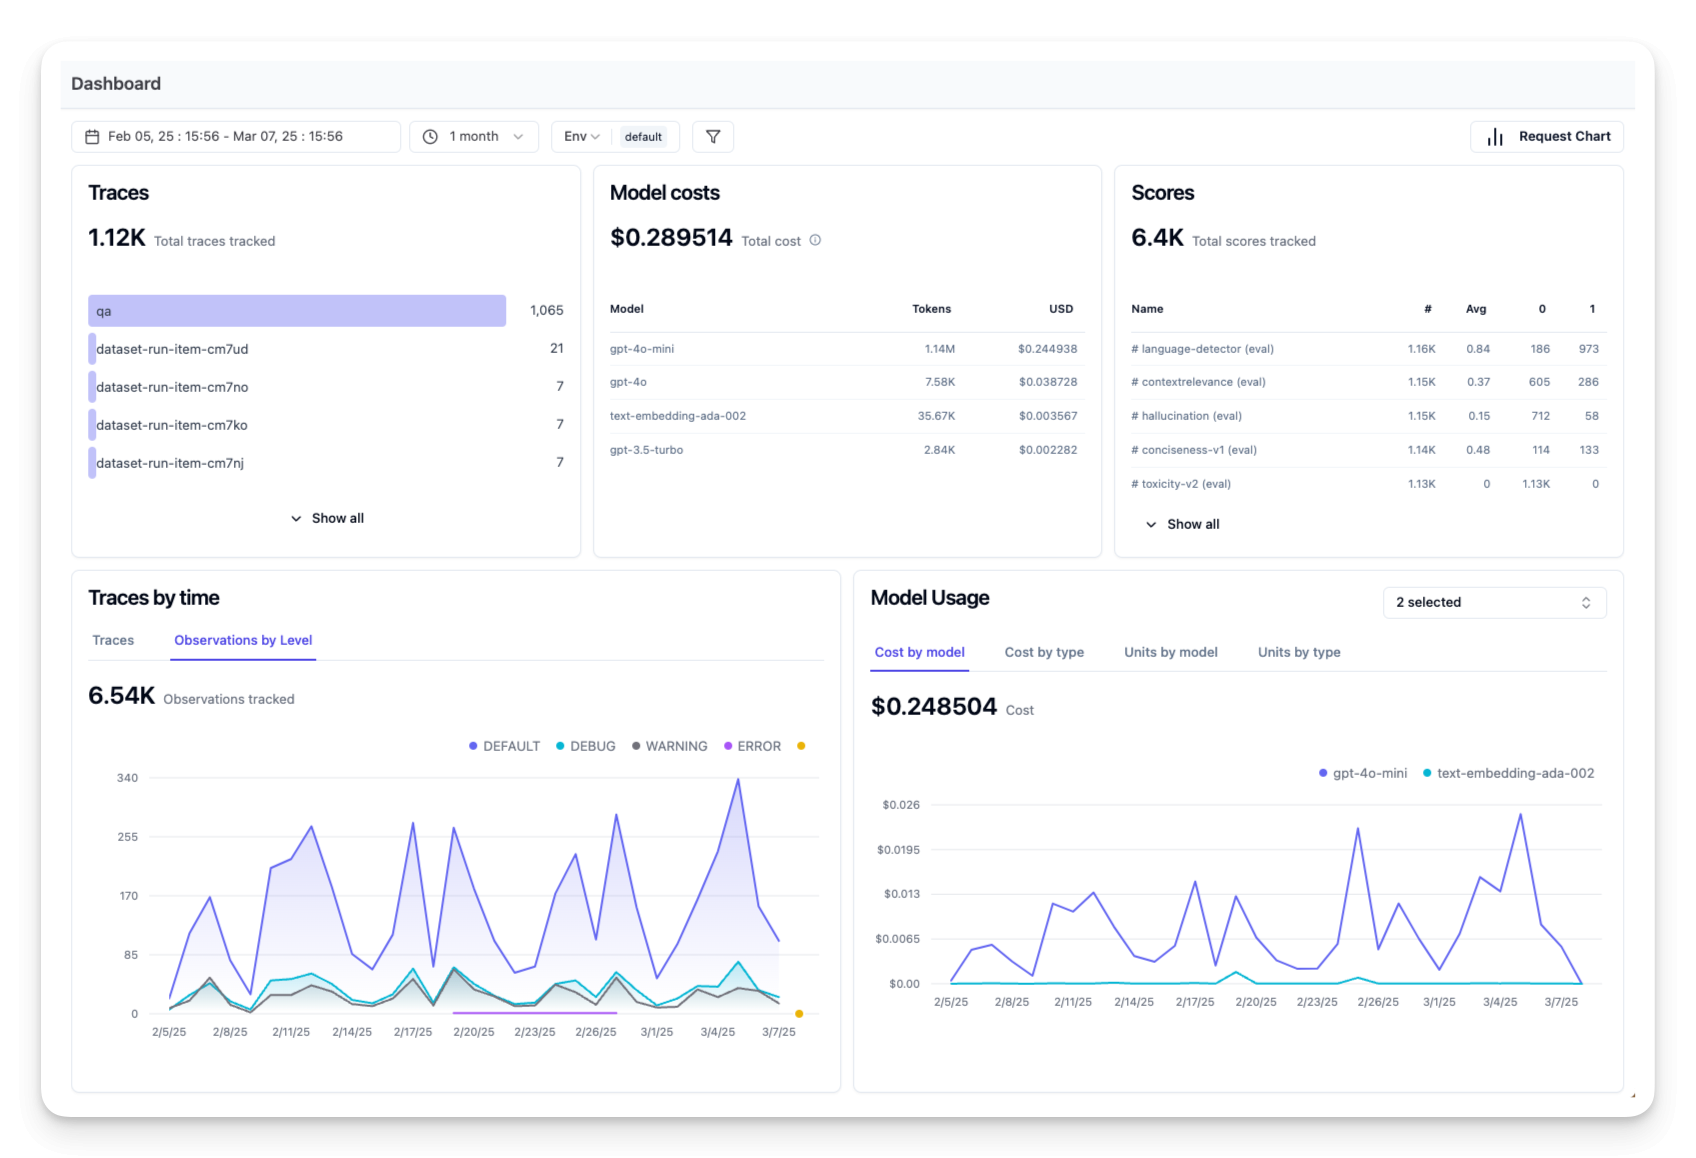
به زبان ساده، مشاهدهپذیری ایجنت نمایشی شما را آمادهی محیط تولید میکند. داشبورد زیر نمونهای از این شفافیت است؛ تعداد Traceها، هزینهی هر مدل و امتیازهای ارزیابی در یک نگاه.
ابزارهای مشاهدهپذیری
ابزارهای رایج این حوزه پلتفرمهایی مثل Langfuse و Arize هستند. این ابزارها ردپای کامل اجرا را جمع میکنند و داشبوردهای لحظهای برای پایش معیارها دارند. برخی متنبازند و برخی روی بخشی از چرخهی LLMOps، مثل ارزیابی یا مدیریت پرامپت، تمرکز دارند.
بسیاری از فریمورکها، از جمله smolagents، از استاندارد OpenTelemetry برای ارسال اطلاعات به این ابزارها استفاده میکنند. OpenTelemetry یک زبان مشترک برای گزارشدادن است. مثل قالب یکسان فاکتور: هر فروشگاهی بفرستد، حسابدار میتواند بخواندش. در قسمت سیزدهم دیدیم فعالکردن آن در smolagents فقط یک خط کد است.
بیشتر بخوانید: راهاندازی SmolagentsInstrumentor و اتصال smolagents به Langfuse را در CodeAgent چیست؟ قدمبهقدم توضیح دادهایم.
Trace و Span؛ ساختار ردپای اجرا
ابزارهای مشاهدهپذیری اجرای ایجنت را با دو مفهوم نشان میدهند. Trace کل یک کار ایجنت را از شروع تا پایان نشان میدهد؛ مثلاً پاسخ به یک پرسش کاربر. Span هر قدم جداگانه درون این Trace است؛ مثل یک فراخوانی مدل یا بازیابی داده.
Trace را مثل رسید کامل خرید از یک فروشگاه تصور کنید. Span هر ردیف آن رسید است؛ با نام کالا، قیمت و زمان. اگر جمع رسید عجیب است، ردیفها را نگاه میکنید تا مقصر را پیدا کنید.
خواندن یک Trace
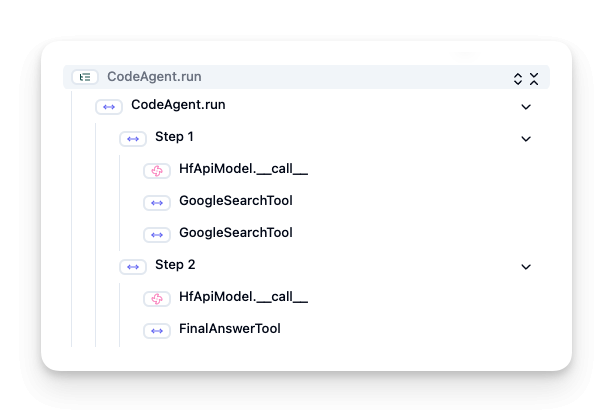
یک Trace نمونه از CodeAgent را در نظر بگیرید. در قدم اول، مدل فراخوانی میشود و دو بار ابزار جستجوی گوگل را صدا میزند. در قدم دوم، مدل دوباره فراخوانی میشود و ابزار پاسخ نهایی را اجرا میکند.
در واقع، هر کدام از اینها یک Span است که زمان اجرا، ورودی، خروجی و هزینهی خودش را دارد. وقتی ایجنت کند است، با نگاه به Spanها دقیقاً میفهمید کدام قدم مقصر است. ساختار این Trace را در تصویر زیر میبینید.
هفت معیار کلیدی برای ارزیابی ایجنت هوش مصنوعی
ابزارهای مشاهدهپذیری معیارهای مختلفی را پایش میکنند. در عمل، ترکیب این معیارها بهترین تصویر را از سلامت ایجنت میدهد. جدول زیر هفت معیار اصلی را همراه نمونهی اقدام اصلاحی نشان میدهد.
| معیار | چه چیزی را میسنجد | نمونهی اقدام اصلاحی |
|---|---|---|
| زمان پاسخ | سرعت پاسخ کل کار و هر قدم | مدل سریعتر یا فراخوانی موازی |
| هزینه | هزینهی هر اجرای ایجنت | کاهش فراخوانیها یا مدل ارزانتر |
| خطای درخواست | تعداد درخواستهای شکستخورده | تلاش دوباره یا ارائهدهندهی جایگزین |
| بازخورد صریح | امتیاز و نظر مستقیم کاربر | بررسی پاسخهای با امتیاز منفی |
| بازخورد ضمنی | رفتار کاربر مثل تکرار سؤال | یافتن پرسشهایی که ایجنت نمیفهمد |
| دقت | میزان خروجی درست یا مطلوب | برچسب موفق یا ناموفق روی Traceها |
| ارزیابی خودکار | امتیاز داور خودکار به پاسخ | داوری با مدل زبانی، RAGAS یا LLM Guard |
زمان پاسخ و هزینه
انتظار طولانی تجربهی کاربر را خراب میکند. اگر ایجنتی برای همهی فراخوانیهای مدلش بیست ثانیه وقت بگذارد، میتوانید با مدل سریعتر یا اجرای موازی فراخوانیها سرعتش را بالا ببرید. زمان را هم برای کل کار و هم برای هر قدم بسنجید.
از طرف دیگر، هزینه مستقیم به تعداد فراخوانیها بستگی دارد. اگر ایجنت پنج بار مدل را صدا میزند و کیفیت فقط کمی بهتر میشود، باید بسنجید این هزینه ارزشش را دارد یا نه. پایش لحظهای جهشهای ناگهانی هزینه را هم نشان میدهد؛ مثلاً باگی که ایجنت را در حلقهی بیپایان فراخوانی API انداخته است.
بازخورد صریح و ضمنی کاربر
بازخورد صریح یعنی امتیازی که کاربر مستقیم میدهد؛ دکمهی موافق و مخالف، ستاره یا نظر متنی. بازخورد منفی پیوسته زنگ خطری است که ایجنت درست کار نمیکند.
در مقابل، نوع ضمنی از رفتار کاربر میآید، حتی بدون امتیاز. کاربری که بلافاصله سؤالش را بازنویسی میکند، پرسش را تکرار میکند یا دکمهی «دوباره» را میزند، دارد میگوید پاسخ خوب نبود. این نشانهها اغلب از بازخورد صریح فراوانترند.
دقت و داوری خودکار
دقت یعنی ایجنت چند بار خروجی درست یا مطلوب تولید میکند. تعریف «درست» به کار شما بستگی دارد. قدم اول این است که مشخص کنید موفقیت برای ایجنتتان چه شکلی دارد. بعد Traceها را با برچسب «موفق» یا «ناموفق» علامت بزنید.
علاوه بر این، ارزیابی خودکار هم امکانپذیر است. میتوانید از یک مدل زبانی بخواهید پاسخ ایجنت را از نظر مفید بودن و درستی امتیاز دهد. کتابخانههای متنبازی هم وجود دارند؛ RAGAS برای ایجنتهای RAG و LLM Guard برای تشخیص محتوای مضر و تزریق پرامپت.
ارزیابی آفلاین و آنلاین
مشاهدهپذیری معیار میدهد. ارزیابی یعنی تحلیل همین دادهها و انجام آزمون برای اینکه بفهمید ایجنت چقدر خوب کار میکند و چطور میشود بهترش کرد. ارزیابی منظم ضروری است، چون ایجنتها غیرقطعیاند و با بهروزرسانی مدلها رفتارشان تغییر میکند.
ارزیابی آفلاین با مجموعهی آزمون
ارزیابی آفلاین مثل آزمون آزمایشی پیش از کنکور است و ارزیابی آنلاین مثل خود کنکور. اولی تکرارپذیر و امن است؛ دومی واقعی و پیشبینیناپذیر. ارزیابی آفلاین در محیطی کنترلشده و با مجموعهی آزمون انجام میشود، نه با پرسشهای واقعی کاربران. دادههایی دارید که پاسخ درستشان را میدانید و ایجنت را روی آنها اجرا میکنید. مثلاً برای ایجنت حل مسئلهی ریاضی، صد مسئله با پاسخ مشخص.
مزیت اصلی این روش تکرارپذیری است. چون پاسخ درست را دارید، معیار دقت روشنی به دست میآورید. میتوانید آن را بخشی از فرایند CI/CD کنید تا هر تغییری که کیفیت را پایین بیاورد، پیش از انتشار شناسایی شود. یک ارزیاب آفلاین ساده در پایتون چنین است:
import time
test_set = [ # نمونه فرضی؛ پرسش و پاسخ درست
{"question": "دورهی پایتون مبتدی با ظرفیت خالی کدام است؟", "answer": "python-101"},
{"question": "دورهی SQL برای تحلیل داده؟", "answer": "sql-basics"},
]
def evaluate(agent, test_set):
correct, durations = 0, []
for case in test_set:
start = time.perf_counter()
reply = agent.run(case["question"])
durations.append(time.perf_counter() - start)
correct += case["answer"] in str(reply)
print(f"دقت: {correct}/{len(test_set)} · میانگین زمان: {sum(durations) / len(durations):.1f} ثانیه")agent.run همان متدی است که ایجنتهای smolagents دارند. بررسی «پاسخ درست در متن آمده؟» سادهترین داور است؛ برای پاسخهای آزاد میتوانید آن را با داوری مدل زبانی عوض کنید.
با این حال، چالش اصلی این است که مجموعهی آزمون جامع و بهروز بماند. ایجنت ممکن است روی آزمون ثابت عالی باشد، اما در محیط واقعی با پرسشهای کاملاً متفاوتی روبهرو شود. ترکیبی از آزمونهای کوچک برای بررسی سریع و مجموعههای بزرگتر برای سنجش گسترده بهترین نتیجه را میدهد.
ارزیابی آنلاین روی کاربران واقعی
ارزیابی آنلاین در محیط واقعی و هنگام استفادهی کاربران انجام میشود. عملکرد ایجنت روی تعاملهای واقعی بهطور مداوم پایش میشود؛ مثلاً نرخ موفقیت، رضایت کاربر و معیارهای دیگر روی ترافیک زنده.
مزیت این روش این است که چیزهایی را نشان میدهد که در آزمایشگاه پیشبینی نکرده بودید. میتوانید افت تدریجی کیفیت را ببینید و پرسشهای تازهای را پیدا کنید که در دادهی آزمون نبودند. آزمون A/B هم در این دسته قرار میگیرد؛ نسخهی جدید ایجنت کنار نسخهی قدیم اجرا میشود تا مقایسه شوند.
چرخهی بهبود مداوم
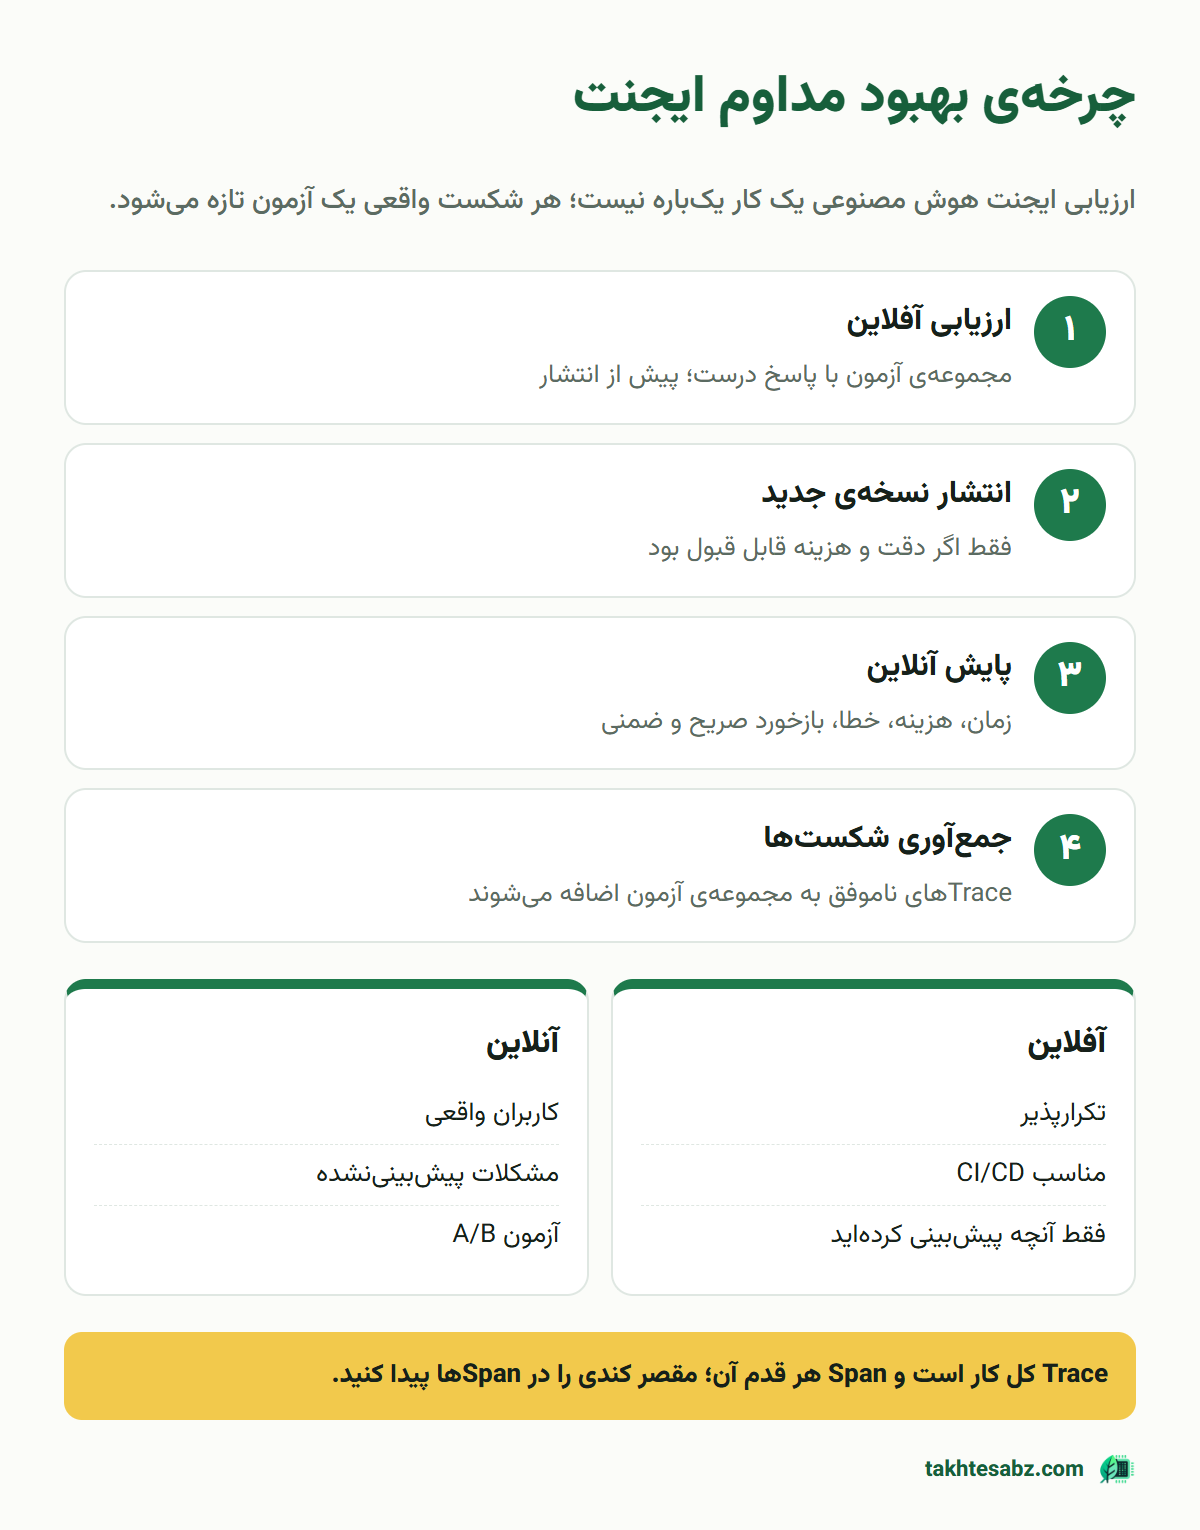
در عمل، ارزیابی موفق هر دو روش را ترکیب میکند. بسیاری از تیمها یک چرخه را دنبال میکنند. اول ارزیابی آفلاین، بعد انتشار نسخهی جدید، سپس پایش معیارهای آنلاین و جمعآوری نمونههای شکست. این نمونهها به مجموعهی آزمون آفلاین اضافه میشوند و چرخه دوباره تکرار میشود.
به این ترتیب ارزیابی یک کار یکباره نیست؛ فرایندی پیوسته است که هر بار ایجنت را کمی بهتر میکند. هر شکست واقعی، به یک آزمون تازه تبدیل میشود تا دیگر تکرار نشود.
تمرین عملی؛ ارزیابی دستیار دورهها
برای دستیار پروژهی مشترک یک ارزیابی ساده راه بیندازید:
- ده پرسش واقعی بنویسید و برای هر کدام پاسخ درست، یعنی دورهی مناسب، را مشخص کنید.
- ایجنت را روی این ده پرسش اجرا کنید و درصد پاسخ درست، میانگین زمان و هزینهی کل را ثبت کنید.
- SmolagentsInstrumentor را فعال کنید و Trace کندترین اجرا را در Langfuse بررسی کنید.
هر پرسشی که ایجنت اشتباه جواب داد، بعد از اصلاح در مجموعهی آزمون بماند. این همان چرخهی بهبود مداوم است؛ در مقیاس کوچک.
سخن پایانی
ارزیابی ایجنت هوش مصنوعی با مشاهدهپذیری شروع میشود: Trace و Spanهایی که نشان میدهند درون ایجنت چه میگذرد. بعد معیارهایی مثل زمان، هزینه، خطا، بازخورد و دقت، سلامت ایجنت را عددی میکنند. ارزیابی آفلاین پیش از انتشار جلوی خطاهای شناختهشده را میگیرد و ارزیابی آنلاین مشکلات تازه را پیدا میکند. ترکیب این دو در یک چرخهی پیوسته، ایجنت نمایشی را به محصولی قابلاعتماد تبدیل میکند.
در قسمت بیستم، که بخش نخست این مجموعه را میبندد، سراغ امنیت برنامههای هوش مصنوعی مولد میرویم.
این آموزش بر پایهی بخش AI Agent Observability and Evaluation از دورهی آزاد Agents Course در Hugging Face (مجوز Apache-2.0) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- CodeAgent چیست؟: قسمت سیزدهم همین مجموعه، با راهاندازی SmolagentsInstrumentor؛ سطح مبتدی تا متوسط.
- AI Agent Observability and Evaluation (انگلیسی): منبع اصلی این قسمت؛ سطح متوسط.
- نوتبوک پایش و ارزیابی ایجنت در Agents Course (انگلیسی): پیادهسازی عملی با Langfuse؛ سطح متوسط.
- اتصال smolagents به Langfuse (انگلیسی): مستند رسمی یکپارچهسازی؛ سطح متوسط.
- مستندات RAGAS (انگلیسی): معیارهای ارزیابی خودکار برای ایجنتهای RAG؛ سطح حرفهای.
پرسشهای پرتکرار
مشاهدهپذیری در ایجنت هوش مصنوعی یعنی چه؟
یعنی بتوانید از روی نشانههای بیرونی مثل لاگ، معیار و Trace بفهمید درون ایجنت چه میگذرد؛ کدام ابزار صدا زده شد، مدل چه پاسخی داد، هر قدم چقدر طول کشید و چقدر هزینه داشت.
فرق Trace و Span چیست؟
Trace کل یک کار ایجنت را از شروع تا پایان نشان میدهد؛ مثلاً پاسخ به یک پرسش کاربر. Span هر قدم جداگانه درون آن Trace است؛ مثل یک فراخوانی مدل یا اجرای یک ابزار.
ارزیابی آفلاین و آنلاین چه فرقی دارند؟
ارزیابی آفلاین روی مجموعهی آزمونی با پاسخهای مشخص و پیش از انتشار انجام میشود و تکرارپذیر است. ارزیابی آنلاین روی تعاملهای واقعی کاربران در محیط تولید انجام میشود و مشکلاتی را نشان میدهد که در آزمون پیشبینی نشده بودند.
میتوان کیفیت پاسخ ایجنت را خودکار سنجید؟
بله. میتوان از یک مدل زبانی بهعنوان داور استفاده کرد تا مفید بودن و درستی پاسخ را امتیاز دهد. کتابخانههایی مثل RAGAS برای ایجنتهای RAG و LLM Guard برای تشخیص محتوای مضر و تزریق پرامپت هم وجود دارند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.