
Agentic RAG پاسخی است به محدودیتهای RAG معمولی. در قسمت ششم دیدیم RAG چطور متنهای مرتبط را پیدا میکند و به مدل میدهد تا بر اساس آنها جواب بدهد. اما RAG معمولی فقط یک بار جستجو میکند؛ آن هم با همان جملهای که کاربر نوشته است. اگر آن یک جستجو نتیجهی خوبی ندهد، پاسخ هم ضعیف میشود.
در این قسمت از مجموعهی «از پرامپت تا دستیار هوش مصنوعی» ایجنت را مسئول جستجو میکنیم. ایجنتی که خودش تصمیم میگیرد چه چیزی را، کجا و چند بار جستجو کند. با smolagents دو نمونه میسازیم: یکی با جستجوی وب و دیگری با پایگاه دانش اختصاصی.
Agentic RAG چیست و چه مشکلی را حل میکند؟
سیستم RAG (تولید متن با کمک بازیابی) توانایی بازیابی داده و تولید متن را ترکیب میکند. پرسش کاربر به موتور جستجو میرود و نتایج همراه پرسش به مدل داده میشود. سپس مدل پاسخ را بر اساس هر دو میسازد.
Agentic RAG همین سیستم را با ایجنت خودمختار ترکیب میکند. در RAG معمولی مدل فقط در مرحلهی تولید پاسخ نقش دارد. در مقابل، در Agentic RAG هم بازیابی و هم تولید زیر کنترل هوشمند ایجنت است.
فرق این دو را در یک کتابخانهی عمومی تصور کنید. RAG معمولی مثل کارمندی است که جملهی شما را عیناً در فهرست کتابها جستجو میکند و هرچه آمد تحویل میدهد. Agentic RAG مثل کتابدار باتجربهای است که اول میپرسد منظورتان چیست، چند قفسه را میگردد و اگر کتاب کافی نبود، با کلمهی دیگری دوباره جستجو میکند.
البته این کتابدار وقت بیشتری میگیرد؛ همان هزینهای که در ادامه به آن میرسیم. پس تشبیه تا جایی درست است که هزینه را هم در نظر بگیرید.
محدودیتهای RAG معمولی
RAG معمولی دو ضعف اصلی دارد. اول، به یک مرحلهی بازیابی متکی است. یعنی اگر همان یک جستجو اطلاعات کافی نیاورد، راهی برای جبران وجود ندارد. دوم، فقط بر شباهت معنایی مستقیم با پرسش کاربر تکیه میکند.
با این حال، پرسش کاربر همیشه بهترین عبارت جستجو نیست. کاربر ممکن است محاورهای بنویسد، چند سؤال را در یک جمله بپرسد یا اصطلاحی به کار ببرد که در اسناد نیامده است. در همهی این حالتها اطلاعات مرتبط ممکن است از دست برود.
بیشتر بخوانید: مفاهیم پایهی RAG، از قطعهبندی و پایگاه داده برداری تا بازچینی، در RAG چیست؟ با کد کامل توضیح داده شدهاند.
ایجنت چطور کمک میکند؟
ایجنت میتواند خودش پرسش جستجو را بنویسد، نتایج بازیابیشده را نقد کند و اگر کافی نبود، دوباره و با عبارت دیگری جستجو کند. در نتیجه پاسخ دقیقتر و کاملتر میشود.
جدول زیر تفاوت دو رویکرد را خلاصه میکند. به ردیف آخر دقت کنید؛ هر مزیت Agentic RAG هزینهای در سرعت و پول دارد.
| ویژگی | RAG معمولی | Agentic RAG |
|---|---|---|
| تعداد جستجو | یک بار | چند بار در صورت نیاز |
| عبارت جستجو | همان پرسش کاربر | بازنویسیشده توسط ایجنت |
| منبع داده | معمولاً یک منبع | ترکیب چند منبع مثل وب و اسناد |
| بررسی نتایج | ندارد | ایجنت نتایج را ارزیابی میکند |
| هزینه و سرعت | کم و سریع | بیشتر و کندتر |
بازیابی ساده با جستجوی وب
با یک نمونهی ساده شروع میکنیم. آلفرد برای مهمانی ابرقهرمانی عمارت وین ایدههای لوکس میخواهد. ایجنتی میسازیم که با DuckDuckGo در وب جستجو کند:
from smolagents import CodeAgent, DuckDuckGoSearchTool, InferenceClientModel

agent = CodeAgent(model=InferenceClientModel(), tools=[DuckDuckGoSearchTool()])
response = agent.run(
    "Search for luxury superhero-themed party ideas, including decorations, entertainment, and catering."
)
print(response)
در واقع همین کد ساده یک Agentic RAG کامل است. تفاوتش با RAG معمولی این است که ایجنت تصمیم میگیرد چه عبارتهایی را جستجو کند و چند بار.
ایجنت چه مراحلی را طی میکند؟
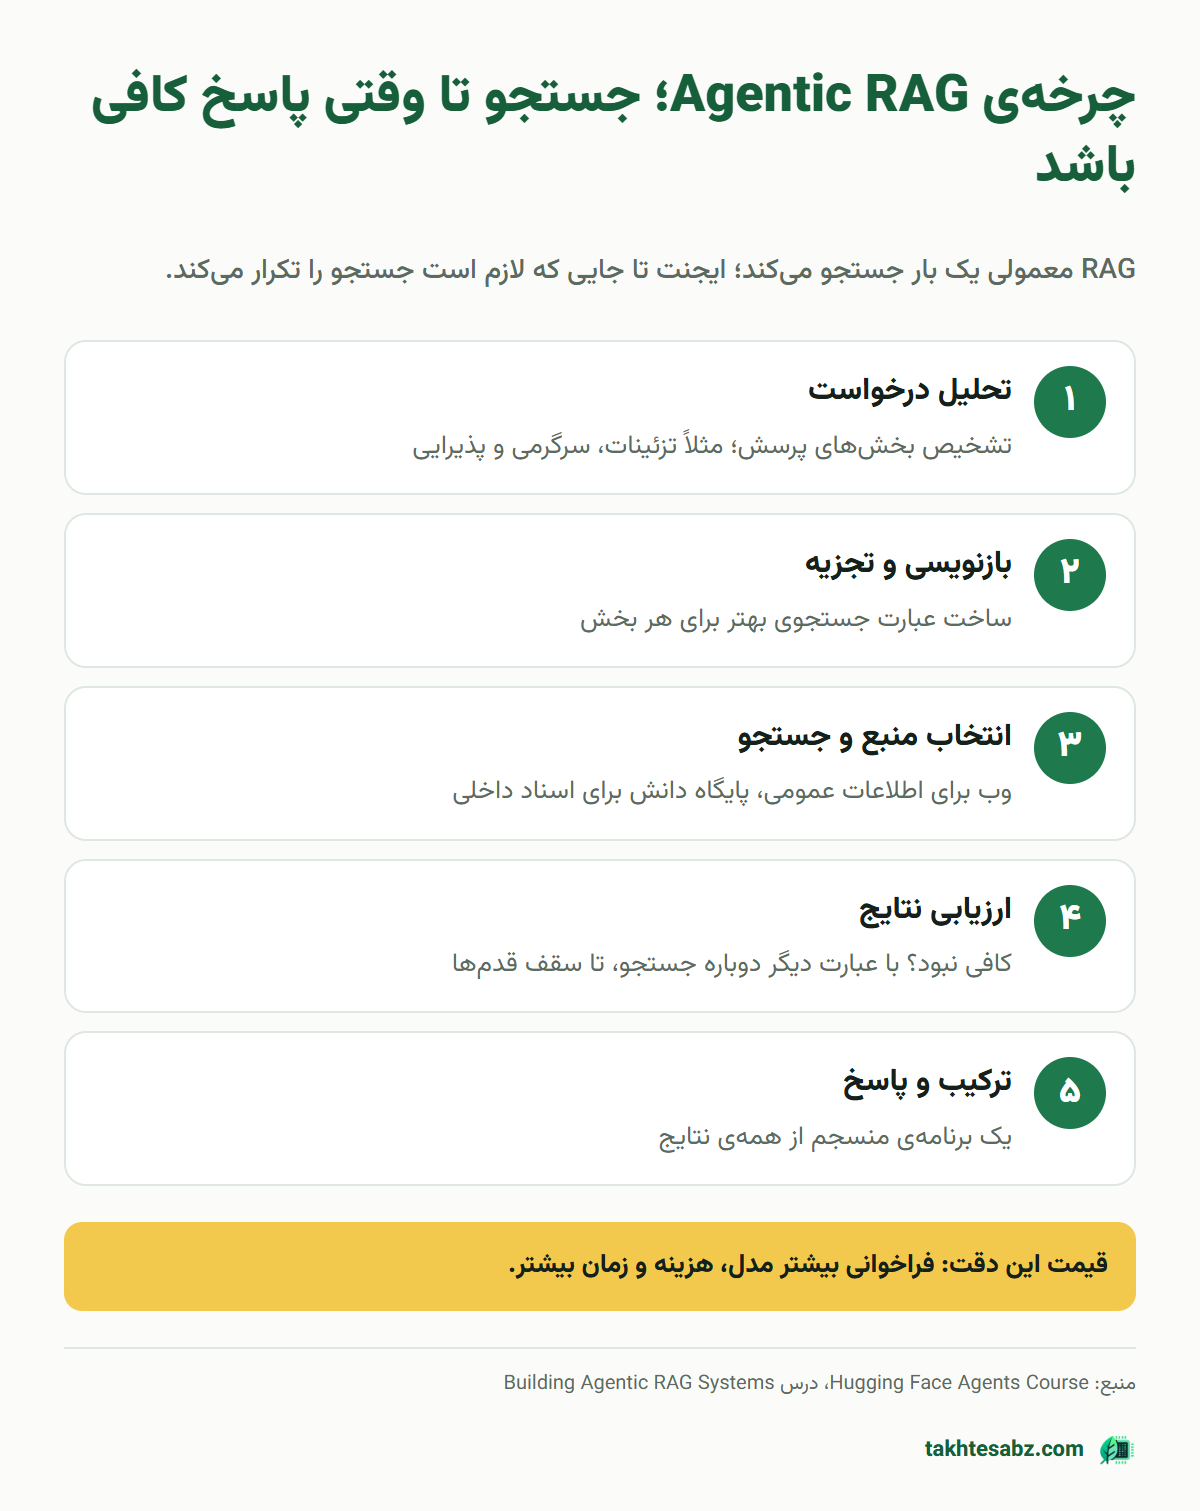
ایجنت ابتدا درخواست را تحلیل میکند و عناصر کلیدیاش را تشخیص میدهد: مهمانی ابرقهرمانی لوکس با تمرکز بر تزئینات، سرگرمی و پذیرایی. سپس برای هر بخش جستجوی جداگانهای انجام میدهد تا اطلاعات بهروز و مرتبط جمع کند.
پس از آن، نتایج را در یک برنامهی منسجم و قابل اجرا ترکیب میکند. علاوه بر این، نتایج در حافظهی ایجنت هم میماند تا در قدمهای بعدی یا برنامهریزیهای آینده از آن استفاده کند. این رفتار چندمرحلهای همان چیزی است که RAG معمولی ندارد.
ابزار پایگاه دانش اختصاصی
اما برای کارهای تخصصی، جستجوی وب کافی نیست. به پایگاه دانش خودتان نیاز دارید؛ مثلاً مستندات فنی، راهنمای محصول یا دانش داخلی شرکت. در این بخش ابزاری میسازیم که در یک پایگاه دانش اختصاصی جستجو میکند.
ساخت ابزار بازیابی با BM25
برای سادگی از بازیاب BM25 استفاده میکنیم. BM25 یک الگوریتم رتبهبندی کلمهمحور است و به مدل Embedding نیاز ندارد. ابزار را به شکل زیرکلاس Tool میسازیم، همان روشی که در قسمت قبل دیدیم. پیش از اجرا، بستههای smolagents، langchain-community، langchain-text-splitters و rank_bm25 را نصب کنید:
from langchain_community.retrievers import BM25Retriever
from smolagents import Tool

class PartyPlanningRetrieverTool(Tool):
    name = "party_planning_retriever"
    description = "Retrieves relevant party planning ideas for Alfred's superhero-themed party at Wayne Manor."
    inputs = {"query": {"type": "string", "description": "A query related to party planning or superhero themes."}}
    output_type = "string"

    def __init__(self, docs, **kwargs):
        super().__init__(**kwargs)
        self.retriever = BM25Retriever.from_documents(docs, k=5)

    def forward(self, query: str) -> str:
        docs = self.retriever.invoke(query)
        return "\nRetrieved ideas:\n" + "".join(f"\n\n===== Idea {i} =====\n{d.page_content}" for i, d in enumerate(docs))
در این کد بازیاب یک بار در سازنده ساخته میشود و در هر فراخوانی پنج سند مرتبط برمیگرداند. برای پروژهی واقعی میتوانید BM25 را با جستجوی برداری یا ترکیبی عوض کنید؛ بدون اینکه رابط ابزار تغییر کند.
BM25 را مثل فهرست راهنمای انتهای یک کتاب درسی ببینید. کلمه را پیدا میکند و صفحههایی را بالاتر میآورد که کلمههای کمیابتر پرسش را بیشتر دارند. اما معنی نمیفهمد؛ اگر شما «کترینگ» بپرسید و سند «پذیرایی» نوشته باشد، چیزی پیدا نمیکند. دقیقاً به همین دلیل، بازنویسی و گسترش پرسش توسط ایجنت اینقدر به BM25 کمک میکند.
آمادهسازی اسناد و اجرای ایجنت
پایگاه دانش نمونه پنج ایدهی مهمانی دارد؛ از تزئینات و موسیقی تا پذیرایی و تجربهی واقعیت مجازی. هر ایده به یک Document تبدیل میشود و با RecursiveCharacterTextSplitter به قطعههای حداکثر ۵۰۰ کاراکتری با ۵۰ کاراکتر همپوشانی تقسیم میشود. همپوشانی مثل تکرار چند خط آخر هر صفحه در بالای صفحهی بعد است تا جملهای وسط برش گم نشود.
سپس ابزار را با اسناد پردازششده میسازیم و به ایجنت میدهیم. کد زیر کل این مسیر را نشان میدهد؛ دو ایدهی نمونه را خودمان کوتاه نوشتهایم و بقیه را با متن خودتان کامل کنید:
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitter
from smolagents import CodeAgent, InferenceClientModel
party_ideas = [
{"text": "A superhero-themed masquerade ball with luxury decor and gold accents.", "source": "Party Ideas 1"},
{"text": "Themed catering with dishes named after superheroes and villains.", "source": "Catering Ideas"},
# ... سه ایدهی دیگر
]
source_docs = [Document(page_content=d["text"], metadata={"source": d["source"]}) for d in party_ideas]
splitter = RecursiveCharacterTextSplitter(
chunk_size=500, chunk_overlap=50, add_start_index=True,
strip_whitespace=True, separators=["\n\n", "\n", ".", " ", ""],
)
docs_processed = splitter.split_documents(source_docs)
agent = CodeAgent(tools=[PartyPlanningRetrieverTool(docs_processed)], model=InferenceClientModel())
print(agent.run("Find ideas for a luxury superhero-themed party, including entertainment, catering, and decoration options."))حالا ایجنت اول در اسناد اختصاصی جستجو میکند، بینشهای پایگاه دانش را ترکیب میکند و زمینهی گفتوگو را در حافظه نگه میدارد. اگر لازم باشد، میتوانید ابزار جستجوی وب را هم کنارش بگذارید تا ایجنت از هر دو منبع استفاده کند.
هفت راهبرد بازیابی پیشرفته
ایجنت در Agentic RAG میتواند از راهبردهای پیچیدهتری برای بازیابی استفاده کند. به این ترتیب کیفیت نتایج بهطور محسوسی بالا میرود. جدول زیر هر هفت راهبرد را همراه یک مثال نشان میدهد.
| راهبرد | کار ایجنت | مثال |
|---|---|---|
| بازنویسی پرسش | ساخت عبارت جستجوی بهینه بهجای جملهی خام کاربر | «یه مهمونی شیک میخوام» ← «ایده مهمانی لوکس» |
| تجزیهی پرسش | شکستن پرسش چندبخشی به چند جستجوی جدا | جستجوی جدا برای تزئینات، موسیقی و غذا |
| گسترش پرسش | جستجوی یک مفهوم با چند عبارت مختلف | «پذیرایی»، «کترینگ»، «منوی مهمانی» |
| بازچینی | مرتبکردن دوبارهی نتایج با مدل دقیقتر | استفاده از Cross-Encoder |
| بازیابی چندمرحلهای | استفاده از نتیجهی جستجوی اول برای جستجوی بعدی | یافتن نام شرکت و بعد جستجوی نظرات آن |
| ترکیب منابع | جمعکردن اطلاعات از وب و اسناد داخلی | ترکیب ترندهای وب با بودجهی شرکت |
| اعتبارسنجی نتایج | بررسی ارتباط و درستی محتوا پیش از استفاده | حذف نتایج قدیمی یا بیربط |
نکتههای طراحی Agentic RAG
یک سیستم Agentic RAG مؤثر به چند نکتهی کلیدی نیاز دارد. در واقع همین نکتهها تفاوت یک نمونهی آزمایشی با یک سیستم قابلاعتماد را میسازند.
انتخاب ابزار، حافظه و راه جایگزین
ایجنت باید بر اساس نوع پرسش، ابزار درست را انتخاب کند. برای مثال، پرسش دربارهی سیاستهای داخلی شرکت باید به پایگاه دانش برود، نه جستجوی وب. توضیح دقیق هر ابزار دقیقاً همین تصمیم را ممکن میکند.
همچنین حافظه جلوی جستجوهای تکراری را میگیرد. اگر ایجنت چیزی را قبلاً پیدا کرده، لازم نیست دوباره هزینهی جستجو را بپردازد. راهبرد جایگزین هم ضروری است؛ اگر روش اصلی بازیابی شکست خورد، سیستم باید هنوز بتواند پاسخ مفیدی بدهد یا صادقانه بگوید اطلاعات کافی ندارد.
هزینه و تعادل
هر جستجوی اضافه و هر دور فکر ایجنت هزینه و زمان دارد. Agentic RAG برای پرسشهای پیچیده و چندبخشی ارزشش را دارد. اما برای پرسشهای ساده، RAG معمولی سریعتر و اقتصادیتر است.
بنابراین یک راه عملی، مسیریابی است. پرسشهای ساده به RAG معمولی بروند و فقط پرسشهای پیچیده به ایجنت. سقف تعداد قدم را هم همیشه تعیین کنید تا ایجنت در جستجوهای بیپایان گیر نکند. در سرویس شما چند درصد پرسشها واقعاً چندبخشیاند؟ پاسخ همین سؤال نشان میدهد Agentic RAG ارزش هزینهاش را دارد یا نه.
تمرین عملی؛ دستیار دورهها با Agentic RAG
دستیار پروژهی مشترک را به یک Agentic RAG تبدیل کنید:
- توضیح کامل دورهها را به
Documentتبدیل و با BM25 یک ابزار بازیابی بسازید. DuckDuckGoSearchToolرا هم به ایجنت بدهید تا بتواند نظرات کاربران دربارهی یک فناوری را از وب پیدا کند.- پرسش چندبخشی بپرسید: «یک دورهی هوش مصنوعی مبتدی پیشنهاد بده و بگو این حوزه چه آیندهی شغلیای دارد.»
در گزارش اجرا بررسی کنید ایجنت پرسش را چطور تجزیه کرد و برای هر بخش از کدام ابزار استفاده کرد. اگر برای بخش دوم سراغ پایگاه دانش رفت، توضیح ابزارها را دقیقتر کنید.
سخن پایانی
بهطور خلاصه، Agentic RAG کنترل جستجو را به ایجنت میسپارد. ایجنت پرسش را بازنویسی و تجزیه میکند، از چند منبع جستجو میکند، نتایج را میسنجد و اگر لازم باشد دوباره جستجو میکند. نتیجه پاسخهایی کاملتر و دقیقتر است؛ به قیمت هزینه و زمان بیشتر. هنر طراحی این است که بدانید کدام پرسش به این قدرت نیاز دارد و کدام با RAG ساده هم حل میشود.
در قسمت شانزدهم ایجنت را به مدلهای بینایی-زبانی مجهز میکنیم تا تصویر را هم بفهمد.
این آموزش بر پایهی بخش Building Agentic RAG Systems از دورهی آزاد Agents Course در Hugging Face (مجوز Apache-2.0) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- RAG چیست؟ آموزش ساخت دستیار پاسخگو از روی اسناد: پایهی RAG معمولی به فارسی؛ پیشنیاز همین درس.
- Building Agentic RAG Systems در Agents Course (انگلیسی): متن و نوتبوک اصلی این درس با پنج ایدهی کامل پایگاه دانش؛ برای سطح متوسط.
- مثال Agentic RAG در مستندات smolagents (انگلیسی): نمونهی رسمی روی مستندات واقعی با ارزیابی نتیجه؛ برای سطح متوسط تا پیشرفته.
- مدیریت شکست در Agentic RAG: وقتی جستجوی ایجنت به نتیجه نمیرسد چه کنیم؛ گام بعدی پس از این درس.
- Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG (انگلیسی): مرور پژوهشی و طبقهبندی معماریهای Agentic RAG؛ برای سطح پیشرفته.
پرسشهای پرتکرار
فرق Agentic RAG با RAG معمولی چیست؟
RAG معمولی یک بار با همان پرسش کاربر جستجو میکند و نتایج را به مدل میدهد. در Agentic RAG ایجنت خودش پرسش جستجو را بازنویسی میکند، نتایج را ارزیابی میکند و اگر کافی نبود، چند بار و از چند منبع جستجو میکند.
BM25 چیست و چرا در این آموزش استفاده شده؟
BM25 یک الگوریتم رتبهبندی کلمهمحور است که بدون نیاز به مدل Embedding کار میکند. برای نمونههای ساده و سریع مناسب است؛ در پروژهی واقعی میتوانید آن را با جستجوی برداری یا ترکیبی عوض کنید.
Agentic RAG همیشه بهتر از RAG معمولی است؟
نه. Agentic RAG دقیقتر و انعطافپذیرتر است اما کندتر و پرهزینهتر هم هست، چون چند فراخوانی مدل و جستجو انجام میدهد. برای پرسشهای ساده و مستقیم، RAG معمولی کافی و اقتصادیتر است.
بازنویسی پرسش در Agentic RAG یعنی چه؟
ایجنت بهجای جستجوی عین جملهی کاربر، عبارتی میسازد که به متن اسناد نزدیکتر است. مثلاً پرسش محاورهای کاربر را به چند کلمهی کلیدی دقیق تبدیل میکند تا نتایج مرتبطتری پیدا شود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.