
ساخت ایجنت هوش مصنوعی معمولاً با نصب یک فریمورک شروع میشود. اما وقتی همهچیز پشت چند تابع آماده پنهان باشد، نمیفهمید واقعاً چه اتفاقی میافتد. در نتیجه، هر وقت خطایی پیش بیاید، نمیدانید کجا را باید بگردید.
در این قسمت از مجموعهی «از پرامپت تا دستیار هوش مصنوعی» یک ایجنت را از صفر و فقط با پایتون میسازیم. از همان چرخهی فکر، اقدام و مشاهدهی قسمت قبل استفاده میکنیم و با یک مشکل مهم روبهرو میشویم که هر سازندهی ایجنتی باید بشناسد. در قسمت بعد همین کار را با کتابخانهی smolagents انجام میدهیم.
چرا ساخت ایجنت هوش مصنوعی را از صفر شروع کنیم؟
دورهی ایجنتهای Hugging Face عمداً به فریمورک خاصی وابسته نیست. هدف این است که مفاهیم را یاد بگیرید، نه جزئیات یک کتابخانهی خاص را. با این دانش میتوانید در هر فریمورکی که دوست دارید کار کنید.
کدی که امروز مینویسیم برای محیط تولید مناسب نیست. اما نقطهی شروع عالی برای فهم سازوکار ایجنتهاست. فقط از بستههای داخلی پایتون و یک API ساده استفاده میکنیم تا در هر محیطی قابل اجرا باشد.
ساختن ایجنت از صفر شبیه این است که پیش از رانندگی با ماشین اتوماتیک، یک بار با دندهی دستی رانندگی کنید. بعد از آن، وقتی گیربکس خودکار رفتار عجیبی نشان دهد، میفهمید زیر کاپوت چه میگذرد. البته این تشبیه یک حد دارد: در دنیای ایجنت، نسخهی دستی را در محیط واقعی به کار نمیبرید و فقط برای یادگیری است.
جایگاه این درس در مسیر یادگیری
در قسمتهای قبل فهمیدیم ایجنت چیست، ابزار چطور تعریف میشود و چرخهی کار ایجنت چه مراحلی دارد. بنابراین قدم بعدی ساختن اولین ایجنت است. این درس پلی میان مفاهیم نظری و کار با فریمورکهای واقعی است.
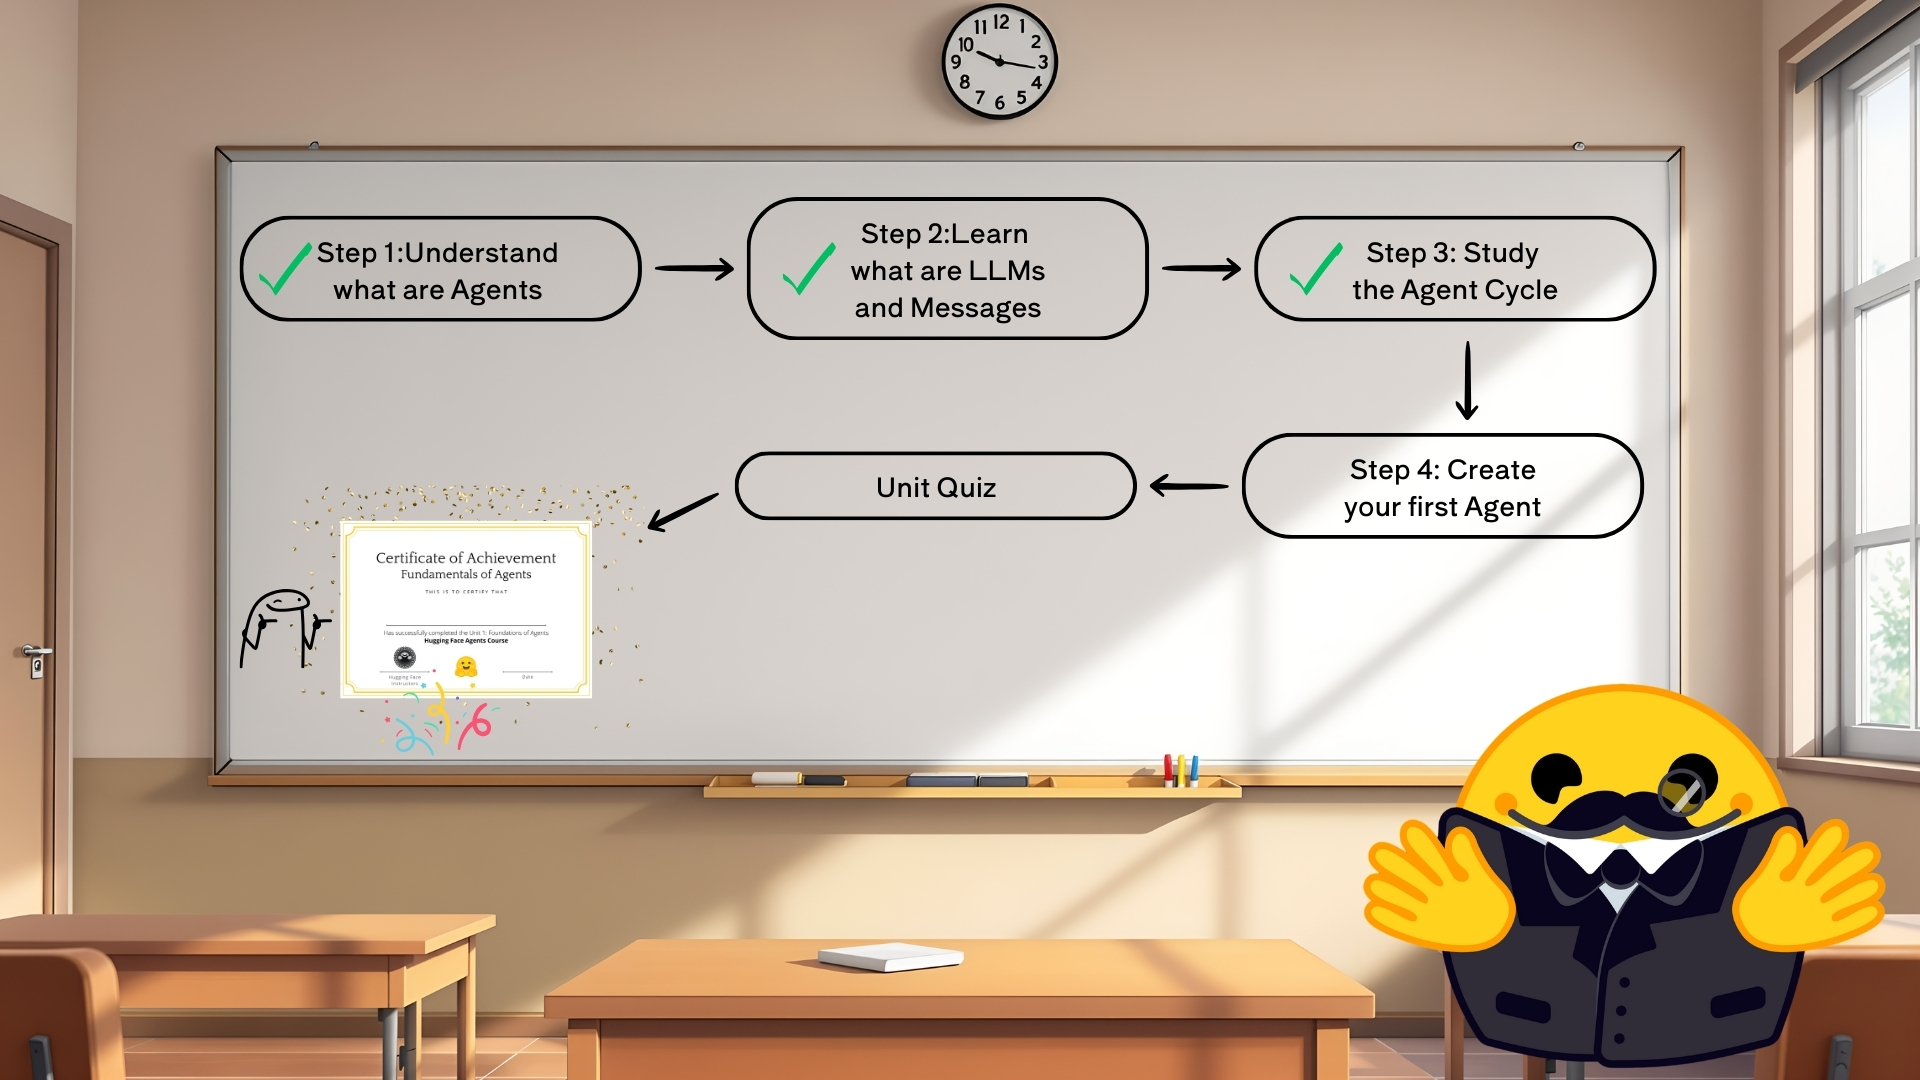
بعد از این قسمت، سراغ smolagents میرویم و در ادامه با LangGraph هم کار میکنیم. تصویر زیر مسیر بخش اول دورهی Hugging Face را نشان میدهد که ما حالا به قدم چهارمش رسیدهایم.
اتصال به مدل با API بدون سرور
برای ساخت ایجنت اول به یک مدل زبانی نیاز داریم. در اکوسیستم Hugging Face قابلیتی به نام Serverless API (رابط برنامهنویسی بدون سرور) وجود دارد. با آن میتوانید بدون نصب یا استقرار، از مدلهای مختلف استفاده کنید. فقط یک توکن دسترسی از بخش تنظیمات حساب Hugging Face لازم است.
Serverless API را مثل سفارش غذا از رستوران تصور کنید. لازم نیست آشپزخانه بسازید و اجاق بخرید؛ فقط سفارش میدهید و غذا میرسد. در مقابل، اختیار کامل آشپزخانه دست شما نیست. یعنی فهرست مدلها و سقف استفاده را Hugging Face تعیین میکند.
ساخت کلاینت
کتابخانهی huggingface_hub را نصب کنید و توکن را در متغیر محیطی HF_TOKEN بگذارید. سپس کلاینت را بسازید:
import os
from huggingface_hub import InferenceClient

client = InferenceClient(model="moonshotai/Kimi-K2.5", token=os.environ.get("HF_TOKEN"))
نام مدل را میتوانید با هر مدل دیگری که Serverless API پشتیبانی میکند عوض کنید. مدلهای در دسترس بهمرور تغییر میکنند؛ پس اگر مدلی کار نکرد، فهرست فعلی را در سایت Hugging Face ببینید. همچنین توکن را هرگز مستقیم داخل کد ننویسید، چون با اشتراکگذاری کد لو میرود.
متد chat برای جابهجایی راحت مدل
برای فرستادن پیام از متد chat.completions.create استفاده میکنیم. این متد قالب گفتوگوی مخصوص هر مدل را خودکار اعمال میکند. یعنی لازم نیست نگران توکنهای ویژهای باشید که هر مدل برای جدا کردن پیامها دارد.
برای مثال، اگر پیام «پایتخت فرانسه» را بفرستید، پاسخ «پاریس» برمیگردد. همین آزمون ساده نشان میدهد اتصال برقرار است. استفاده از متد chat روش پیشنهادی است، چون کد شما بدون تغییر روی مدلهای مختلف کار میکند.
پیام سیستمی ایجنت
قلب هر کتابخانهی ایجنت، افزودن اطلاعات به پیام سیستمی است. پیام سیستمی ایجنت ما کمی مفصلتر از نمونهی قسمت قبل است، اما دو بخش اصلی دارد: اطلاعات ابزارها و دستورالعمل چرخهی فکر، اقدام و مشاهده.
معرفی ابزار و قالب JSON
در این پیام، ابزار get_weather معرفی میشود که هوای یک شهر را میگیرد. از مدل خواسته میشود برای استفاده از ابزار یک JSON بنویسد که دو کلید دارد: action برای نام ابزار و action_input برای ورودی آن. یک نمونهی کامل هم در پیام آمده است:
{
  "action": "get_weather",
  "action_input": {"location": "New York"}
}
آوردن نمونه در پیام سیستمی، همان تکنیک few-shot (یادگیری با چند نمونه) است که در قسمت دوم دیدیم. مدل با دیدن نمونه، قالب درست را بهتر رعایت میکند؛ درست مثل فرم اداری که یک نمونهی پرشده کنارش چسباندهاند.
قالب چرخه و پاسخ نهایی
بخش دوم پیام، قالب کار را تعیین میکند. مدل باید با Thought: فکرش را بنویسد، با Action: فقط یک اقدام انجام دهد و منتظر Observation: بماند. البته این چرخه میتواند چند بار تکرار شود.
در پایان، مدل باید با Thought: I now know the final answer و بعد Final Answer: پاسخ را اعلام کند. تأکید روی نوشتن دقیق همین کاراکترها اهمیت دارد، چون برنامه بر اساس آنها تشخیص میدهد کار تمام شده است.
بیشتر بخوانید: منطق کامل این قالب و دلیل هر بخش آن را در ایجنت هوش مصنوعی چطور کار میکند؟ با مثال ایجنت هواشناسی توضیح دادهایم.
اولین اجرا و مشکل مشاهدهی ساختگی
حالا پیام سیستمی و سؤال کاربر، «هوای لندن چطور است؟»، را به مدل میفرستیم. خروجی در نگاه اول بینقص است. مدل فکر میکند، فرمان JSON ابزار را مینویسد، مشاهده را میآورد و پاسخ نهایی میدهد: «هوای لندن نیمهابری و ۱۲ درجه است.»
مدل خودش جواب ابزار را ساخت
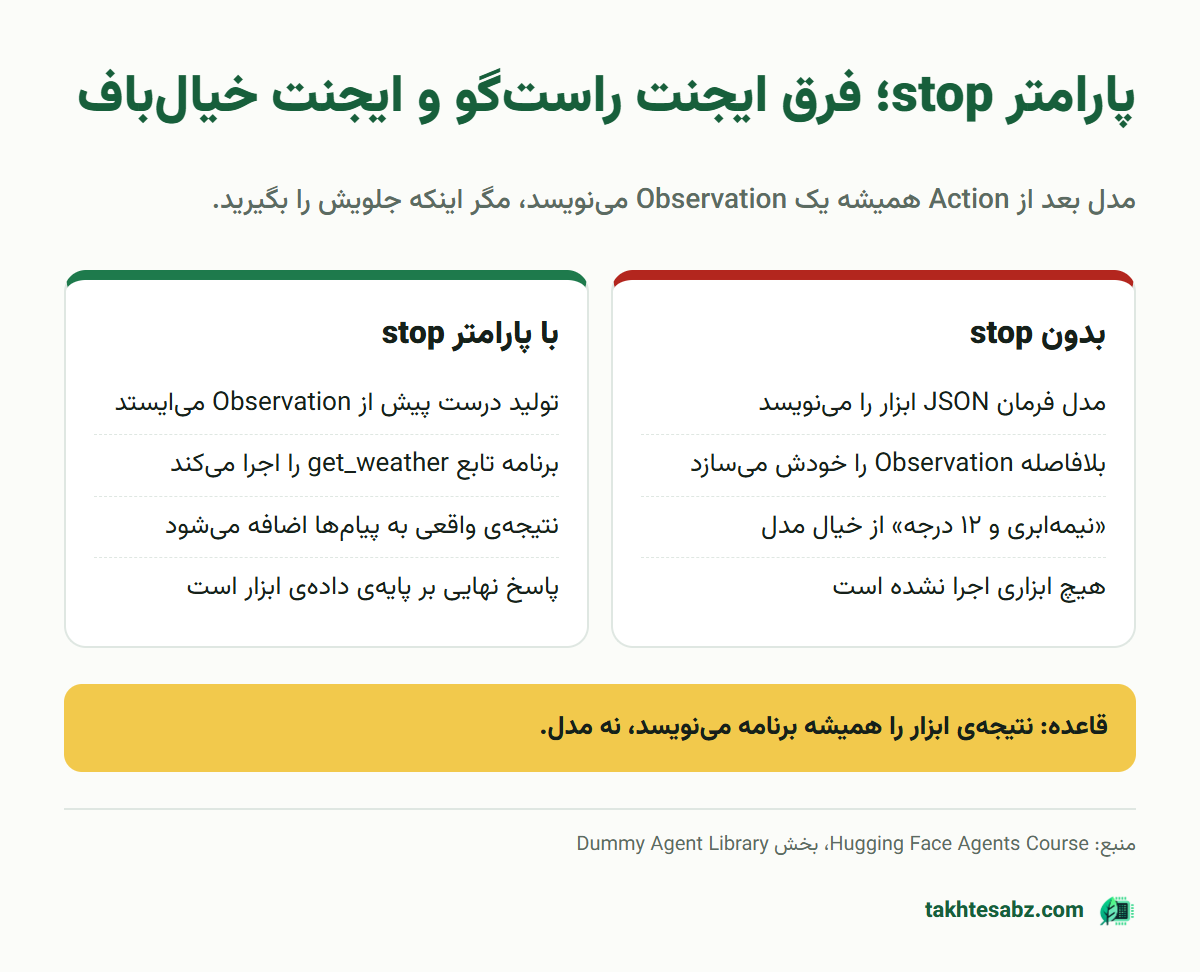
اما یک مشکل جدی وجود دارد. ما هیچ ابزاری اجرا نکردهایم! مدل بعد از نوشتن فرمان، بهجای اینکه منتظر بماند، خودش یک مشاهده ساخت و «نیمهابری و ۱۲ درجه» را از خودش درآورد. این یک پاسخ ساختگی کامل است.
در واقع این اتفاق طبیعی است. مدل فقط ادامهی محتمل متن را پیشبینی میکند و بعد از Action: محتملترین ادامه، یک Observation: است. اگر جلویش را نگیریم، همیشه همین کار را میکند.
به زبان ساده، مدل مثل کارمندی است که بهجای تلفن زدن به انبار، خودش در فرم مینویسد «موجودی دارد». فرم مرتب و کامل به نظر میرسد؛ با این حال هیچکس انبار را نگشته است. آیا به چنین گزارشی برای تصمیم واقعی اعتماد میکنید؟
توقف پیش از Observation
خوشبختانه راهحل ساده است. به مدل میگوییم به محض رسیدن به کلمهی Observation: تولید را متوقف کند. این کار با پارامتر stop (رشتهی توقف) انجام میشود؛ یعنی متنی که مدل به محض رسیدن به آن ساکت میشود:
output = client.chat.completions.create(
    messages=messages,
    max_tokens=150,
    stop=["Observation:"],
    extra_body={"thinking": {"type": "disabled"}},  # برای Kimi-K2.5: حالت فکر داخلی خاموش
)
print(output.choices[0].message.content)
به این ترتیب خروجی فقط شامل فکر و فرمان JSON است و همانجا متوقف میشود. نوبت برنامهی ماست که ابزار را واقعاً اجرا کند. خط extra_body را دورهی Hugging Face برای مدل Kimi-K2.5 اضافه کرده تا مدل متن استدلال داخلیاش را جدا تولید نکند. بنابراین اگر مدل دیگری انتخاب کردید و این پارامتر را نشناخت، آن خط را حذف کنید.
اجرای ابزار و ادامهی گفتوگو
برای این آموزش یک تابع ساختگی هواشناسی مینویسیم. در پروژهی واقعی این تابع یک API هواشناسی را صدا میزند:
def get_weather(location):
    return f"the weather in {location} is sunny with low temperatures.\n"
افزودن مشاهدهی واقعی
حالا پیام سیستمی، سؤال کاربر، خروجی مدل تا پیش از مشاهده و نتیجهی واقعی تابع را پشت هم میگذاریم و دوباره به مدل میفرستیم:
messages = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": "What's the weather in London?"},
    {"role": "assistant", "content": output.choices[0].message.content + "Observation:\n" + get_weather("London")},
]
final = client.chat.completions.create(messages=messages, max_tokens=200)
print(final.choices[0].message.content)
این بار مدل پاسخ نهایی را بر اساس دادهی واقعی تابع مینویسد: «هوای لندن آفتابی و خنک است.» پاسخ دقیقاً همان چیزی است که ابزار برگردانده؛ نه حدس مدل.
جمعبندی مراحل
کل فرایند در چهار قدم خلاصه میشود. جدول زیر نشان میدهد هر قدم را چه کسی انجام میدهد.
نکتهی کلیدی جدول، تقسیم کار است. مدل فقط فکر میکند و تصمیم میگیرد؛ در مقابل، اجرای ابزار و ساختن مشاهده همیشه کار برنامه است. به همین دلیل، هرجا این مرز به هم بریزد، ایجنت دوباره خیالبافی میکند.
| قدم | انجامدهنده | خروجی |
|---|---|---|
| فکر و انتخاب ابزار | مدل زبانی | Thought و Action به شکل JSON |
| توقف تولید | برنامه با پارامتر stop | متن تا پیش از Observation |
| اجرای ابزار | برنامه | نتیجهی واقعی ابزار |
| پاسخ نهایی | مدل زبانی | Final Answer بر اساس مشاهده |
از ایجنت دستی تا فریمورک
حالا دیدید ساخت ایجنت از صفر چقدر کار جزئی دارد. باید پیام سیستمی را با دقت بنویسید، تولید را در لحظهی درست متوقف کنید، JSON را از متن بیرون بکشید، ابزار را اجرا کنید و همهچیز را دوباره کنار هم بگذارید. تازه هنوز مدیریت خطا، چند ابزار و سقف قدمها را اضافه نکردهایم.
در واقع کتابخانههای ایجنت دقیقاً همین کارهای تکراری را انجام میدهند. اما حالا که سازوکار را میشناسید، وقتی فریمورک رفتار عجیبی نشان دهد، میدانید کجا را باید بررسی کنید. پیام سیستمی، نقطهی توقف یا خروجی ابزار؛ همان جاهایی که امروز با دست ساختیم.
تمرین عملی؛ دستیار دورهها بدون فریمورک
همین کد را برای دستیار پروژهی مشترک بازنویسی کنید:
- ابزار
get_weatherرا باsearch_coursesکه در قسمتهای قبل تعریف کردیم عوض کنید. - پیام سیستمی را با توضیح این ابزار و یک نمونهی JSON بهروز کنید.
- حلقهی قسمت قبل را به کد اضافه کنید تا ایجنت بتواند چند دور فکر و اقدام کند.
یک بار هم عمداً پارامتر stop را حذف کنید و ببینید مدل چه مشاهدهای از خودش میسازد. این آزمایش کوچک اهمیت این پارامتر را برای همیشه در ذهنتان نگه میدارد.
سخن پایانی
ساخت ایجنت هوش مصنوعی از صفر نشان میدهد هیچ جادویی در کار نیست. یک پیام سیستمی دقیق، یک مدل زبانی، یک نقطهی توقف درست و کمی کد که ابزار را اجرا میکند و نتیجه را برمیگرداند. مهمترین درس این قسمت، خطر مشاهدهی ساختگی است. هر ایجنتی که نتیجهی ابزار را از خود مدل بگیرد، قابلاعتماد نیست.
در قسمت دوازدهم همین مفاهیم را با کتابخانهی smolagents پیاده میکنیم و اولین ایجنت عملی را میسازیم.
این آموزش بر پایهی بخش Dummy Agent Library از دورهی آزاد Agents Course در Hugging Face (مجوز Apache-2.0) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- ایجنت هوش مصنوعی چطور کار میکند؟: مرور فارسی چرخهی فکر، اقدام و مشاهده؛ پیشنیاز همین درس برای سطح مبتدی.
- Dummy Agent Library در دورهی Agents Course (انگلیسی): متن و نوتبوک اصلی این درس با کد کامل پیام سیستمی؛ برای سطح متوسط.
- راهنمای Inference در کتابخانهی huggingface_hub (انگلیسی): مستندات رسمی
InferenceClientو متد chat؛ برای وقتی که میخواهید پارامترهای بیشتری را بشناسید. - مستندات Inference Providers در Hugging Face (انگلیسی): فهرست بهروز مدلها، ارائهدهندهها و سقف استفاده؛ برای انتخاب مدل جایگزین.
- مقالهی ReAct: Synergizing Reasoning and Acting in Language Models (انگلیسی): مقالهی پژوهشی که قالب Thought و Action و Observation از آن آمده؛ برای سطح پیشرفته.
پرسشهای پرتکرار
برای ساخت ایجنت هوش مصنوعی حتماً فریمورک لازم است؟
نه. همانطور که در این آموزش میبینید، با یک پیام سیستمی، یک تابع و چند خط پایتون میتوان ایجنت ساخت. فریمورکها کار را در پروژههای واقعی سادهتر و امنتر میکنند، اما برای فهم سازوکار، ساخت از صفر بهترین تمرین است.
Serverless API در Hugging Face چیست؟
قابلیتی که اجازه میدهد بدون نصب یا استقرار مدل، با یک توکن دسترسی و کتابخانهی huggingface_hub از مدلهای مختلف استفاده کنید. برای آزمایش و یادگیری بسیار مناسب است.
مشاهدهی ساختگی در ایجنت چیست؟
وقتی مدل بعد از نوشتن فرمان ابزار، نتیجهی آن را هم خودش حدس میزند و مینویسد. این نتیجه واقعی نیست. با توقف تولید پیش از کلمهی Observation و اجرای واقعی ابزار، این مشکل حل میشود.
چرا از متد chat بهجای تولید متن ساده استفاده میکنیم؟
متد chat قالب گفتوگوی مخصوص هر مدل را خودکار اعمال میکند. به این ترتیب کد شما بدون تغییر روی مدلهای مختلف کار میکند و جابهجایی مدل سادهتر میشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.