
RAG چیست و چرا تقریباً همهی دستیارهای هوش مصنوعی سازمانی از آن استفاده میکنند؟ مدل زبانی فقط چیزهایی را میداند که هنگام آموزش دیده است. از جزوههای شما، دفترچهی راهنمای محصولتان یا اتفاقات بعد از تاریخ آموزش خبری ندارد. RAG راهی است که این دانش را درست در لحظهی پاسخگویی در اختیار مدل میگذارد.
در قسمت قبل با جستجوی معنایی متنهای مرتبط را پیدا کردیم. در این قسمت از مجموعهی «از پرامپت تا دستیار هوش مصنوعی» آن متنها را به مدل زبانی میدهیم تا پاسخ را بر اساس آنها بنویسد. نتیجه دستیاری است که از روی اسناد خودتان جواب میدهد.
RAG چیست و چه مشکلی را حل میکند؟
RAG مخفف Retrieval Augmented Generation است؛ یعنی «تولید افزوده با بازیابی». چتباتی که روی مدل زبانی ساخته شده، پاسخهایش به دو چیز محدود است: دادههایی که مدل با آن آموزش دیده و زمینهای که در پرامپت به آن میدهید.
هر مدل تاریخ پایان دانش دارد و از رویدادهای بعد از آن بیخبر است. علاوه بر این، اطلاعات محرمانه مثل یادداشتهای شخصی یا مستندات داخلی شرکت هرگز در دادهی آموزشی مدل نبودهاند. RAG این شکاف را با افزودن اطلاعات مرتبط به پرامپت پر میکند.
سناریوی درسنامه؛ دستیار مرور درس
فرض کنید یک مؤسسهی آموزشی میخواهد جزوههای درسیاش را به چتبات بدهد. دانشجو باید بتواند از روی همان جزوهها آزمونک تمرینی بسازد، کارت مرور درست کند یا خلاصهی یک فصل را بگیرد.
در درسنامهی مایکروسافت، دادهی نمونه درس شبکههای عصبی است. مدل زبانی پاسخ را تولید میکند و یک پایگاه دادهی برداری هم متنها و بردارهای جزوه را نگه میدارد. حالا سؤال «پرسپترون چیست؟» از روی همان جزوه پاسخ داده میشود.
RAG چطور کار میکند؟
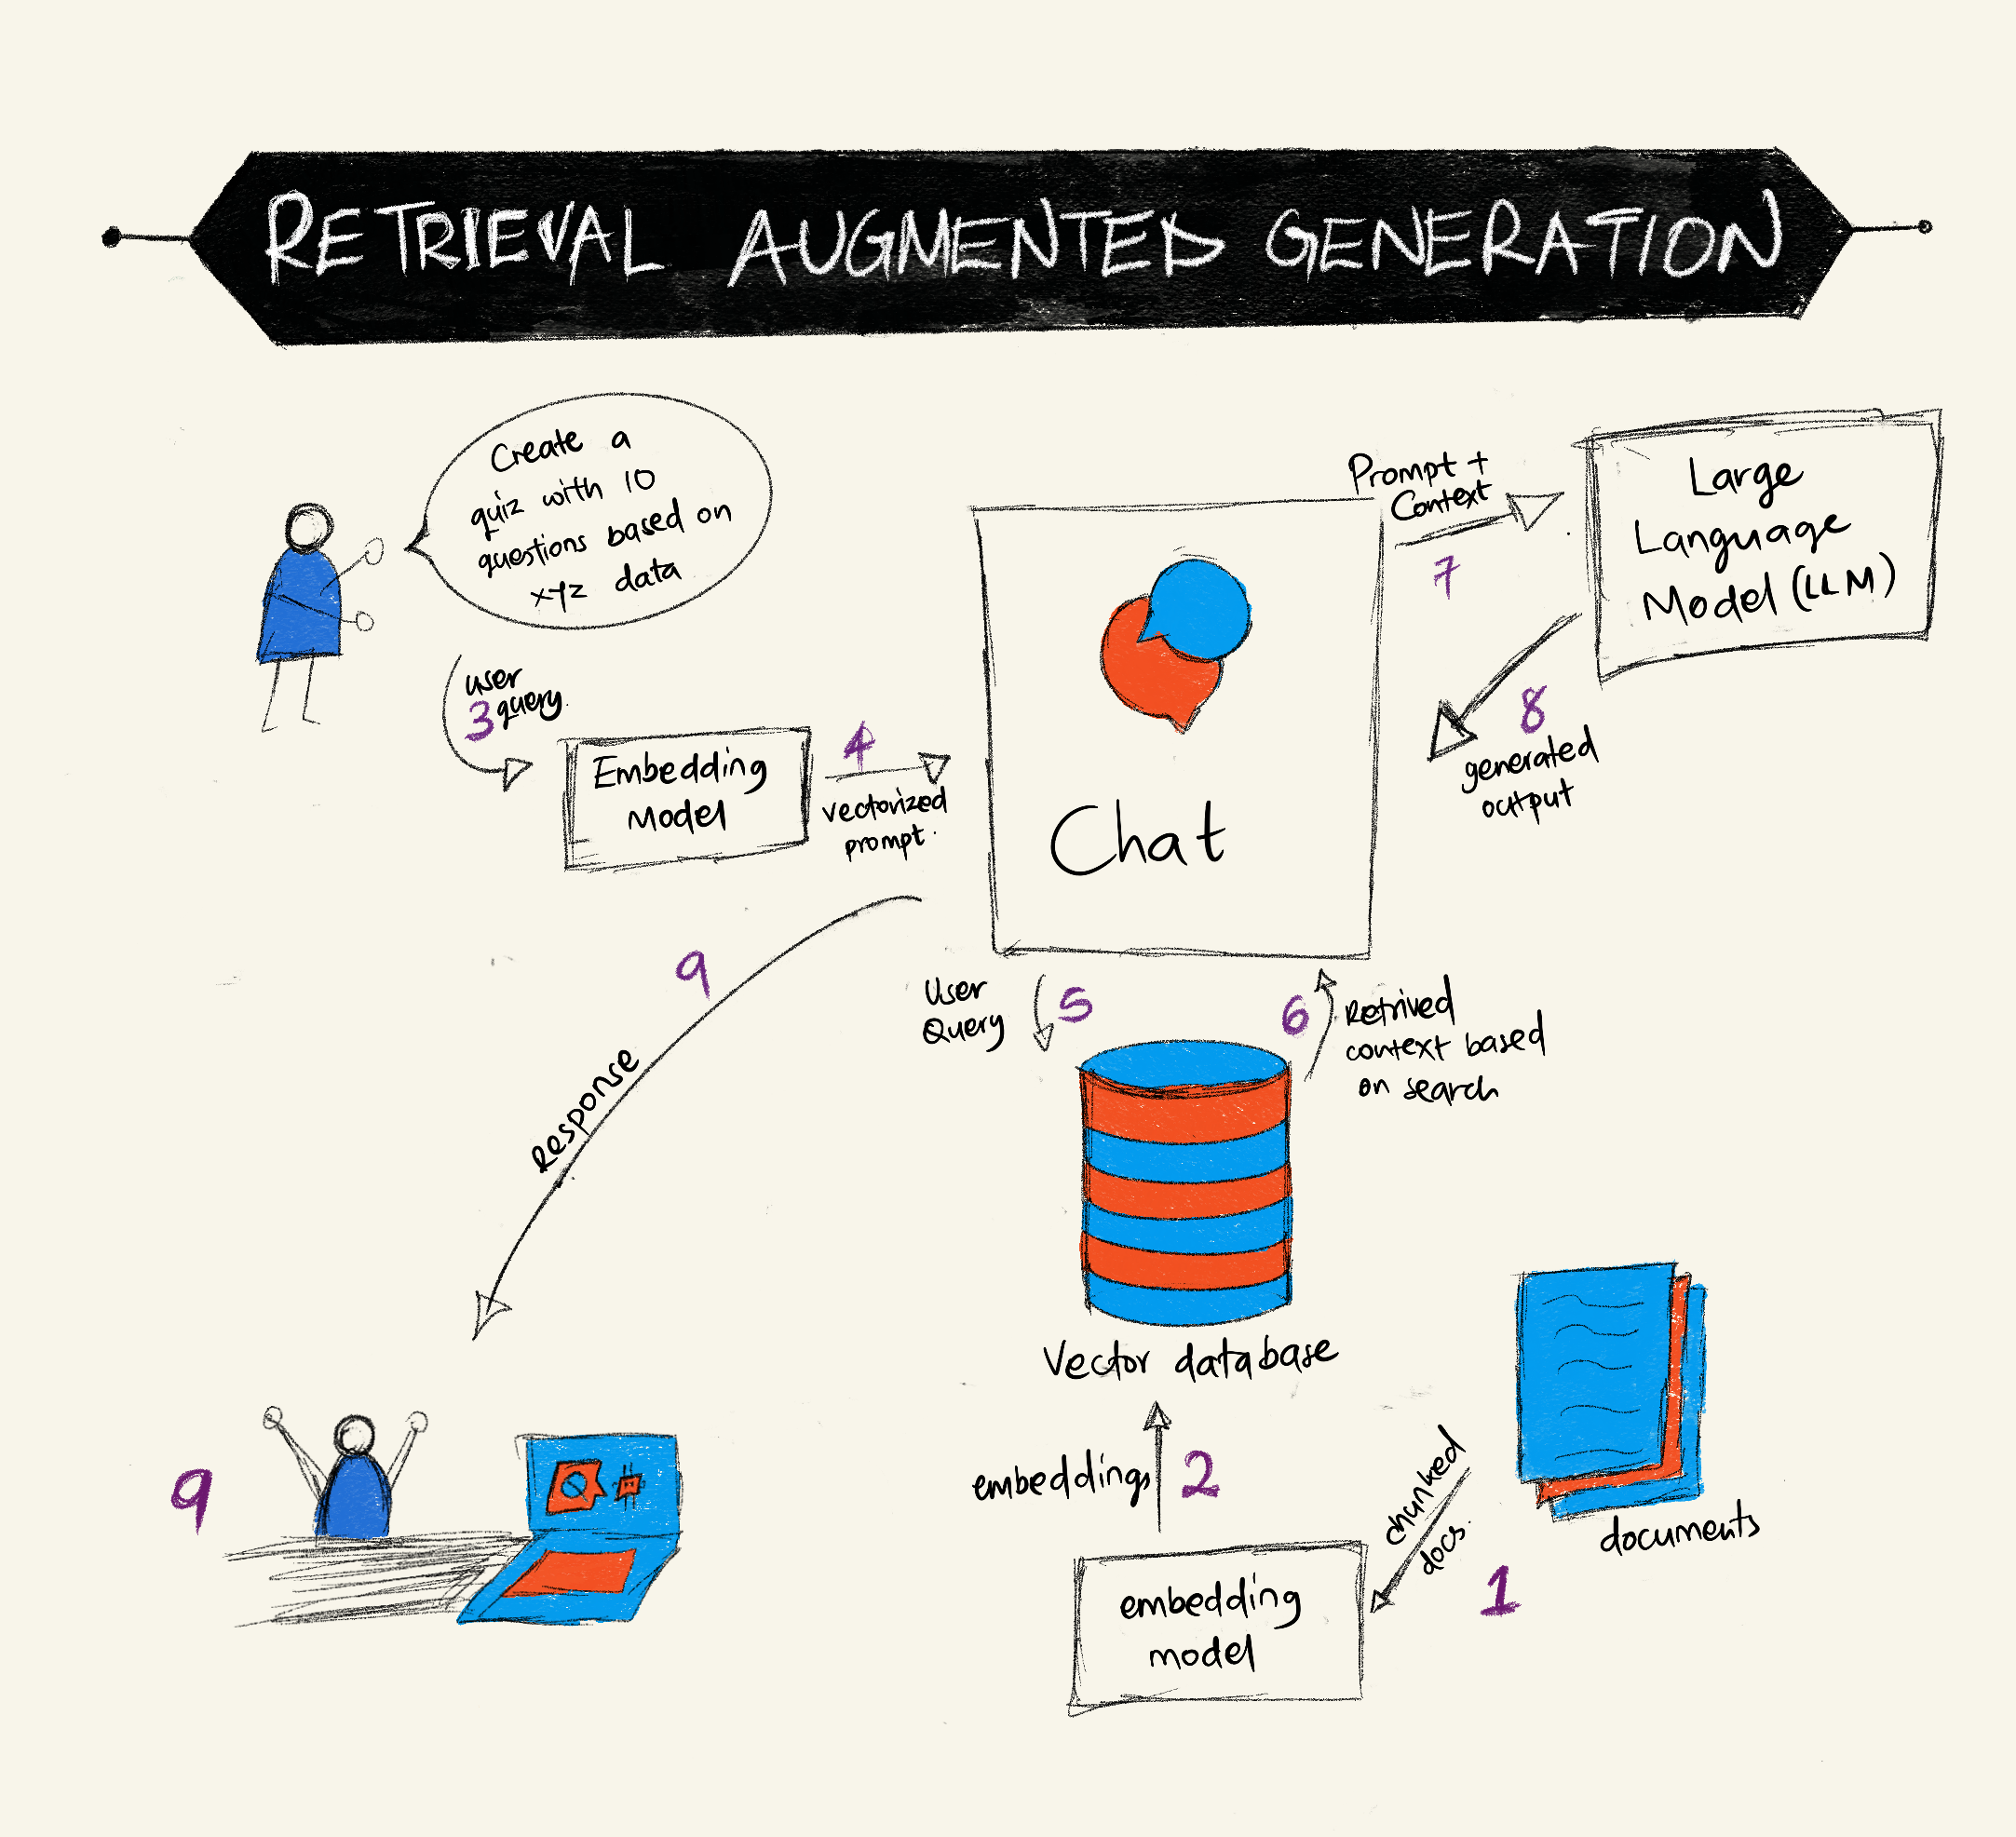
RAG چهار بخش اصلی دارد که به ترتیب کنار هم کار میکنند. هر بخش را میتوان جداگانه بهبود داد و همین انعطاف، RAG را محبوب کرده است:
- پایگاه دانش: اسناد پیش از هر چیز قطعهبندی، به بردار تبدیل و در پایگاه داده ذخیره میشوند.
- پرسش کاربر: کاربر سؤالش را به زبان طبیعی میپرسد.
- بازیابی: پرسش به بردار تبدیل میشود و نزدیکترین قطعهها از پایگاه دانش بیرون کشیده میشوند.
- تولید افزوده: قطعههای بازیابیشده همراه پرسش به مدل زبانی میروند و مدل پاسخ را بر اساس آنها مینویسد.
این چهار مرحله، از قطعهبندی اسناد تا رسیدن پاسخ به کاربر، در طرح زیر شمارهگذاری شدهاند.
دو رویکرد اصلی در مقالهی RAG
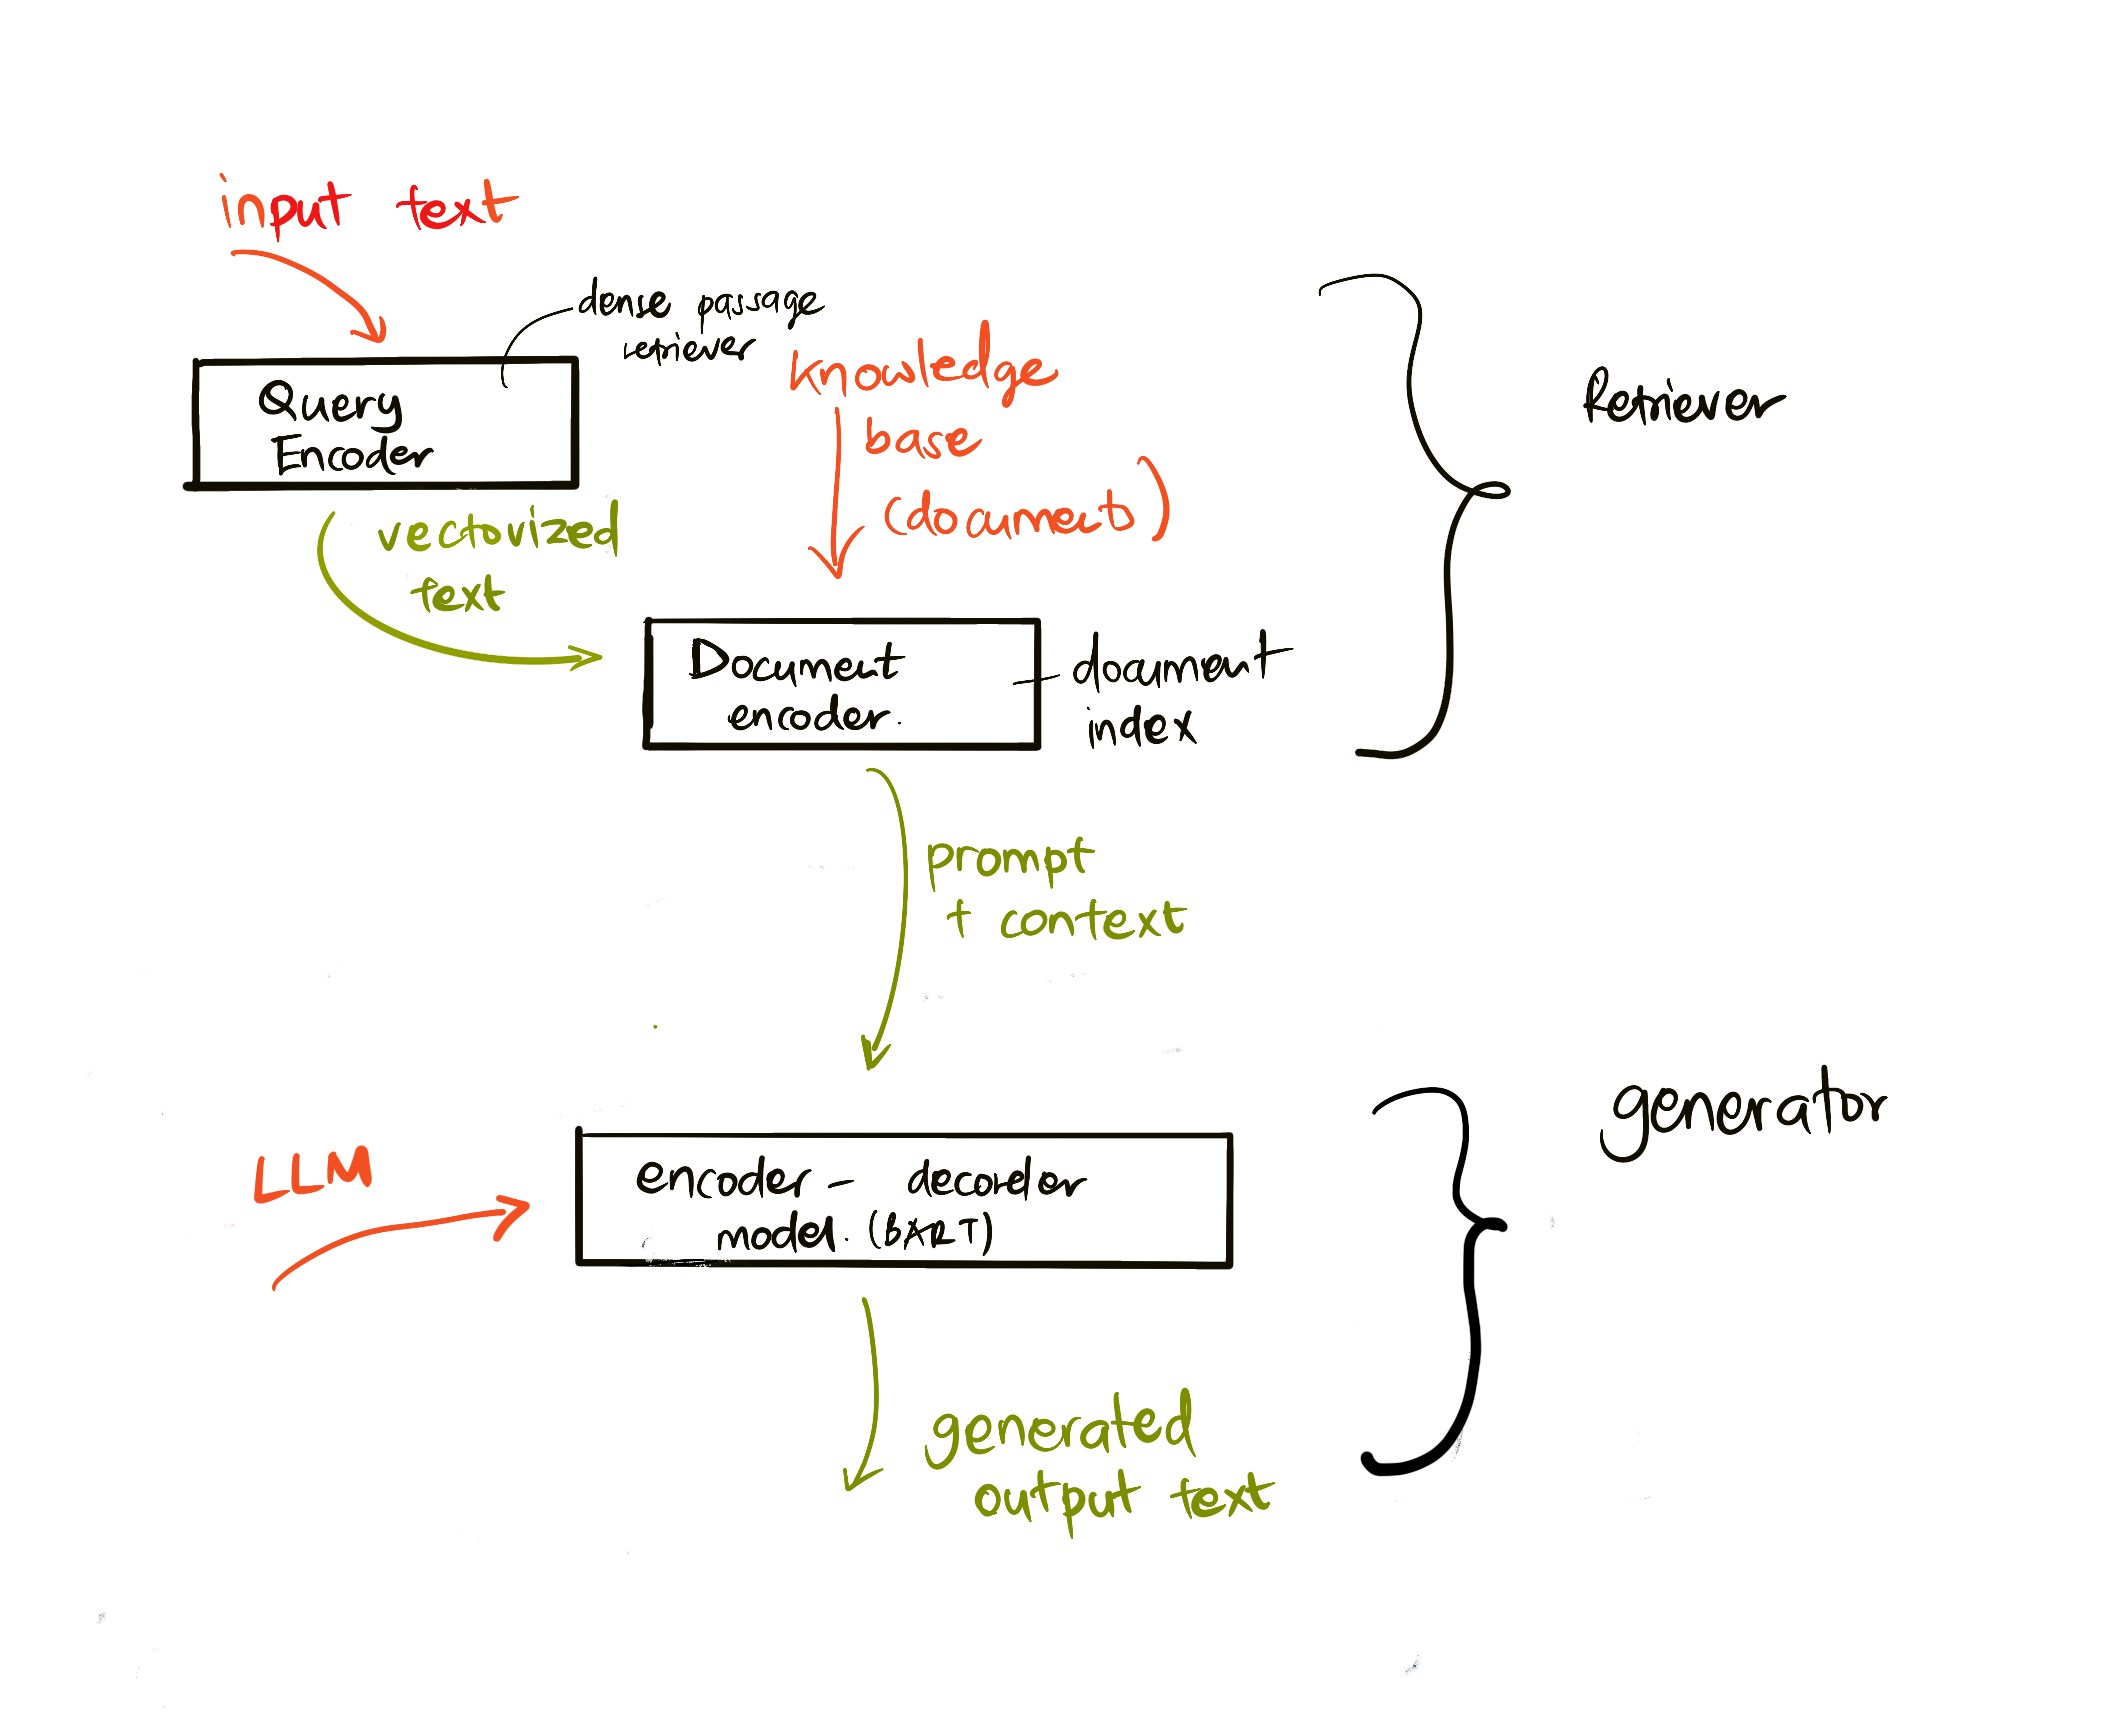
ایدهی RAG در مقالهای پژوهشی با عنوان Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks معرفی شد. معماری پیشنهادی آن دو بخش دارد: بازیاب (Retriever) که اسناد مرتبط را پیدا میکند و تولیدکننده (Generator) که پاسخ را میسازد.
مقاله دو رویکرد را مقایسه میکند. در RAG-Sequence، مدل برای کل پاسخ از یک مجموعه سند بازیابیشده استفاده میکند. در RAG-Token، مدل میتواند برای تولید هر بخش از پاسخ به سند متفاوتی تکیه کند. در پیادهسازیهای امروزی، رویکرد سادهی «بازیابی و بعد تولید» رایجتر است.
چرا RAG؟
مزیت اول، پاسخ بهروز و تخصصی است. مدل به دانشی دسترسی پیدا میکند که در آموزشش نبوده است. مزیت دوم، کاهش پاسخهای ساختگی است؛ چون مدل دادهی قابلبررسی در اختیار دارد و میتوانید منبع هر پاسخ را هم نشان دهید.
مزیت سوم هزینه است. برای بهروزکردن دانش دستیار کافی است اسناد را عوض کنید؛ دیگر لازم نیست مدل را دوباره آموزش دهید. در مقایسه با فاینتیون، این روش بسیار ارزانتر و سریعتر است.
ساخت پایگاه دانش
اولین قدم عملی، آمادهکردن اسناد برای جستجوست. این مرحله فقط یک بار، یا هر بار که اسناد تغییر میکنند، اجرا میشود. کیفیت کل سیستم تا حد زیادی به همین مرحله بستگی دارد.
چرا پایگاه داده برداری؟
پایگاه دادهی برداری برای ذخیره، مدیریت و جستجوی بردارها طراحی شده است. شاید بپرسید چرا کل اسناد را یکجا به مدل ندهیم. دلیلش محدودیت طول ورودی و هزینه است. مدل سقف مشخصی برای تعداد توکن ورودی دارد و هر توکن هم هزینه دارد.
پس اسناد را قطعهقطعه ذخیره میکنیم و در هر پرسش فقط چند قطعهی مرتبط را به مدل میدهیم. گزینههای رایج Azure Cosmos DB، Pinecone، Chroma، Qdrant و Weaviate هستند. برای شروع، حتی یک فایل ساده هم کافی است.
از متن تا بردار
قطعهبندی را میتوان در سطح جمله یا پاراگراف انجام داد. چون معنای هر قطعه به متن اطرافش هم بستگی دارد، افزودن زمینه به هر قطعه کمک میکند. مثلاً عنوان سند یا تیتر بخش را ابتدای قطعه بیاورید.
بعد از قطعهبندی، هر قطعه با یک مدل Embedding به بردار تبدیل میشود. انتخاب مدل به زبان متن، نوع محتوا، حداکثر طول ورودی و طول بردار خروجی بستگی دارد. برای متن فارسی، حتماً مدلی چندزبانه انتخاب کنید و نتیجه را روی چند پرسش واقعی بسنجید.
بازیابی؛ پیدا کردن قطعههای مرتبط
وقتی کاربر سؤال میپرسد، بازیاب پرسش را به بردار تبدیل میکند و در شاخص اسناد دنبال نزدیکترین بردارها میگردد. هدف این مرحله پیدا کردن متنهایی است که پاسخ را به دادههای خودتان متکی کنند.
جستجوی کلمهای، برداری و ترکیبی
سه روش اصلی برای بازیابی وجود دارد. جستجوی کلمهای دنبال همان کلمههای پرسش میگردد. جستجوی برداری بر اساس معنا کار میکند. جستجوی ترکیبی (Hybrid) هر دو را با هم به کار میبرد.
جستجوی ترکیبی معمولاً بهترین نتیجه را میدهد. جستجوی برداری منظور کلی را پیدا میکند و جستجوی کلمهای روی نامهای خاص، کدها و اصطلاحات دقیق قویتر است. درسنامه هم از همین روش استفاده میکند.
وقتی جواب در اسناد نیست
یک چالش مهم این است که شاید هیچ سند مرتبطی وجود نداشته باشد. در این حالت، بازیاب باز هم نزدیکترین قطعهها را برمیگرداند؛ حتی اگر بیربط باشند. مدل هم ممکن است با همان قطعههای بیربط جوابی سرهم کند.
برای جلوگیری از این مشکل، یک حداقل شباهت تعیین کنید و قطعههای پایینتر از آن را کنار بگذارید. در پیام سیستمی هم بنویسید که اگر پاسخ در متنها نبود، مدل صادقانه بگوید اطلاعات کافی ندارد.
بازچینی نتایج
بعد از بازیابی، ترتیب نتایج همیشه بهترین ترتیب نیست. بازچینی (Re-ranking) یعنی نتایج را با یک مدل دقیقتر دوباره مرتب کنیم تا مرتبطترین قطعهها بالا بیایند. سرویسهایی مثل Azure AI Search این کار را خودکار انجام میدهند.
شباهت کسینوسی رایجترین معیار سنجش نزدیکی است، اما تنها گزینه نیست. فاصلهی اقلیدسی و ضرب داخلی هم استفاده میشوند. برای بیشتر پروژهها، شروع با کسینوسی و افزودن بازچینی در صورت نیاز کافی است.
این دو جزء، یعنی بازیاب و تولیدکننده، در طرح معماری زیر کنار هم آمدهاند.
کنار هم گذاشتن همهچیز در یک دستیار RAG
حالا همهی قطعهها را به هم وصل میکنیم. تابع زیر پرسش را میگیرد، سه قطعهی مرتبط را پیدا میکند و آنها را همراه پرسش به مدل میدهد. فرض کردهایم chunks فهرست قطعهها و index ماتریس بردارهای آنهاست:
import numpy as np
from openai import OpenAI
client = OpenAI()
def embed(text):
return np.array(client.embeddings.create(model="text-embedding-3-small", input=[text]).data[0].embedding)
def answer(question, chunks, index, top_k=3, min_score=0.3):
q = embed(question)
scores = index @ q / (np.linalg.norm(index, axis=1) * np.linalg.norm(q))
best = [chunks[i] for i in scores.argsort()[::-1][:top_k] if scores[i] >= min_score]
context = "\n\n---\n\n".join(best) or "هیچ متن مرتبطی پیدا نشد."
response = client.responses.create(
model="gpt-5-mini",
input=[
{"role": "system", "content": "فقط بر اساس متنهای دادهشده پاسخ بده. اگر جواب در متنها نیست، بگو اطلاعات کافی ندارم."},
{"role": "user", "content": f"متنها:\n{context}\n\nپرسش: {question}"},
],
max_output_tokens=800,
store=False,
)
return response.output_textبه دو جزئیات دقت کنید. پارامتر min_score قطعههای کمارتباط را حذف میکند و پیام سیستمی به مدل اجازه میدهد بگوید جواب را نمیداند. همین دو خط، کیفیت دستیار را بیشتر از هر تنظیم پیچیدهای بالا میبرند.
ارزیابی و کاربردهای RAG
دستیار RAG مثل هر برنامهی دیگری باید سنجیده شود. چهار معیار اصلی اینهاست:
- کیفیت پاسخ: طبیعی، روان و قابلفهم باشد.
- اتکا به منبع (Groundedness): پاسخ واقعاً از اسناد بازیابیشده آمده باشد، نه از تخیل مدل.
- ارتباط: پاسخ دقیقاً به همان پرسش مربوط باشد.
- روانی زبانی: از نظر دستوری درست و خوانا باشد.
کاربردهای RAG گسترده است: پرسش و پاسخ از روی مستندات سازمان، سیستم پیشنهاد فیلم یا رستوران بر اساس شباهت، چتبات شخصیسازیشده با تاریخچهی کاربر و حتی جستجوی تصویر. فریمورکهایی مثل LangChain، Semantic Kernel و AutoGen ساخت این سیستمها را سریعتر میکنند.
تمرین عملی؛ دستیار دورهها با RAG
دستیار پروژهی مشترک را به اسناد واقعی وصل کنید. توضیح کامل چند دوره، شامل سرفصلها، پیشنیازها و مدت، را در یک فایل متنی بنویسید. بعد این مراحل را انجام دهید:
- متن را بر اساس دوره و سرفصل قطعهبندی کنید و نام دوره را ابتدای هر قطعه بیاورید.
- با تابع
embedبرای همهی قطعهها بردار بسازید و ذخیره کنید. - تابع
answerرا با پنج پرسش آزمایش کنید؛ دستکم یکی از پرسشها جوابی در اسناد نداشته باشد.
بررسی کنید آیا دستیار برای پرسش بیجواب صادقانه میگوید اطلاعات کافی ندارد. اگر جواب سرهم کرد، min_score را بالاتر ببرید یا پیام سیستمی را سختگیرانهتر کنید.
سخن پایانی
اگر بخواهیم در یک جمله بگوییم RAG چیست: جستجو قبل از پاسخ. برنامه اول متنهای مرتبط را از اسناد شما پیدا میکند و بعد از مدل میخواهد فقط بر اساس همانها جواب دهد. قطعهبندی درست، بازیابی ترکیبی، حداقل شباهت و یک پیام سیستمی صادق، چهار ستون یک دستیار RAG قابلاعتمادند.
در قسمت هفتم یاد میگیریم مدل چطور میتواند بهجای متن، تابعهای واقعی برنامه را فراخوانی کند و با دادههای زنده کار کند.
این آموزش بر پایهی درس Retrieval Augmented Generation (RAG) and Vector Databases از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
RAG چیست به زبان ساده؟
RAG یعنی قبل از اینکه مدل زبانی جواب بدهد، برنامه متنهای مرتبط را از اسناد شما پیدا میکند و همراه سؤال به مدل میدهد. مدل پاسخ را بر اساس همان متنها مینویسد، نه فقط دانستههای قبلیاش.
RAG بهتر است یا فاینتیون؟
برای پاسخگویی از روی اطلاعاتی که مرتب تغییر میکند، RAG ارزانتر و سادهتر است و منبع پاسخ هم قابل ردیابی است. فاینتیون بیشتر برای تغییر سبک، قالب یا مهارت مدل در یک کار تخصصی به کار میآید.
آیا RAG جلوی جوابهای ساختگی را کاملاً میگیرد؟
نه، اما آن را بهطور محسوسی کم میکند. برای نتیجهی بهتر در پیام سیستمی بخواهید مدل فقط بر اساس متنهای بازیابیشده پاسخ دهد و اگر جواب در آنها نبود، صادقانه بگوید.
برای RAG به چه ابزارهایی نیاز دارم؟
یک مدل Embedding برای ساخت بردار، یک محل ذخیرهی بردارها مثل فایل ساده یا پایگاه داده برداری، و یک مدل زبانی برای تولید پاسخ. فریمورکهایی مثل LangChain و Semantic Kernel این اجزا را سریعتر کنار هم میگذارند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.