
تأیید انسانی در ایجنت ساده به نظر میرسد؛ یک دکمهی «تأیید» پیش از هر اقدام مهم. اما این دکمه فقط وقتی مفید است که کاربر بداند دقیقاً چه کاری را تأیید میکند. پیام مبهمی مثل «ادامه بدهم؟» برای اقدامی که داده یا وضعیت سیستم را تغییر میدهد کافی نیست.
در این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز، ساخت ایجنت قابلاعتماد را از سه زاویه بررسی میکنیم: پیام سیستمی ساختاریافته، شناخت تهدیدها و طراحی دقیق تأیید انسانی. در پایان جریانی میسازیم که مدرس پیشنویسهای بازخورد را بازبینی کند و فقط همان نسخهی تأییدشده، فقط یک بار، ارسال شود.
ایمنی ایجنت از پیام سیستمی شروع میشود
ایمنی یعنی ایجنت همانطور که طراحی شده رفتار کند. اولین ابزار ما برای این کار، پیام سیستمی است. در هر برنامهی مبتنی بر مدل زبانی، پیام سیستمی قواعد و مرزها را تعیین میکند. برای ایجنتها این پیام مهمتر هم هست، چون ایجنت برای انجام کار به دستورالعملهای بسیار دقیق نیاز دارد.
چارچوب پیام سیستمی
مایکروسافت یک چارچوب چهارمرحلهای برای ساخت پیام سیستمی پیشنهاد میکند. در مرحلهی اول یک «پیام فرا-سیستمی» مینویسید؛ دستوری که به مدل میگوید چطور برای ایجنتها پیام سیستمی بسازد. این پیام قالبی است که برای ایجنتهای مختلف تکرار میشود.
در مرحلهی دوم یک توصیف پایه برای ایجنت مینویسید؛ نقش، وظایف و مسئولیتهایش. مثلاً «تو دستیار مشاورهی دورههای یک آموزشگاه هستی که دوره پیشنهاد میدهی، به پرسشها پاسخ میدهی و درخواست ثبتنام را برای تأیید آماده میکنی».
از توصیف پایه تا پیام کامل
در مرحلهی سوم، پیام فرا-سیستمی و توصیف پایه را به مدل میدهید. خروجی یک پیام سیستمی ساختاریافته و کامل است؛ با بخشهای نام سازمان، نقش، هدف، مسئولیتها، لحن و دستورالعمل تعامل. این ساختار برای مدل روشنتر از یک پاراگراف آزاد است.
مرحلهی چهارم تکرار و بهبود است. ارزش این چارچوب این است که پیام سیستمی چند ایجنت را یکدست و قابل نگهداری میکند. هر بار که رفتار ناخواستهای دیدید، توصیف پایه را اصلاح و پیام را دوباره تولید کنید. یک نکته را هم فراموش نکنید: مرز اختیار را صریح در پیام بنویسید؛ مثلاً «هیچ اقدام تغییردهندهای را بدون تأیید صریح کاربر انجام نده».
تهدیدهای ایجنت هوش مصنوعی
برای ساخت ایجنت قابلاعتماد، باید تهدیدها را بشناسید. ایجنت با ابزار و داده کار میکند؛ پس سطح حملهاش از یک چتبات ساده بزرگتر است. پنج تهدید اصلی را مرور میکنیم.
تغییر دستورالعمل و دسترسی بیش از حد
در تهدید اول، مهاجم با ورودی دستکاریشده تلاش میکند دستورالعمل یا هدف ایجنت را عوض کند. راه دفاع، اعتبارسنجی و فیلتر ورودی پیش از رسیدن به ایجنت است. محدود کردن تعداد نوبتهای گفتوگو هم جلوی تلاشهای پیاپی را میگیرد.
در تهدید دوم، ایجنتی که به سیستمهای حساس دسترسی دارد، راهی برای مهاجم میشود. راه دفاع این است که ایجنت فقط وقتی لازم است و فقط به همان بخشی که لازم است دسترسی داشته باشد. ارتباط ایجنت با این سیستمها هم باید امن و محدود باشد.
بارگذاری بیش از حد، مسمومسازی و خطای زنجیرهای
مهاجم ممکن است از توانایی ایجنت برای فراخوانی سرویسها سوءاستفاده کند و با درخواستهای زیاد سرویس را از کار بیندازد. سقف تعداد درخواست ایجنت به هر سرویس، سادهترین دفاع است.
مسمومسازی پایگاه دانش مستقیم ایجنت را هدف نمیگیرد؛ دادهای را که ایجنت از آن استفاده میکند آلوده میکند. بازبینی منظم داده و محدود کردن دسترسی نوشتن به آن، دفاع اصلی است. خطای زنجیرهای هم وقتی رخ میدهد که خطای یک ابزار به کل سیستم سرایت کند. اجرای ایجنت در محیطی محدود، مثل کانتینر، و داشتن رفتار جایگزین برای خطا، جلوی این سرایت را میگیرد.
جدول زیر پنج تهدید و دفاع اصلی هر کدام را خلاصه میکند.
| تهدید | نمونه | دفاع اصلی |
|---|---|---|
| تغییر دستورالعمل | «دستورهای قبلی را نادیده بگیر» | فیلتر ورودی و سقف نوبت گفتوگو |
| دسترسی بیش از حد | ایجنت به کل پایگاه داده دسترسی دارد | کمترین دسترسی لازم |
| بارگذاری بیش از حد | صدها فراخوانی پیاپی یک سرویس | سقف درخواست |
| مسمومسازی دانش | سند جعلی در پایگاه دانش | بازبینی داده و محدودیت نوشتن |
| خطای زنجیرهای | خرابی یک ابزار کل جریان را متوقف میکند | اجرای محدود و رفتار جایگزین |
انسان در حلقه
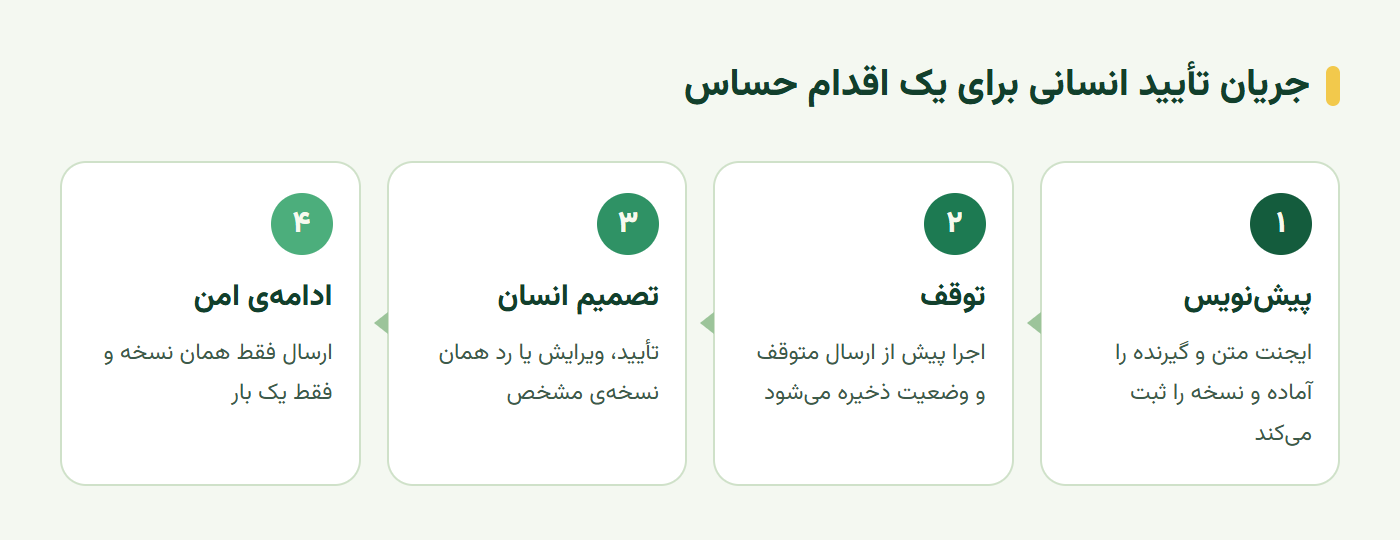
یکی از مؤثرترین روشهای ساخت ایجنت قابلاعتماد، انسان در حلقه (Human-in-the-Loop) است. در این روش، ایجنت در نقطههای مشخصی متوقف میشود و انسان نتیجه را بازبینی میکند. انسان میتواند تأیید، ویرایش یا رد کند و ایجنت بر اساس همان تصمیم ادامه میدهد.
تأیید باید دقیق باشد
سادهترین پیادهسازی این است که ایجنت خروجی را نشان دهد و بپرسد «تأیید میکنید؟». اما این کافی نیست. تأیید خوب سه چیز را به کاربر نشان میدهد: اقدام دقیق، دادهی دقیق و پیامد آن. مثلاً «این پیام با این متن کامل برای این دانشجو با این ایمیل فرستاده میشود».
تأیید هم باید به همان نسخهی مشخص گره بخورد. اگر پس از تأیید، ایجنت متن را کمی ویرایش کند، آن تأیید دیگر معتبر نیست. نمودار زیر جریان کامل تأیید را نشان میدهد.
ذخیرهی وضعیت هنگام توقف
توقف برای تأیید ممکن است چند ساعت یا چند روز طول بکشد. مدرس شاید فردا صبح پیشنویسها را ببیند. پس ایجنت نمیتواند منتظر بماند؛ باید وضعیت کارش را ذخیره کند و بعد از تأیید، از همان نقطه ادامه دهد.
فریمورکهایی مثل LangGraph این قابلیت را آماده دارند؛ گراف را در نقطهی مشخصی متوقف و وضعیت را ذخیره میکنند. در پیادهسازی ساده هم میتوانید پیشنویس و وضعیتش را در پایگاه داده نگه دارید.
پیادهسازی تأیید نسخهی مشخص
کد زیر هستهی یک جریان تأیید امن است. هنگام تأیید، اثر انگشت محتوا ثبت میشود. هنگام ارسال، هم اثر انگشت و هم وضعیت ارسال بررسی میشود:
import hashlib

def fingerprint(draft: dict) -> str:
    return hashlib.sha256(f"{draft['to']}|{draft['body']}".encode()).hexdigest()

def approve(draft: dict, reviewer: str) -> None:
    draft["approved_hash"] = fingerprint(draft)
    draft["approved_by"] = reviewer
    draft["status"] = "approved"

def send_if_approved(draft: dict, send_email) -> str:
    if draft.get("status") == "sent":
        return "already_sent"          # جلوگیری از ارسال دوباره
    if draft.get("status") != "approved" or draft.get("approved_hash") != fingerprint(draft):
        return "needs_approval"        # متن یا گیرنده پس از تأیید عوض شده
    send_email(draft["to"], draft["body"], idempotency_key=draft["approved_hash"])
    draft["status"] = "sent"
    return "sent"
دو محافظ مهم در این کد هست. اگر متن یا گیرنده پس از تأیید حتی یک کاراکتر تغییر کند، اثر انگشت عوض میشود و ارسال متوقف میشود. وضعیت sent و کلید یکتایی ارسال هم جلوی ارسال دوباره را میگیرند؛ حتی اگر ایجنت پس از یک خطای شبکه دوباره تلاش کند.
چرا ارسال دوباره خطرناک است؟
ایجنتها در برابر خطا دوباره تلاش میکنند؛ این رفتار معمولاً خوب است. اما فرض کنید ایمیل فرستاده شده، ولی پاسخ سرویس به دلیل قطع شبکه نرسیده است. ایجنت فکر میکند ارسال شکست خورده و دوباره میفرستد. دانشجو دو ایمیل یکسان میگیرد؛ یا بدتر، دو بار از حسابش پول کم میشود.
کلید یکتایی (Idempotency Key) این مشکل را حل میکند. سرویس ارسال با دیدن کلید تکراری، درخواست دوم را نادیده میگیرد. بسیاری از سرویسهای پرداخت و پیام این قابلیت را پشتیبانی میکنند. اگر سرویس شما پشتیبانی نمیکند، وضعیت ارسال را پیش از فراخوانی ثبت کنید.
سناریوی عملی؛ بازبینی بازخورد تکالیف
مدرس چند پیشنویس بازخورد را که ایجنت آماده کرده بررسی میکند. بعضی را تأیید، بعضی را ویرایش و بعضی را رد میکند. فقط پیشنویسهای تأییدشده باید برای دانشجوها فرستاده شوند.
ورودی و معیار پذیرش
ورودی آزمون متن بازخورد، گیرندهی مشخص و نسخهی پیشنویس است. یک نمونهی ناقص هم بگذارید؛ مثلاً پیشنویسی که گیرندهاش مشخص نیست. اقدام مورد بررسی، توقف پیش از ارسال و ادامه فقط برای همان نسخهی تأییدشده است.
معیار پذیرش دو بخش دارد. متن و گیرندهی ارسالشده دقیقاً با تصمیم مدرس مطابقت داشته باشد. و نتیجهی هر ارسال ثبت شود؛ چه کسی تأیید کرد، کی و چه چیزی فرستاده شد.
دو شکست که باید بازسازی کنید
شکست اول، تغییر متن بعد از تأیید است. ایجنت پس از تأیید مدرس، «برای بهتر شدن» یک جمله را عوض میکند و نسخهی تأییدنشده فرستاده میشود. با کد بالا، این ارسال باید متوقف شود.
شکست دوم، ارسال دوباره پس از تلاش مجدد است. خطای شبکه را شبیهسازی کنید و ببینید آیا دانشجو دو ایمیل میگیرد. هر دو نمونه را در آزمون بگذارید و نتیجهی مورد انتظار را پیش از اجرا بنویسید.
تمرین عملی؛ جریان بازبینی انسانی
خروجی این تمرین یک جریان بازبینی با تصمیم روشن برای هر پیام است:
- سه پیشنویس بازخورد بسازید و برای هر کدام تصمیم مدرس را ثبت کنید: تأیید، ویرایش یا رد.
- تابعهای
approveوsend_if_approvedرا پیاده کنید و ارسال را با یک تابع ساختگی آزمایش کنید. - دو شکست بالا را بازسازی کنید و مطمئن شوید هر دو متوقف میشوند.
مشخص کنید کدام بخش را واقعاً اجرا کردهاید و کدام هنوز فرض است.
سخن پایانی
تأیید انسانی در ایجنت یک دکمه نیست؛ یک طراحی است. پیام سیستمی ساختاریافته مرزها را تعیین میکند، شناخت تهدیدها سطح حمله را کوچک میکند و انسان در حلقه آخرین سد دفاعی پیش از اقدامهای حساس است. تأیید درست اقدام و دادهی دقیق را نشان میدهد، به نسخهی مشخصی گره میخورد و با کلید یکتایی جلوی ارسال دوباره را میگیرد. چنین ایجنتی را میتوان با خیال راحت به کاربران واقعی سپرد.
در قسمت بعد برنامهریزی کارهای چندمرحلهای را میبینیم؛ ساخت برنامهی مطالعهای که واقعاً قابل اجرا باشد.
این آموزش بر پایهی درس Building Trustworthy AI Agents از مجموعهی آزاد AI Agents for Beginners و درس امنیت برنامههای هوش مصنوعی مولد مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
انسان در حلقه یعنی چه؟
یعنی ایجنت در نقطههای مشخصی از کار، بهویژه پیش از اقدامهای حساس، متوقف شود و منتظر تصمیم انسان بماند. انسان میتواند نتیجه را تأیید، ویرایش یا رد کند و ایجنت بر اساس همان تصمیم ادامه دهد.
چرا پیام «ادامه بدهم؟» برای تأیید کافی نیست؟
چون کاربر نمیداند دقیقاً چه چیزی را تأیید میکند. تأیید درست باید اقدام، دادهی دقیق و پیامد آن را نشان دهد؛ مثلاً متن کامل پیام و گیرندهی آن، نه یک سؤال کلی.
چطور مطمئن شویم پس از تأیید متن تغییر نکرده است؟
هنگام تأیید، یک شناسه یا اثر انگشت از محتوای دقیق پیام ثبت کنید و پیش از ارسال دوباره آن را مقایسه کنید. اگر محتوا حتی یک کلمه تغییر کرده باشد، تأیید معتبر نیست و باید دوباره گرفته شود.
مهمترین تهدیدهای ایجنت هوش مصنوعی کداماند؟
تغییر دستورالعمل با ورودی دستکاریشده، دسترسی بیش از حد به سیستمهای حیاتی، بارگذاری بیش از حد سرویسها، مسمومسازی پایگاه دانش و خطاهای زنجیرهای که از یک ابزار به کل سیستم سرایت میکنند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.