
مدیریت شکست در Agentic RAG وقتی اهمیت پیدا میکند که پرسشها پیچیده میشوند. بعضی پرسشها با یک جستجو جواب نمیگیرند. کاربر ممکن است هم پیشنیاز یک دوره را بخواهد و هم بداند آیا با برنامهی زمانیاش سازگار است. ایجنت میتواند این پرسش را به چند جستجوی کوچکتر تقسیم کند؛ اما همین آزادی دو خطر تازه هم میآورد.
در قسمت پانزدهم با Agentic RAG در smolagents آشنا شدیم. این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز روی دیگر سکه را نشان میدهد. وقتی جستجو شکست میخورد چه باید کرد؟ ایجنت کی باید دوباره تلاش کند، کی باید متوقف شود و کی باید کار را به انسان بسپارد؟
Agentic RAG؛ مالکیت فرایند استدلال
Agentic RAG الگویی است که در آن مدل زبانی مراحل بعدی خودش را برنامهریزی میکند. در همین مسیر هم از منابع بیرونی اطلاعات میگیرد. برخلاف RAG ایستای «بازیابی و بعد خواندن»، ایجنت چند بار مدل را صدا میزند. سپس میان فراخوانی ابزار و خروجی ساختاریافته رفتوبرگشت دارد.
به بیان ساده، RAG معمولی مثل کتابداری است که با یک بار جستجو در فهرست، چند کتاب را روی میز شما میگذارد. Agentic RAG اما مثل پژوهشگری است که کتابها را ورق میزند و اگر جواب نبود، عنوان دیگری را جستجو میکند. مرز این تشبیه همان موضوع این مقاله است؛ پژوهشگر انسانی خودش میفهمد کی دست بکشد، ولی ایجنت این حس را ندارد و بدون سقف، میتواند بیپایان جستجو کند.
ویژگی اصلی که یک سیستم را «ایجنتی» میکند، مالکیت فرایند استدلال است. در RAG سنتی، انسان مسیر را از پیش تعیین میکند: چه چیزی جستجو شود و کی. اما در Agentic RAG، سیستم خودش تصمیم میگیرد مسئله را چطور حل کند. برای مثال پرسشهای ناموفق را بازنویسی میکند، روش بازیابی دیگری برمیگزیند و چند ابزار را کنار هم به کار میبرد.
مثالی از استدلال مستقل
فرض کنید از چنین سیستمی بخواهید راهبرد عرضهی یک محصول را آماده کند. بهجای اجرای یک پرامپت ثابت، ممکن است خودش تصمیم بگیرد ابتدا گزارشهای روند بازار را از وب بگیرد. سپس دادهی رقبا را از پایگاه دانش جستجو کند.
در قدم بعد شاخصهای فروش داخلی را از پایگاه داده بخواند و یافتهها را در یک راهبرد منسجم ترکیب کند. در پایان هم راهبرد را از نظر کاستی بسنجد. اگر کاستی دید، یک دور دیگر بازیابی انجام دهد. همهی این تصمیمها را مدل میگیرد، نه برنامهنویس.
بیشتر بخوانید: پیادهسازی پایهی Agentic RAG با smolagents و هفت راهبرد بازیابی پیشرفته را در Agentic RAG چیست؟ دیدهایم.
حلقهی Agentic RAG
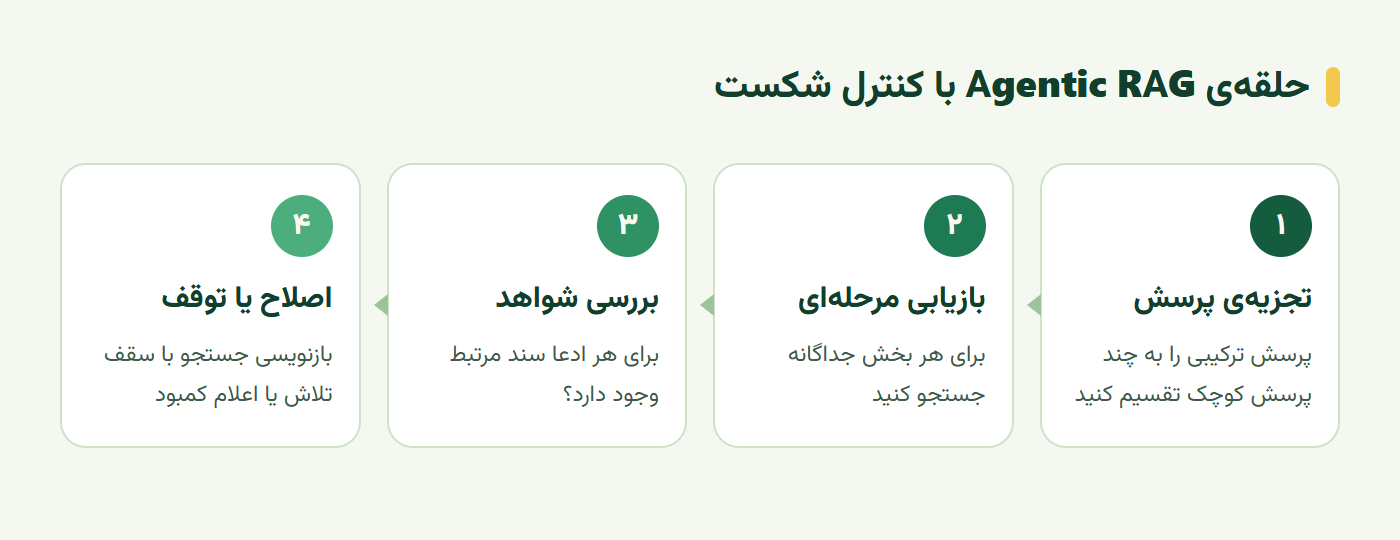
Agentic RAG بر یک الگوی حلقهای تکیه دارد. هدف کاربر به مدل داده میشود. اگر مدل کمبود اطلاعات یا دستور مبهم تشخیص دهد، ابزاری را صدا میزند. مثلاً جستجوی ترکیبی در پایگاه برداری (پایگاهی که متنها را به شکل بردار عددی نگه میدارد) یا پرسوجو از پایگاه داده. بعد دادهی برگشتی را ارزیابی میکند.
اگر اطلاعات کافی نبود، پرسش را اصلاح میکند، ابزار دیگری را امتحان میکند یا رویکردش را تغییر میدهد. این چرخه تا وقتی ادامه دارد که مدل شواهد کافی برای پاسخ مستند داشته باشد. همچنین حافظه در این حلقه نقش مهمی دارد. ایجنت تلاشهای قبلی و نتایجشان را به خاطر میسپارد تا در چرخهی تکراری گیر نکند.
حلقهی سازنده و بازرس
این سبک را گاهی الگوی «سازنده و بازرس» مینامند. یک مرحله پاسخ یا پرسوجو میسازد و مرحلهی دیگر آن را بررسی میکند. این رفتوبرگشت دقت را بالا میبرد. اثرش بهخصوص در پایگاه دادهی ساختاریافته روشن است، زیرا یک پرسوجوی SQL نادرست ممکن است نتیجهی خالی یا اشتباه بدهد.
نمودار زیر حلقهای را نشان میدهد که در این مقاله میسازیم؛ با دو نقطهی کنترل برای مدیریت شکست.
مدیریت شکست در Agentic RAG
خودمختاری Agentic RAG با سازوکارهای اصلاح خودکار همراه است. وقتی سیستم به بنبست میرسد، مثلاً اسناد نامرتبط بازیابی میکند یا با پرسش بدشکل روبهرو میشود، سه راه دارد.
سه راه برای برخورد با بنبست
راه اول تکرار و پرسش دوباره است. بهجای پاسخ کمارزش، مدل راهبرد جستجوی تازهای امتحان میکند. همچنین ممکن است پرسوجو را بازنویسی کند یا منبع دیگری را بگردد. راه دوم استفاده از ابزارهای تشخیصی است. این ابزارها کمک میکنند مراحل استدلال بررسی و درستی داده تأیید شود.
راه سوم اتکا به انسان است. در موقعیتهای حساس یا پس از چند شکست پیاپی، مدل باید عدم قطعیت را اعلام کند و راهنمایی بخواهد. پس از دریافت بازخورد انسانی، میتواند آن درس را در ادامه به کار ببرد.
دو شکست که باید کنترل شوند
آزادی ایجنت دو شکست تازه ایجاد میکند. اولی تکرار بیپایان است. ایجنت مدام جستجو را بازنویسی میکند و هر بار نتیجهی کمی متفاوت اما ناکافی میگیرد. بدون سقف تلاش، این حلقه هزینه و زمان را بالا میبرد و در نهایت هم پاسخی نمیدهد.
شکست دوم نتیجهگیری از سند نامرتبط است. پس از چند جستجوی ناموفق، ایجنت به نزدیکترین سندی که پیدا کرده بسنده میکند. حتی اگر آن سند دربارهی دورهی دیگری باشد. در نتیجه پاسخ روان به نظر میرسد، اما شواهدش اشتباه است.
پیادهسازی حلقه با کنترل شکست
کد زیر یک حلقهی سادهی Agentic RAG برای مقایسهی دو دوره است. به دو نقطهی کنترل دقت کنید: سقف جستجو و بررسی شواهد. تابعهای search، rewrite و is_relevant را ایجنت یا کد شما پیاده میکند:
MAX_SEARCHES = 4
def answer_comparison(question, parts, search, rewrite, is_relevant):
evidence, searches = {}, 0
for part in parts: # مثلاً «پیشنیاز دورهی الف»، «مدت دورهی ب»
query = part
while searches < MAX_SEARCHES:
searches += 1
docs = [d for d in search(query) if is_relevant(part, d)]
if docs:
evidence[part] = docs
break
query = rewrite(part, query) # بازنویسی و تلاش دوباره
missing = [p for p in parts if p not in evidence]
if missing:
return {"status": "needs_human", "missing": missing, "found": evidence}
return {"status": "ok", "evidence": evidence}سقف MAX_SEARCHES برای کل پرسش است، نه برای هر بخش. این کار جلوی حلقهی بیپایان را میگیرد. تابع is_relevant هم هر سند را پیش از استفاده میسنجد؛ آیا واقعاً به همین بخش از پرسش مربوط است؟ اگر بخشی بدون شواهد ماند، خروجی بهجای پاسخ ساختگی، وضعیت «نیاز به انسان» و فهرست بخشهای ناقص را برمیگرداند.
سنجش ارتباط سند
is_relevant را میتوان به چند شکل پیاده کرد. سادهترین راه، حداقل شباهت برداری است؛ همان کاری که در قسمت RAG کردیم. راه دقیقتر، پرسیدن از یک مدل کوچک است: «آیا این سند به این پرسش مشخص پاسخ میدهد؟ فقط بله یا خیر».
در پرسشهای مقایسهای، یک بررسی دیگر هم لازم است؛ اینکه سند به همان دورهی مورد نظر مربوط باشد. سندی دربارهی پیشنیازهای «پایتون مقدماتی» برای پرسش دربارهی «پایتون پیشرفته» مرتبط به نظر میرسد، اما شاهد درستی نیست. اگر اسناد شما فراداده (metadata؛ اطلاعات کنار متن مثل نام دوره) دارند، سادهترین نسخه این است:
def is_relevant(part, doc, min_score=0.75):
    # doc نمونه: {"course": "پایتون پیشرفته", "text": "...", "score": 0.82}
    return doc["course"] in part and doc["score"] >= min_score
عدد ۰٫۷۵ نمونه فرضی است؛ آستانهی واقعی را با چند پرسش آزمون روی اسناد خودتان تنظیم کنید. شرط اول جلوی سند دورهی مشابه را میگیرد و شرط دوم جلوی سند کمربط را.
مرزها، حاکمیت و اعتماد
با وجود همهی این خودمختاری، Agentic RAG معادل هوش مصنوعی عمومی نیست. تواناییهایش به ابزارها، منابع داده و سیاستهایی محدود است که توسعهدهنده در اختیارش گذاشته است. نمیتواند خودش ابزار تازه بسازد یا از مرز حوزهاش بیرون برود.
کجا Agentic RAG میدرخشد؟
این رویکرد در موقعیتهایی ارزش دارد که دقت و اصلاح تکراری لازم است. برای مثال در بررسی انطباق با قوانین یا پژوهش حقوقی، درستی اولویت اول است. آنجا ایجنت میتواند حقایق را چند بار تأیید کند. همچنین در پرسوجوهای پیچیدهی پایگاه داده که اغلب شکست میخورند، میتواند پرسوجو را اصلاح کند.
در گردشهای کار طولانی هم ایجنت میتواند با آمدن اطلاعات تازه، راهبردش را بهروز کند. در مقابل، برای پرسشهای ساده و یکمرحلهای همان RAG معمولی سریعتر و ارزانتر است؛ چون هر دور اضافه یعنی یک فراخوانی دیگر به مدل.
شفافیت و نظارت انسانی
هرچه سیستم خودمختارتر شود، شفافیت مهمتر میشود. ایجنت باید بتواند مسیر کارش را نشان دهد. یعنی بگوید چه پرسشهایی جستجو کرد، به کدام منابع رفت و چطور به نتیجه رسید. بدون این رکورد، اشکالزدایی یک فرایند چندمرحلهای تقریباً غیرممکن است.
نظارت انسانی هم در کارهای حساس ضروری است. Agentic RAG جای قضاوت انسان را در تصمیمهای مهم نمیگیرد؛ گزینههای مستند و بررسیشده را پیش روی انسان میگذارد. جدول زیر نشان میدهد هر وضعیت چه خروجیای باید داشته باشد.
| وضعیت | نشانه | خروجی درست |
|---|---|---|
| شواهد کامل | برای همهی بخشها سند مرتبط پیدا شد | پاسخ همراه ارجاع برای هر بخش |
| شواهد ناقص | برخی بخشها بدون سند ماندند | پاسخ جزئی و اعلام بخشهای ناقص |
| رسیدن به سقف | تعداد جستجو تمام شد | توقف و ارجاع به انسان |
| تناقض منابع | دو سند اطلاعات متفاوت دارند | نمایش هر دو و درخواست تأیید |
| موضوع حساس | تصمیم پیامد جدی دارد | گزینههای مستند برای تصمیم انسان |
سناریوی عملی؛ مقایسهی دو دوره
کاربری میخواهد دو دوره را از نظر پیشنیاز، سرفصل و زمان لازم مقایسه کند. ورودی آزمون یک پرسش ترکیبی و اسناد جداگانهی هر دوره است. یک نمونهی ناقص هم بگذارید؛ مثلاً دورهای که سندش مدت دوره را ذکر نکرده است.
اقدام و معیار پذیرش
اقدام مورد بررسی سه مرحله دارد: بازیابی مرحلهای برای هر بخش پرسش، بررسی کمبود شواهد و ترکیب پاسخ همراه ارجاع. خروجی هر مرحله را جدا ثبت کنید تا مسیر بازیابی قابل بررسی باشد.
معیار پذیرش دو بخش دارد. برای هر بخش از مقایسه باید مدرکی وجود داشته باشد. و تعداد جستجوها محدود بماند. پاسخی که همهی بخشها را پوشش دهد اما برای یکی شاهد نداشته باشد، قبول نیست.
نمونهی شکست
دو شکست را عمداً بازسازی کنید. اول، پرسشی بسازید که پاسخش در اسناد نیست. سپس ببینید آیا ایجنت پس از سقف تلاش متوقف میشود یا در حلقه میماند. دوم، سند یک دورهی مشابه اما متفاوت را در اسناد بگذارید و ببینید آیا ایجنت از آن نتیجهگیری میکند.
نتیجهی مورد انتظار را پیش از اجرا بنویسید. اگر نسخهی جدیدی ظاهراً بهتر بود، همین دو نمونه را دوباره بسنجید.
تمرین عملی؛ پاسخ مقایسهای با مسیر بازیابی
خروجی این تمرین یک نمونه پاسخ مقایسهای است که مسیر بازیابیاش قابل بررسی باشد:
- حلقهی بالا را با تابع جستجوی قسمتهای قبل و یک
is_relevantساده پیاده کنید. - پرسش مقایسهی دو دوره را اجرا کنید و همهی جستجوها، بازنویسیها و اسناد پذیرفتهشده را ثبت کنید.
- دو نمونهی شکست را اجرا کنید و خروجی «نیاز به انسان» را بررسی کنید.
مشخص کنید کدام بخش را واقعاً اجرا کردهاید و کدام هنوز فرض است.
سخن پایانی
Agentic RAG مالکیت فرایند استدلال را به مدل میدهد؛ جستجو، ارزیابی، اصلاح و تکرار تا رسیدن به شواهد کافی. اما همین آزادی به کنترل نیاز دارد. مدیریت شکست در Agentic RAG با سه ابزار ساده ممکن میشود. نخست سقف تعداد جستجو، دوم بررسی صریح ارتباط هر سند با هر ادعا، و سوم ارجاع به انسان وقتی شواهد کافی نیست. ایجنتی که بداند کی متوقف شود، قابلاعتمادتر از ایجنتی است که همیشه جواب میدهد.
در قسمت بعد طراحی تأیید انسانی را میبینیم؛ توقف، بازبینی و ادامهی امن کار.
این آموزش بر پایهی درس Agentic RAG از مجموعهی آزاد AI Agents for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- RAG چیست؟: پایهی بازیابی و تولید پاسخ از روی اسناد؛ برای مبتدی.
- Agentic RAG چیست؟: پیادهسازی Agentic RAG با smolagents؛ پیشنیاز مستقیم این قسمت، برای متوسط.
- Agentic RAG در AI Agents for Beginners (انگلیسی): درس اصلی مایکروسافت که این آموزش بر پایهی آن است؛ برای متوسط.
- Building effective agents (انگلیسی): راهنمای Anthropic دربارهی حلقهی ارزیاب و بهینهساز، شرط توقف و سادگی طراحی؛ برای متوسط و پیشرفته.
- Corrective Retrieval Augmented Generation (انگلیسی): مقالهی پژوهشی دربارهی ارزیابی کیفیت اسناد بازیابیشده و اصلاح جستجو؛ برای پیشرفته.
پرسشهای پرتکرار
Agentic RAG چه فرقی با RAG معمولی دارد؟
در RAG معمولی مسیر بازیابی از پیش تعیین شده است. در Agentic RAG مدل خودش تصمیم میگیرد چه چیزی را جستجو کند، از کدام ابزار استفاده کند، آیا شواهد کافی است و آیا باید دوباره با پرسش دیگری جستجو کند.
شایعترین شکستهای Agentic RAG کداماند؟
دو شکست رایجتر از بقیهاند؛ تکرار بیپایان جستجو بدون پیشرفت، و نتیجهگیری از سند نامرتبط. هر دو با سقف تعداد جستجو و بررسی صریح ارتباط شواهد با هر ادعا کنترل میشوند.
کی Agentic RAG باید کار را به انسان بسپارد؟
وقتی پس از چند تلاش شواهد کافی پیدا نشد، وقتی منابع با هم تناقض دارند یا وقتی موضوع حساس است. در این حالتها ایجنت باید عدم قطعیت را اعلام کند و راهنمایی انسانی بخواهد.
آیا Agentic RAG همان هوش مصنوعی عمومی است؟
نه. خودمختاری Agentic RAG به یک حوزه و به ابزارها، دادهها و سیاستهایی محدود است که توسعهدهنده در اختیارش گذاشته است. بدون دخالت انسان نمیتواند از این مرزها فراتر برود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.