
فایل llms.txt در یک سال اخیر به یکی از داغترین بحثهای سئو تبدیل شده است. ایده ساده است: یک فایل متنی در ریشه سایت که به مدلهای زبانی بگوید محتوای مهم کجاست. اما آیا این فایل واقعاً سایت را در پاسخهای هوش مصنوعی دیدهتر میکند؟
چهار گزارش عملی از لینکدین پاسخهای متفاوتی دادهاند. ما آنها را کنار بزرگترین پژوهش منتشرشده درباره این فایل و موضع رسمی گوگل گذاشتیم. این مطلب مرور شواهد است، نه آزمایش تخته سبز.
خلاصه یافته: تا امروز، شاهدی از اثر فایل llms.txt بر ارجاع در پاسخهای AI پیدا نشده است؛ اما این به معنی بیفایده بودنش برای همه ایجنتها هم نیست.
فایل llms.txt: سه پرسش را از هم جدا کنید
سه پرسش را جداگانه بیازمایید: آیا فایل درخواست میشود؟ آیا به کشف صفحه کمک میکند؟ آیا دیدهشدن در پاسخها تغییر میکند؟ اینها سه نتیجه متفاوت هستند و یکی دیگری را ثابت نمیکند.
برای آشنایی با خود پیشنهاد، صفحه رسمی llms.txt را ببینید. فرقش با robots.txt را اینطور تصور کنید. robots.txt نگهبان در کتابخانه است و میگوید چه کسی به کدام بخش برود. در مقابل، llms.txt بیشتر بروشوری کنار در ورودی است که قفسههای مهم را معرفی میکند. بروشور فقط وقتی اثر دارد که کسی آن را بردارد و بخواند.
در مقابل، گوگل در راهنمای ویژگیهای AI جستجو میگوید برای AI Overviews و AI Mode الزامات معمول سئو کافی است. البته این راهنما فقط درباره جستجوی گوگل است، نه همه ایجنتها.
بیشتر بخوانید: دیدهشدن در AI فقط به سایت خودتان محدود نیست. دیده شدن در نتایج هوش مصنوعی از بیرون سایت
چهار تجربه عملی با فایل llms.txt
چهار گزارش زیر از زاویههای متفاوتی به این فایل نگاه کردهاند. موضوع آنها به ترتیب دستور صریح، کشف خودکار، دیدهشدن مشتریها و یک نتیجه مثبت با توضیح دیگر است.
لی دیویس: دستور صریح جواب داد، کشف معمولی نه
Lee Davies مسیری از llms.txt به یک مانیفست و سپس به پاسخهای ساختیافته ساخت. وقتی صریحاً به دستیار گفت این مسیر را دنبال کند، دستیار توانست از آن استفاده کند. گزارش اصلی دیویس
اما وقتی یک پرسش معمولی مشتری بدون آن دستور پرسیده شد، دستیار فقط صفحه اصلی را خواند و متوقف شد. بنابراین نمایش موفق با راهنمایی صریح، با کشف خودجوش فرق دارد. این تفاوت برای هر کسبوکاری مهم است.
زوئی الیزابت بلاگ و تیم ریبوت: سه ماه بدون کشف از طریق فایل
Zoë Elizabeth Blogg آزمون دو دامنهای تیم Reboot را گزارش میدهد. صفحههای تازه فقط در llms.txt ذکر شده بودند و هیچ لینک داخلی یا خارجی نداشتند. گزارش اصلی بلاگ
لاگها نشان دادند رباتها در سه ماه از سایتها بازدید کردند. با این حال، نه فایل را خواندند و نه صفحههای فهرستشده در آن را. البته این یافته به همین شیوه کشف مربوط است. همه حالتهای فایل لینکشده یا ایجنت تعاملی را نمیآزماید.
گروه GO MO: آزمون طولانیتر با مشتریها، بدون افزایش قابل سنجش
GO MO Group یک آزمایش ششماهه روی مشتریهایی از صنایع مختلف را گزارش میدهد. نتیجه این بود که پیادهسازی فایل مزیت قابل سنجشی در دیدهشدن AI نداشت. گزارش اصلی GO MO
با این وجود، پست عمومی فقط نتیجهگیری و لینک یک گزارش مفصلتر را دارد. جزئیات کافی برای تخمین اثر قابل تشخیص در خود پست نیست. همچنین نمیتوان نتیجه گرفت همه پلتفرمهای AI این فایل را نادیده میگیرند.
هریستو استانچف: نتیجه مثبت با توضیح محتمل دیگر
Hristo Stanchev گزارش میدهد در دو سایت، راهاندازی پویا حدود سه برابر راهاندازی ایستا ارجاع AI گرفت. گزارش اصلی استانچف
او خودش صریحاً میگوید ثابت نشده که فایل علت بوده است. همان خط تولید، نقشه سایت، مدیریت آدرسهای قدیمی و محتوای قابل خزش محصول را هم بهتر کرده بود. پس این یک مداخله ترکیبی تازگی محتواست، نه آزمایش خالص llms.txt.
داده بزرگ و موضع رسمی چه میگویند؟
به طور خلاصه، چهار تجربه بالا کوچکاند و روشهای متفاوتی دارند. یک پژوهش بزرگ و اظهارات دو کارشناس گوگل تصویر روشنتری میدهند.
SE Ranking؛ ۳۰۰ هزار دامنه، بدون رابطه با ارجاع
SE Ranking در پژوهشی که نسخه اولش نوامبر ۲۰۲۵ منتشر شد و در اکتبر ۲۰۲۶ بهروز شده است، نزدیک به ۳۰۰ هزار دامنه را بررسی کرد. فقط ۱۰٫۱۳ درصد دامنهها فایل llms.txt داشتند. نرخ پذیرش در سایتهای کمترافیک و پرترافیک نزدیک به هم بود و در پرترافیکترین گروه حتی کمی کمتر، حدود ۸٫۲۷ درصد. پژوهش اصلی SE Ranking
پژوهشگران رابطه این فایل و تعداد ارجاع در پاسخهای AI را هم با یک آزمون آماری ساده (همبستگی اسپیرمن) و هم با یک مدل پیشبینی یادگیری ماشین (XGBoost) سنجیدند. نتیجه: هیچ رابطهای پیدا نشد. جالبتر اینکه حذف متغیر llms.txt از مدل، دقت آن را بیشتر کرد؛ یعنی این متغیر فقط نویز اضافه میکرد. البته این پژوهش همبستگی است و اثر فایل روی ایجنتهای تعاملی را نمیسنجد.
گوگل؛ «ابتکار ما نیست»
در رویداد Search Central Live آسیا و اقیانوسیه در ۲۳ ژوئیه ۲۰۲۵ در بانکوک، گری ایلیس و همکارش درباره robots.txt و پیشنهاد llms.txt صحبت کردند. به گزارش Search Engine Journal، موضع گوگل این بود که llms.txt ابتکار گوگل نیست و مفید دانسته نمیشود؛ ابزار کنترل خزندهها همچنان robots.txt است.
پیشتر هم جان مولر گفته بود هیچ سرویس AI اعلام نکرده از این فایل استفاده میکند و در لاگ سرور هم دیده میشود که حتی آن را درخواست نمیکنند. او آن را با متاتگ keywords مقایسه کرد؛ به گزارش Search Engine Journal. این موضع درباره جستجوی گوگل است؛ ابزارهای برنامهنویسی و ایجنتهای دیگر ممکن است رفتار متفاوتی داشته باشند.
وجه مشترک تجربهها و دادهها
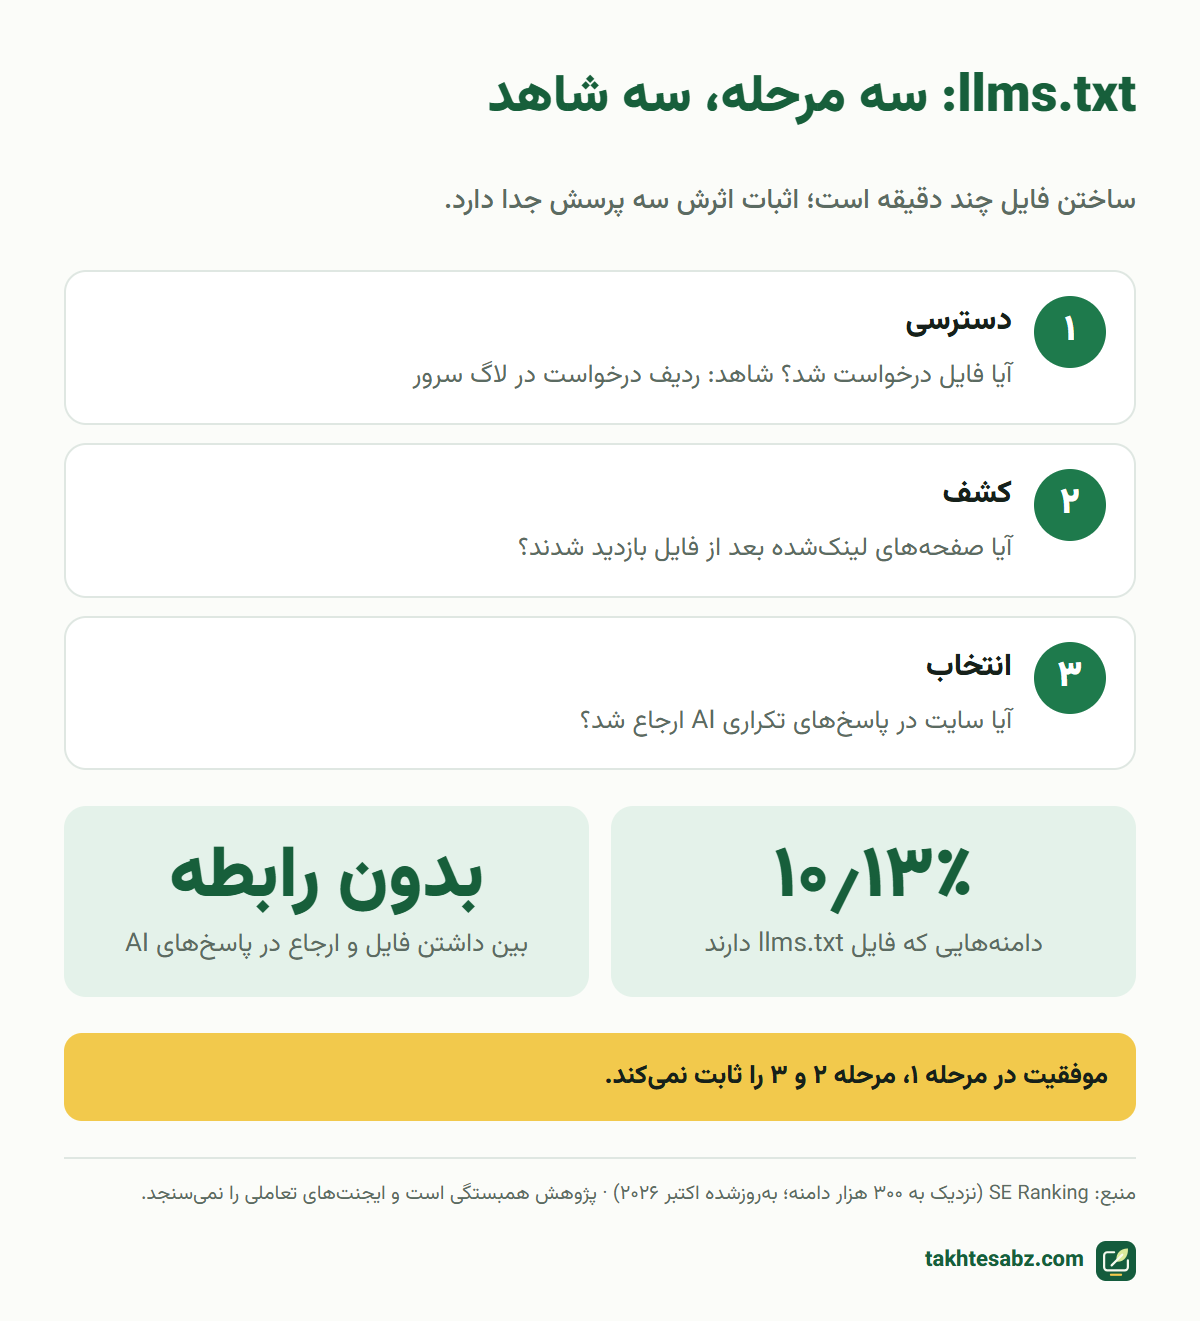
درس مشترک این است که وجود فایل، دسترسی، کشف و انتخاب شدن مرحلههای جداگانهای هستند. دریافت موفق فایل فقط دسترسی را ثابت میکند. ثابت نمیکند دستیار خودش فایل را پیدا میکرد، از لینکهایش استفاده میکرد یا کسبوکار را توصیه میکرد.
گزارش مثبت استانچف پرسش را دقیقتر میکند، نه اینکه حلش کند. وقتی چند تغییر مفید همزمان اتفاق بیفتد، یک نام فایل جذاب اعتبار بهبودهای معمولی جای دیگر سایت را میگیرد. جدول زیر شاهد لازم برای هر مرحله را نشان میدهد.
| مرحله | پرسش | شاهد لازم |
|---|---|---|
| دسترسی | آیا فایل درخواست شد؟ | ردیف درخواست در لاگ سرور |
| کشف | آیا صفحههای لینکشده بازدید شدند؟ | درخواست صفحهها پس از فایل |
| انتخاب | آیا سایت در پاسخ ارجاع شد؟ | پاسخهای تکراری با منبع |
این شواهد چه چیزی را ثابت نمیکنند؟
تجربهها آزمونهای مشاهدهای کوچک یا ناقص توصیفشده هستند، با رباتها، پرامپتها و نقطههای پایانی متفاوت. علاوه بر این، رشته user-agent در لاگ سرور بهتنهایی هویت خزنده را قطعی تأیید نمیکند. user-agent نامی است که هر ربات هنگام درخواست، خودش را با آن معرفی میکند؛ مثل کارت شناساییای که خود مهمان نوشته است و هر کسی میتواند جعلش کند.
پژوهش SE Ranking هم نبود رابطه با ارجاع را نشان میدهد، نه بیفایده بودن فایل برای هر کاربرد. در نتیجه شواهد نه از افزایش قطعی دیدهشدن پشتیبانی میکنند و نه از این ادعای کلی که هیچ ایجنتی هرگز از فایل استفاده نمیکند.
بیشتر بخوانید: سنجش دیدهشدن در AI خودش روش دارد. رصد پاسخهای هوش مصنوعی؛ چرا یک پاسخ کافی نیست
آزمون پیشنهادی برای فایل llms.txt
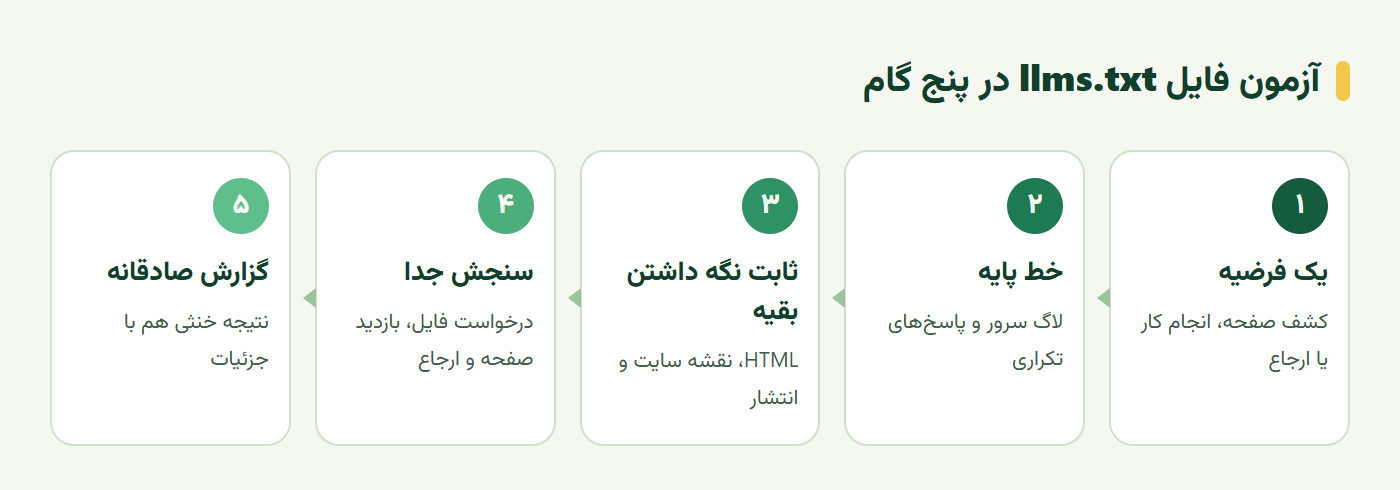
اگر میخواهید اثر فایل llms.txt را در سایت خودتان بسنجید، این مراحل را دنبال کنید. روش پیشنهادی است و نتیجهای از اجرای آن ادعا نمیکنیم:
- یک فرضیه: فقط یک فرضیه را بیان کنید؛ کشف یک مجموعه صفحه کنترلشده، انجام کار توسط ایجنت یا تغییر در ارجاع. هر سه را در یک نمره موفقیت ترکیب نکنید.
- خط پایه: لاگهای پایه و پاسخهای تکراری برای مجموعه ثابتی از پرامپتهای مرتبط را ثبت کنید. درخواست خزنده، دریافت با درخواست کاربر و ابزارهای رصد را جدا کنید.
- ثابت نگه داشتن بقیه: هنگام افزودن فایل، HTML، نقشه سایت، تناوب انتشار و تغییرهای دیگر را ثابت نگه دارید. اگر تازگی محتوا را هم میآزمایید، آن را مداخله جداگانهای علامت بزنید.
- سنجش جدا: درخواست فایل و بازدید بعدی صفحهها را جدا از ارجاع و ترافیک ارجاعی دنبال کنید. پرامپتهای با راهنمایی صریح را در گروه آزمون جداگانه نگه دارید.
- گزارش صادقانه: یافته خنثی را هم با تعداد سایت، مدت و محدودیتهای مشاهده گزارش کنید. تغییر مثبت را تا تکرار با کنترل مناسب موقت بدانید.
این آزمون به دسترسی به لاگ سرور نیاز دارد. اگر هاست اشتراکی دارید، معمولاً لاگ دسترسی از طریق کنترل پنل در دسترس است. نمودار زیر مراحل را نشان میدهد.
نکته کاربردی برای مدیران سایت
پیادهسازی یک فایل و اثبات مزیت آن دو کار متفاوتاند. ساختن llms.txt چند دقیقه طول میکشد، اما ادعای اثر آن به داده نیاز دارد و داده موجود تا امروز این اثر را نشان نداده است.
پس اگر فایل را ساختید، آن را جایگزین سئوی معمولی ندانید. صفحههای قابل خزش، ساختار روشن و محتوای مفید همچنان پایه کار هستند؛ چه برای گوگل، چه برای دستیارهای هوش مصنوعی.
برای نمونه، یک فایل llms.txt ساده برای یک سایت آموزشی وردپرسی طبق قالب پیشنهادی llmstxt.org چنین است: یک عنوان، یک خلاصه کوتاه و فهرست لینکهای مهم. آن را با نام llms.txt در ریشه سایت، یعنی کنار wp-config.php، بگذارید:
# نام سایت شما
> آموزش سئو و وردپرس به زبان ساده
## راهنماهای اصلی
- [بکاپ گرفتن از وردپرس](https://example.com/wordpress-backup/): روش گامبهگام با افزونه
- [افزایش سرعت وردپرس](https://example.com/wordpress-speed/): کش، تصویر و هاستبعد برای سنجش «دسترسی»، لاگ دسترسی سرور را بگیرید (در cPanel از بخش Metrics و Raw Access) و دنبال درخواستهای این فایل بگردید:
grep -i "llms.txt" access_logاگر چند هفته هیچ ردیفی پیدا نشد، یعنی دستکم در سایت شما کسی سراغ بروشور نرفته است؛ و پرسشهای «کشف» و «انتخاب» هنوز حتی مطرح نشدهاند.
این مطلب را چطور آماده کردیم؟
این مطلب یک مرور است، نه آزمایشی روی سایتهای تخته سبز. چهار گزارش عمومی لینکدین را خواندیم و کنار پژوهش SE Ranking، مستندات گوگل و گزارش اظهارات کارشناسان گوگل گذاشتیم. منابع در ۴ مهر ۱۴۰۵ (۲۶ سپتامبر ۲۰۲۶) بررسی شدند و پژوهش SE Ranking و گزارشهای Search Engine Journal دوباره در ۲۹ مهر ۱۴۰۵ (۲۱ اکتبر ۲۰۲۶)؛ در این بازبینی یک ادعا را که در نسخه بهروزشده پژوهش پیدا نشد، حذف کردیم.
به لاگها و داده خام گزارشدهندگان دسترسی نداشتیم؛ پس نتایج آنها منتسب به خودشان است. پژوهش SE Ranking را مستقیم بررسی کردیم. اظهارات ایلیس و مولر را از گزارش Search Engine Journal نقل کردهایم، نه از ویدیو یا پست اصلی.
سخن پایانی
فایل llms.txt میانبر دیدهشدن نیست و دادههای موجود هم اثری از آن بر ارجاع در پاسخهای AI نشان نمیدهند. با این حال، حکم قطعی «بیفایده برای همه» هم هنوز زود است. چهار تجربه و دادهها بیشتر از هر چیز یک درس روششناسی دارند: دسترسی، کشف و انتخاب را جدا بسنجید.
پس اگر تصمیم به ساختن این فایل گرفتید، همراهش یک خط پایه هم بسازید. چند ماه بعد، داده خودتان بهتر از هر پست لینکدینی به شما میگوید ارزشش را داشت یا نه.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- صفحه رسمی پیشنهاد llms.txt (انگلیسی): قالب فایل و هدف آن از زبان پیشنهاددهندگان؛ سطح مبتدی.
- راهنمای گوگل درباره ویژگیهای AI جستجو (انگلیسی): آنچه گوگل برای AI Overviews و AI Mode لازم میداند؛ سطح مبتدی تا متوسط.
- رصد پاسخهای هوش مصنوعی؛ چرا یک پاسخ فقط یک عکس لحظهای است؟: روش سنجش «انتخاب» شدن در پاسخها؛ سطح متوسط.
- گزارش Search Engine Journal از نظر جان مولر (انگلیسی): مقایسه llms.txt با متاتگ keywords؛ سطح متوسط.
- پژوهش SE Ranking روی نزدیک به ۳۰۰ هزار دامنه (انگلیسی): روش آماری و نتیجه کامل؛ سطح حرفهای.
پرسشهای پرتکرار
فایل llms.txt چیست؟
یک فایل متنی پیشنهادی در ریشه سایت است که به مدلهای زبانی نشان میدهد محتوای مهم سایت کجاست. این یک استاندارد رسمی موتورهای جستجو نیست و پشتیبانی از آن به هر سرویس بستگی دارد.
آیا گوگل از فایل llms.txt استفاده میکند؟
به گزارش Search Engine Journal از رویداد گوگل در ژوئیه ۲۰۲۵، llms.txt ابتکار گوگل نیست و از نگاه گوگل مفید دانسته نمیشود. جان مولر هم آن را با متاتگ keywords مقایسه کرد. راهنمای رسمی گوگل برای AI Overviews همان الزامات معمول سئو را کافی میداند.
آیا داشتن llms.txt ارجاع در پاسخهای AI را زیاد میکند؟
در پژوهش SE Ranking روی حدود ۳۰۰ هزار دامنه، هیچ رابطهای بین داشتن این فایل و تعداد ارجاع در پاسخهای AI دیده نشد. حتی مدل پیشبینی پژوهشگران بدون این متغیر دقیقتر کار کرد.
چند درصد سایتها فایل llms.txt دارند؟
طبق همان پژوهش، حدود ۱۰٫۱۳ درصد دامنهها. نرخ پذیرش در سایتهای کمترافیک و پرترافیک نزدیک به هم بود و در پرترافیکترین گروه حتی کمی کمتر، حدود ۸٫۲۷ درصد.
آیا ساختن فایل llms.txt ضرری دارد؟
ضرر مستقیمی گزارش نشده و ساختنش چند دقیقه طول میکشد. خطر اصلی این است که جای کارهای اثرگذارتر مثل صفحههای قابل خزش و محتوای مفید را بگیرد یا اثر آنها به حساب فایل نوشته شود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.