
رصد پاسخهای هوش مصنوعی برای خیلی از تیمهای سئو به کار روزانه تبدیل شده است. پرسشی را در ChatGPT میپرسید، نام برندتان را میبینید و اسکرینشات میگیرید. اما فردا همان پرسش ممکن است منبع دیگری نشان دهد. کدام تصویر درست است؟
سه تجربه از ردیت و لینکدین همین مشکل را گزارش کردهاند. در ادامه، ما آنها را کنار سه پژوهش بزرگ درباره تغییرپذیری پاسخهای AI گذاشتیم. این مطلب مرور شواهد است، نه آزمایش تخته سبز.
خلاصه یافته: یک پاسخ AI رتبه ثابت نیست؛ فهرست برندها تقریباً هیچوقت دو بار یکسان نمیآید، اما درصد حضور در اجراهای زیاد معیار معناداری است.
رصد پاسخهای هوش مصنوعی: فراوانی را بسنجید، نه یک حضور
بسنجید برند یا آدرس شما در پاسخهای تکراری و قابل مقایسه چند بار ظاهر میشود. یک پاسخ را رتبه ثابت ندانید. درصد حضور در ده اجرا اطلاعات بسیار بیشتری از یک اسکرینشات دارد.
مثل سکه انداختن است: یک بار شیر آمدن چیزی درباره سکه نمیگوید. اما اگر در صد بار، هفتاد بار شیر آمد، دیگر الگویی در دست دارید. پاسخهای AI هم سکهای با چند روی متغیرند.
این نگاه با ماهیت پاسخهای AI هم سازگار است. گوگل در راهنمای ویژگیهای AI جستجو توضیح میدهد این پاسخها ممکن است برای یک پرسش، منابع متنوعی را نشان دهند. بنابراین تغییر منبع بین اجراها طبیعی است.
بیشتر بخوانید: رصد پاسخها پیشنیاز هر آزمایش دیدهشدن است. دیده شدن در نتایج هوش مصنوعی از بیرون سایت
سه تجربه از تغییرپذیری ارجاعهای AI
سه گزارش زیر از سه زاویه به یک مشکل رسیدهاند؛ رصد چندروزه، طبقهبندی فرصتها و ماندگاری حضور. کنار هر کدام محدودیتهایش را آوردهایم.
کاربر amphisbaena-: پرسشهای تکراری با منابع متغیر
کاربر u/-amphisbaena در ردیت گزارش میدهد ۲۰ پرسش را در ChatGPT، Gemini و Perplexity به مدت نه روز رصد کرد. او بین اجراها منابع ارجاعشده متفاوتی دید و تفاوتهایی هم بین ابزارها توصیف کرد. گزارش اصلی در ردیت
با این حال، جلسههای واردشده به حساب و تغییر در روش جمعآوری تفسیر را محدود میکنند. این پست سازوکاری وابسته به ساعت روز یا رتبهبندی کلی پایداری پلتفرمها را ثابت نمیکند.
کاربر EmbarrassedBuddy9743: یک اجرا فرصتها را اشتباه دستهبندی کرد
u/EmbarrassedBuddy9743 در یک کامنت در r/aeo میگوید کار تکراری نشان داد پرسشها بین دو حالت جابهجا میشوند. گاهی فرصت ارجاع خالی به نظر میرسید و گاهی منابع قوی و جاافتاده حاضر بودند. کامنت اصلی در ردیت
به همین دلیل، او هر پرسش را دستکم پنج بار اجرا میکند و دسته اکثریت را انتخاب میکند. این یک اصلاح عملی گزارششده است. اما شاهدی نیست که پنج اجرا برای هر پرسشی از نظر آماری کافی باشد.
دانا بیلینگزلی: حضور اولیه همیشه نماند
Dana Billingsley در کامنتی زیر آزمایش کیم هویین میگوید دیده است محتوا سریع در پاسخهای AI ظاهر شده و بعد ناپدید شده است. در همان حال، منابع دیگر دوباره استفاده شدهاند. گفتوگوی اصلی در لینکدین
البته او تعداد نمونه یا برنامه اندازهگیری ارائه نمیدهد. تجربه کیفیاش با موقت دانستن اولین حضور سازگار است. اما دلیل ماندن یا نماندن منابع همچنان حلنشده باقی میماند.
پژوهشها درباره تغییرپذیری پاسخهای AI
به طور خلاصه، سه تجربه بالا کیفی یا کوچکاند. سه پژوهش زیر با هزاران اجرا اندازه همین تغییرپذیری را سنجیدهاند و هر کدام یک لایه از مسئله را نشان میدهد: فهرست برندها، محتوای AI Overview و سهم دامنهها.
SparkToro و Gumshoe؛ فهرست برندها تقریباً هیچوقت تکرار نمیشود
رند فیشکین از SparkToro همراه با پاتریک اودانل از Gumshoe در ۲۸ ژانویه ۲۰۲۶ نتیجه آزمایشی را منتشر کرد. ۶۰۰ داوطلب در نوامبر و دسامبر ۲۰۲۵ دوازده پرسش توصیه برند و محصول را در مجموع ۲۹۶۱ بار در ChatGPT، Claude و هوش مصنوعی گوگل اجرا کردند. پژوهش اصلی SparkToro
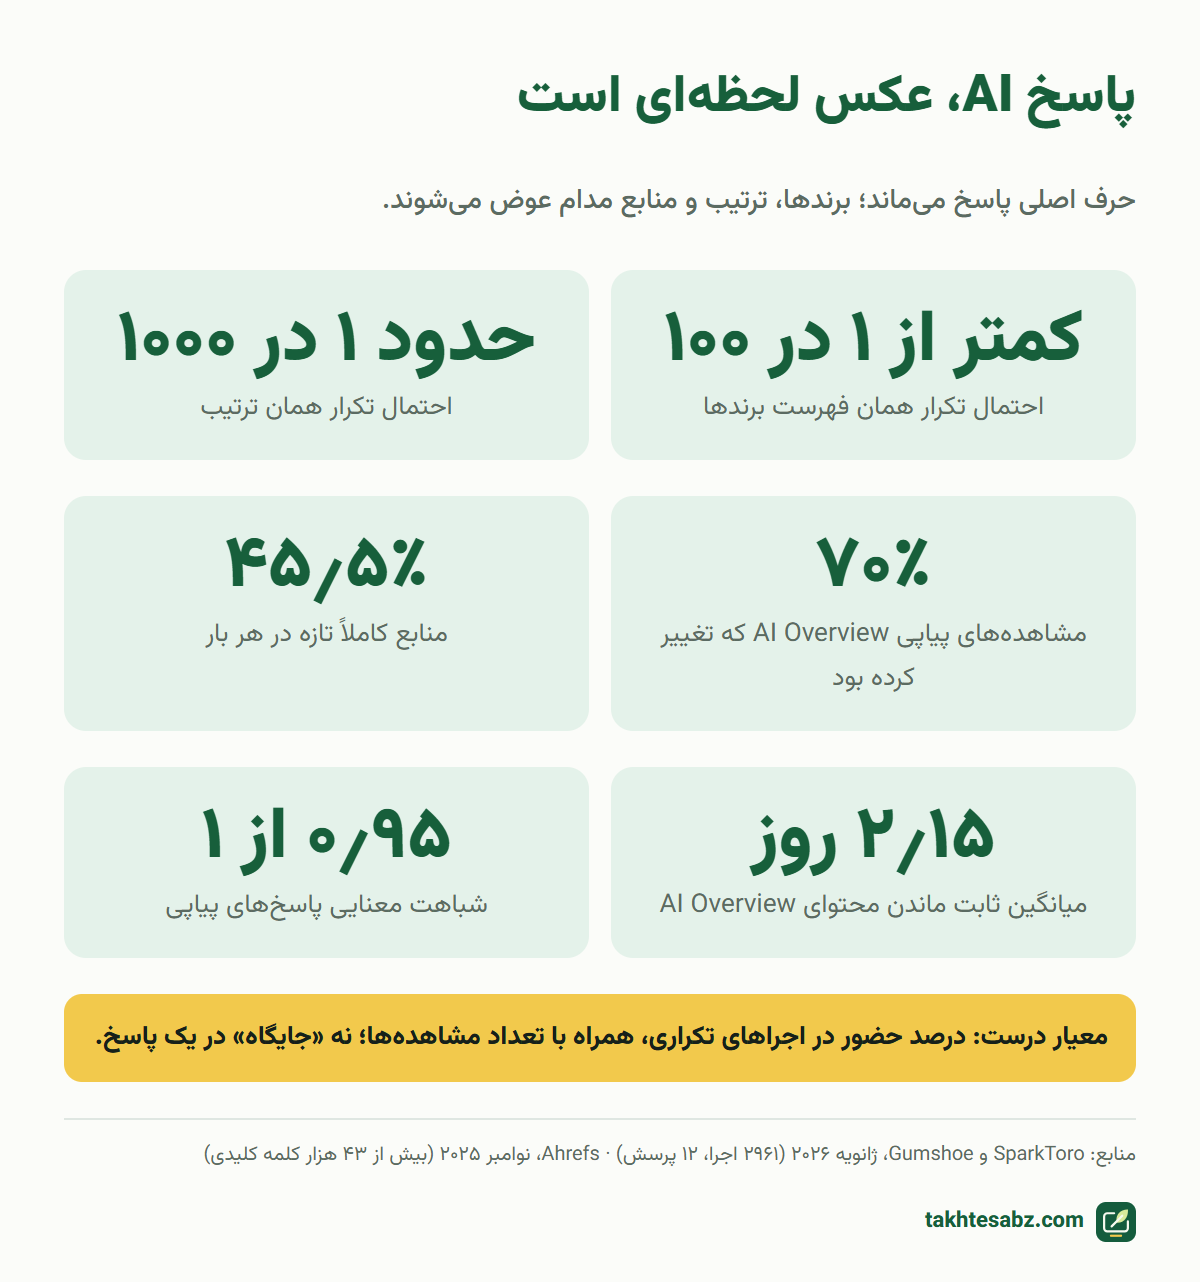
احتمال اینکه یک پرسش تکراری همان فهرست برندها را برگرداند کمتر از ۱ در ۱۰۰ بود و همان ترتیب حدود ۱ در ۱۰۰۰. با این حال، جمعبندی پژوهش این است که «درصد حضور در دهها تا صدها پرسش که چند بار اجرا شدهاند» معیار معقولی است. در مقابل، هر ابزاری که ادعای سنجش «جایگاه» در پاسخ AI را دارد قابل اعتماد نیست.
Ahrefs؛ AI Overview هر دو روز عوض میشود
Ahrefs در ۱۱ نوامبر ۲۰۲۵ بیش از ۴۳ هزار کلمه کلیدی را بررسی کرد که هر کدام دستکم ۱۶ AI Overview ثبتشده داشتند. در ۷۰ درصد مشاهدههای پیاپی، محتوای AI Overview تغییر کرده بود و بهطور میانگین ۲٫۱۵ روز ثابت میماند. هر بار حدود ۴۵٫۵ درصد منابع ارجاعشده کاملاً تازه بودند. پژوهش اصلی Ahrefs، نوشته لوئیز لینهان
نکته جالب این است که معنای پاسخها تقریباً ثابت بود؛ شباهت معنایی پاسخهای پیاپی ۰٫۹۵ از ۱ بود. یعنی حرف اصلی میماند، اما منابعی که به آنها لینک داده میشود مدام عوض میشوند. مثل دو معلم که یک درس را با مثالها و کتابهای مرجع متفاوت درس میدهند. برای تیم سئو، همین تغییر منابع مهم است.
Semrush؛ سهم یک دامنه هم ثابت نمیماند
Semrush در ۱۰ نوامبر ۲۰۲۵ بیش از ۱۰۰ میلیون ارجاع را در ۱۳ هفته بررسی کرد. سهم ارجاع ChatGPT به ردیت از حدود ۶۰ درصد پاسخها در اوایل اوت ۲۰۲۵ به حدود ۱۰ درصد در اواسط سپتامبر رسید و ویکیپدیا هم مسیر مشابهی داشت. پژوهش اصلی Semrush
در مقابل، در همان دوره Perplexity و Google AI Mode نوسان بسیار کمتری داشتند. پس تغییرپذیری فقط بین اجراهای یک پرسش نیست؛ رفتار کلی یک دستیار هم در چند هفته میتواند عوض شود. رصدی که فقط یک ماه طول بکشد، ممکن است همین جابهجایی را با اثر کار شما اشتباه بگیرد.
وجه مشترک تجربهها و پژوهشها
مشکل مشترک این است که یک مشاهده متغیر، ویژگی ثابت سایت فرض میشود. تیمی یک بار برندش را پیدا میکند، بهبود را جشن میگیرد و بعد غیبت را جریمه تفسیر میکند. پژوهشها نشان میدهند بدون اندازهگیریهای تکراری، هر دو نتیجهگیری ممکن است زودهنگام باشد.
بنابراین فیلدهای جداگانهای برای اشاره به برند، توصیه صریح و منبع لینکشده بسازید. یک پاسخ ممکن است یکی را داشته باشد و بقیه را نه. همچنین گفتوگوی تازه را از گفتوگوی ادامهدار جدا کنید، چون پرسش قبلی کاربر کار مدل را تغییر میدهد.
| فیلد | تعریف | چرا جدا ثبت شود |
|---|---|---|
| اشاره به برند | نام برند در متن پاسخ | ممکن است بدون لینک یا توصیه باشد |
| توصیه صریح | پیشنهاد مستقیم برند به کاربر | ارزش تجاری بیشتری دارد |
| منبع لینکشده | آدرس سایت در فهرست منابع | امکان بازدید قابل انتساب |
| خطای اجرا | پاسخ ناقص یا بازیابی ناموفق | نباید غیبت برند شمرده شود |
این شواهد چه چیزی را ثابت نمیکنند؟
تجربهها خوداظهاری هستند؛ دو نام مستعار ردیت و یک کامنت کوتاه لینکدین. پژوهش SparkToro هم فقط ۱۲ پرسش داشت و خود نویسندگان حداقل تعداد اجرای لازم برای اعتبار آماری را پرسش باز میدانند.
از سوی دیگر، تغییر نتایج بازیابی، رفتار مدل، موقعیت جغرافیایی، زمینه حساب و خطای جمعآوری همه توضیحهای ممکن هستند. دادهها هم عمدتاً انگلیسیاند و ممکن است رفتار پاسخها برای پرسشهای فارسی فرق کند.
بیشتر بخوانید: همین منطق نمونهگیری در آزمون فایل llms.txt هم لازم است. فایل llms.txt به دیده شدن در هوش مصنوعی کمک میکند؟
روش پیشنهادی برای رصد قابل اعتماد
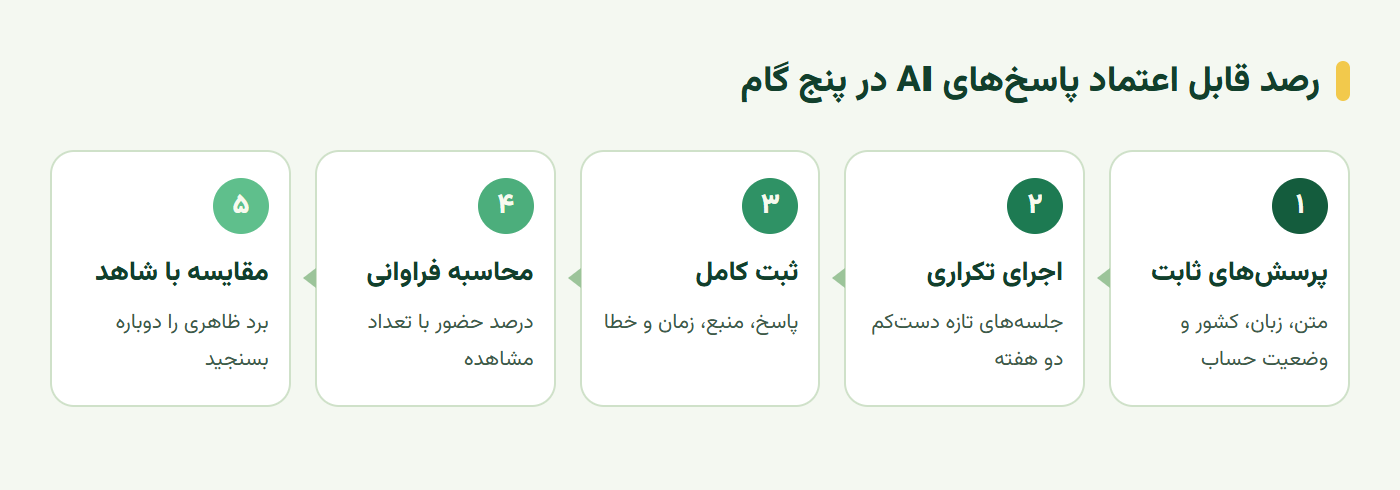
برای رصد پاسخهای هوش مصنوعی به شکلی که بتوان به آن تکیه کرد، این مراحل را دنبال کنید. روش پیشنهادی است و نتیجهای از اجرای آن ادعا نمیکنیم:
- پرسشهای ثابت: مجموعه ثابتی از پرسشها با قصدهای واقعی خریدار بسازید. متن دقیق، زبان، کشور، سطح محصول، نام مدل و وضعیت حساب را ذخیره کنید.
- اجرای تکراری: هر پرسش را در جلسههای تازه و قابل مقایسه، دستکم دو هفته تکرار کنید. از دسترسی دستی مجاز یا جمعآوری مجاز استفاده کنید و گفتوگوهای ادامهدار را گروه جداگانه بدانید.
- ثبت کامل: پاسخ، آدرسهای ارجاعشده، زمان و هر خطای بازیابی را ذخیره کنید. خطاها را جدا بشمارید و غیبت برند ثبت نکنید.
- محاسبه فراوانی: فراوانی اشاره و ارجاع را برای هر پرسش حساب کنید. سپس بین پرسشهای همقصد خلاصه کنید و تعداد مشاهدههای معتبر را نشان دهید.
- مقایسه با شاهد: پیش از نسبت دادن تغییر به یک مداخله، حرکت آن را با پرسشهای بدون تغییر و دامنه خط پایه مقایسه کنید. برد ظاهری را پیش از پیشبینی دوباره بسنجید.
با یک صفحهگسترده ساده هم میتوانید این روش را اجرا کنید. مهم نظم در ثبت است، نه ابزار گران. نمودار زیر مراحل را نشان میدهد.
نکته کاربردی برای تیمهای سئو
در واقع، گزارش دیدهشدن وقتی معتبرتر میشود که تغییرپذیری را نشان دهد. «برند ما در ۷ از ۱۰ اجرا حاضر بود» جملهای قابل دفاع است. در مقابل، «ChatGPT ما را اول توصیه میکند» بدون تعداد اجرا قابل دفاع نیست؛ پژوهش SparkToro نشان داد ترتیب تقریباً هیچوقت تکرار نمیشود.
پیش از خرید ابزار رصد هم بپرسید روش آن چیست. SparkToro توصیه میکند از فروشنده پژوهش عمومی و قابل بررسی درباره همین تغییرپذیری بخواهید. وقتی مدیرتان عدد میخواهد، درصد حضور و تعداد مشاهده را با هم گزارش کنید.
برای مثال، در Google Sheets برای هر پرسش یک ردیف بسازید و نتیجه ده اجرا را در ستونهای E تا N با یکی از سه مقدار «بله»، «نه» یا «خطا» بنویسید. درصد حضور را با این فرمول حساب کنید تا اجراهای خراب، غیبت برند حساب نشوند:
=COUNTIF(E2:N2,"بله") / (COUNTA(E2:N2) - COUNTIF(E2:N2,"خطا"))اگر از ده اجرا یکی خطا داد و برند در هفت اجرای معتبر آمد، نتیجه حدود ۷۸ درصد است؛ و گزارش درست آن «۷ از ۹ اجرای معتبر» است، نه «همیشه حاضریم».
این مطلب را چطور آماده کردیم؟
این مطلب یک مرور است، نه آزمایشی روی سایتهای تخته سبز. سه گزارش عمومی ردیت و لینکدین را خواندیم و کنار سه پژوهش SparkToro، Ahrefs و Semrush گذاشتیم. منابع در ۴ مهر ۱۴۰۵ (۲۶ سپتامبر ۲۰۲۶) بررسی شدند و پژوهشهای SparkToro و Ahrefs و داده Semrush دوباره در ۲۹ مهر ۱۴۰۵ (۲۱ اکتبر ۲۰۲۶).
به داده خام گزارشدهندگان دسترسی نداشتیم؛ پس نتایج آنها منتسب به خودشان است. هر سه پژوهش را مستقیم از منبع اصلی بررسی کردیم. عددهای پژوهشها را با هم میانگین نگرفتیم، چون هر کدام چیز متفاوتی را میسنجد.
سخن پایانی
رصد پاسخهای هوش مصنوعی بدون تکرار، مثل قضاوت درباره آبوهوای یک ماه با نگاه به آسمان یک لحظه است. تجربهها و پژوهشهایی که مرور کردیم نشان میدهند منابع ارجاعشده مدام تغییر میکنند و حضور اولیه همیشه نمیماند.
پس به جای اسکرینشات، فراوانی را گزارش کنید. پرسشها را ثابت نگه دارید، اجراها را تکرار کنید و خطاها را جدا بشمارید. آن وقت عدد شما واقعاً چیزی درباره دیدهشدن برندتان میگوید.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- راهنمای گوگل درباره ویژگیهای AI جستجو (انگلیسی): چرا پاسخهای AI گوگل منابع متنوعی نشان میدهند؛ سطح مبتدی.
- نرخ تبدیل ترافیک هوش مصنوعی بالاست؟ چرا مخرج کسر مهم است: قدم بعد از رصد حضور، یعنی سنجش بازدید و تبدیل؛ سطح متوسط.
- پژوهش SparkToro درباره ناپایداری توصیه برندها (انگلیسی): روش ۲۹۶۱ اجرا و پیشنهاد معیار درصد حضور؛ سطح متوسط.
- پژوهش Ahrefs درباره تغییر AI Overviews (انگلیسی): داده بیش از ۴۳ هزار کلمه کلیدی؛ سطح حرفهای.
- پژوهش Semrush درباره دامنههای پرارجاع در AI (انگلیسی): نوسان سهم دامنهها در ۱۳ هفته؛ سطح حرفهای.
پرسشهای پرتکرار
چرا ChatGPT هر بار منابع متفاوتی نشان میدهد؟
پاسخهای AI ذاتاً متغیرند. در پژوهش SparkToro، احتمال اینکه ChatGPT یا هوش مصنوعی گوگل برای یک پرسش تکراری همان فهرست برندها را بدهد کمتر از ۱ در ۱۰۰ بود و همان ترتیب حدود ۱ در ۱۰۰۰.
AI Overviews گوگل هر چند وقت یک بار تغییر میکنند؟
در پژوهش Ahrefs روی بیش از ۴۳ هزار کلمه کلیدی، AI Overview در ۷۰ درصد مشاهدههای پیاپی تغییر کرده بود و محتوای آن بهطور میانگین ۲٫۱۵ روز ثابت میماند. حدود ۴۵٫۵ درصد منابع ارجاعشده هر بار کاملاً تازه بودند.
آیا ابزارهای «رتبه در ChatGPT» قابل اعتمادند؟
طبق جمعبندی SparkToro، هر معیاری که ادعای سنجش «جایگاه» در پاسخ AI را داشته باشد قابل اعتماد نیست. اما درصد حضور در دهها تا صدها پرسش تکراری معیار معقولی است.
هر پرسش را چند بار باید اجرا کرد؟
عدد قطعی علمی وجود ندارد و خود SparkToro هم آن را پرسش باز میداند. یک تجربه عملی دستکم پنج اجرا برای هر پرسش گزارش کرده است؛ هر عددی انتخاب میکنید، تعداد مشاهدهها را کنار درصد گزارش کنید.
چه چیزهایی را باید در رصد پاسخهای AI ثبت کرد؟
متن دقیق پرسش، زبان، کشور، مدل، وضعیت حساب، زمان، پاسخ کامل، آدرسهای ارجاعشده و خطاهای اجرا. اشاره به برند، توصیه صریح و منبع لینکشده را هم جدا ثبت کنید.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.