
برنامه تولید متن با هوش مصنوعی همان تجربهی ChatGPT است، با این تفاوت که داخل برنامهی خودتان قرار میگیرد. تا اینجا پرامپت را در پنجرهی چت مینوشتیم. حالا میخواهیم همان پرامپت را با چند خط کد به مدل بفرستیم و پاسخ را در برنامه استفاده کنیم.
در این قسمت از مجموعهی «از پرامپت تا دستیار هوش مصنوعی» با کتابخانهی openai در پایتون کار میکنیم. اول یک برنامهی ساده میسازیم. بعد آن را به یک برنامهی پیشنهاد دستور پخت تبدیل میکنیم که از کاربر ورودی میگیرد، مواد ناخواسته را حذف میکند و فهرست خرید میدهد.
برنامه تولید متن با هوش مصنوعی چیست؟
بیشتر برنامههایی که میشناسیم یکی از دو نوع رابط (Interface، راه ارتباط کاربر با برنامه) را دارند. یا خط فرمانیاند، مثل git که دستور تایپ میکنید. یا رابط گرافیکی دارند و با دکمه و فرم کار میکنند. برنامهی تولید متن نوع سومی است که با زبان طبیعی کار میکند.
فرق دو نوع اول با نوع سوم مثل فرق دستگاه خودپرداز با کارمند باجهی بانک است. خودپرداز فقط دکمههای از پیش تعریفشده را میشناسد، اما با کارمند میشود حرف زد. البته کارمند هم گاهی اشتباه میفهمد؛ برنامهی تولید متن هم همینطور است.
محدودیت برنامههای معمولی
برنامهی خط فرمانی فقط دستورهایی را میفهمد که از قبل برایش تعریف شده است. اگر دستوری را کمی متفاوت بنویسید، خطا میگیرید. رابط گرافیکی هم فقط همان گزینههایی را نشان میدهد که طراح پیشبینی کرده است.
محدودیت دوم زبان است. بیشتر برنامهها برای یک زبان مشخص ساخته میشوند و پشتیبانی از زبانهای دیگر کار جداگانهای میخواهد. همچنین اطلاعات برنامه معمولاً به همان پایگاه دادهای محدود است که خودتان پر کردهاید.
مزیت برنامههای تولید متن
در برنامهی تولید متن، کاربر به فهرست دستورها یا یک زبان خاص محدود نیست. هر درخواستی را به زبان طبیعی مینویسد و مدل آن را تفسیر میکند. کاربر فارسیزبان میتواند فارسی بنویسد و کاربر دیگر انگلیسی؛ بیآنکه کد جدیدی اضافه کنید.
مزیت دیگر، دانش گستردهی مدل است. مدل روی حجم عظیمی از متن آموزش دیده است. پس برنامهی شما از همان روز اول به دانشی دسترسی دارد که ساختنش با پایگاه دادهی معمولی سالها طول میکشید.
با برنامه تولید متن چه میشود ساخت؟
دامنهی کاربرد بسیار گسترده است. سه نمونهی رایج اینهاست:
- چتبات: پاسخگویی به پرسشها دربارهی شرکت، محصولات یا خدمات شما.
- دستیار متنی: خلاصهکردن متن، استخراج نکتههای کلیدی یا نوشتن رزومه و نامه.
- دستیار کدنویسی: کمک به نوشتن و توضیح کد، مشابه GitHub Copilot.
هر سه نمونه یک هستهی مشترک دارند: فرستادن پرامپت و گرفتن متن. تفاوتشان در پرامپت، دادهی ورودی و شیوهی نمایش خروجی است.
اتصال به مدل زبانی؛ API یا کتابخانه؟
برای استفاده از مدل زبانی در برنامه دو راه دارید. میتوانید مستقیم درخواست وب بسازید و پرامپت را به API (Application Programming Interface، درگاهی که برنامهها از طریق آن با هم حرف میزنند) بفرستید.
API را مثل باجهی سفارش یک رستوران در نظر بگیرید؛ سفارش را با قالب مشخص تحویل میدهید و غذا را تحویل میگیرید، بدون اینکه وارد آشپزخانه شوید. راه دوم این است که از کتابخانهای استفاده کنید که این درخواستها را برایتان مدیریت میکند. برای شروع، کتابخانه سادهتر و امنتر است.
کتابخانهها هم دو سطح دارند. برخی مثل openai فقط اتصال به مدل را ساده میکنند. برخی دیگر مثل LangChain و Semantic Kernel سطح بالاترند و امکاناتی مثل زنجیرهسازی، حافظه و اتصال به ابزار دارند. در این آموزش از openai استفاده میکنیم.
| کتابخانه | سطح | زبانها | مناسب برای |
|---|---|---|---|
| openai | پایه | Python، JavaScript و دیگر زبانها | شروع کار و کنترل کامل |
| LangChain | سطح بالا | Python و JavaScript | زنجیرهها، RAG و ایجنت |
| Semantic Kernel | سطح بالا | C#، Python و Java | پروژههای سازمانی مایکروسافتی |
اولین برنامه تولید متن با هوش مصنوعی در پایتون
حالا دست به کد میشویم. این بخش سه قدم دارد: آمادهکردن محیط، گرفتن کلید دسترسی و فرستادن اولین درخواست. در پایان یک برنامهی کوچک دارید که ادامهی یک داستان را مینویسد.
نصب کتابخانه در محیط مجازی
بهتر است هر پروژهی پایتون محیط مجازی (Virtual Environment) خودش را داشته باشد. محیط مجازی مثل کمد جداگانهی هر دانشآموز است؛ وسایل یک پروژه با پروژهی دیگر قاطی نمیشود. در نتیجه نسخهی کتابخانهها از پروژههای دیگر جدا میماند. با دستورهای زیر محیط را بسازید و کتابخانه را نصب کنید:
python -m venv venv
source venv/bin/activate      # در ویندوز: venv\Scripts\activate
pip install openai python-dotenvکتابخانهی python-dotenv را هم نصب کردیم تا بعداً کلید API را از یک فایل جداگانه بخوانیم. اگر Python ندارید، آن را از سایت رسمی Python نصب کنید.
گرفتن کلید API و آدرس سرویس
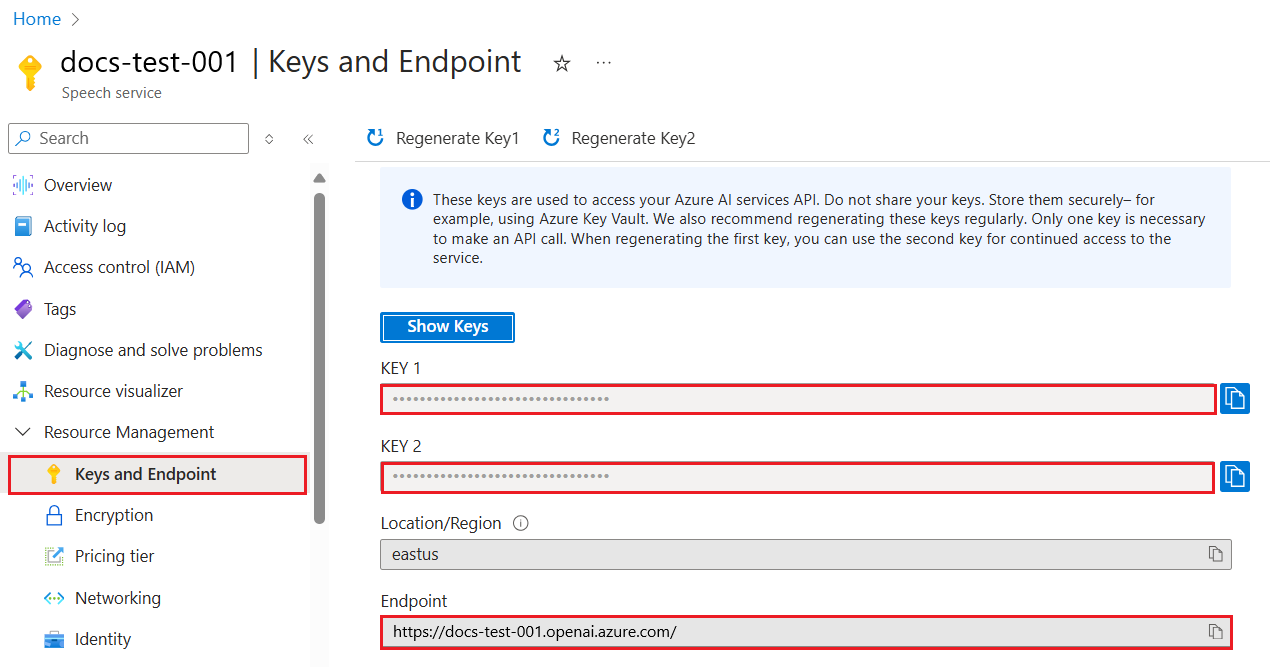
برای استفاده از مدل به یک کلید دسترسی نیاز دارید. اگر مستقیم از OpenAI استفاده میکنید، کلید را از پنل حساب کاربری میگیرید. در Azure OpenAI باید یک منبع (Resource) بسازید و کلید و آدرس سرویس را از بخش Keys and Endpoint بردارید.
در Azure هر منبع دو کلید دارد و یکی کافی است. کلید دوم برای زمانی است که بخواهید کلید اول را عوض کنید، بدون اینکه برنامه قطع شود. آدرس سرویس (Endpoint) را هم کپی کنید؛ کتابخانه به هر دو نیاز دارد.
تصویر زیر همین بخش را در پرتال Azure نشان میدهد. کلیدها و آدرس سرویس با کادر قرمز مشخص شدهاند.
نوشتن اولین درخواست
حالا فایل app.py را بسازید. در کد زیر کلاینت ساخته میشود، پرامپت با متد responses.create فرستاده میشود و متن پاسخ از output_text خوانده میشود:
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])

prompt = "این داستان را ادامه بده: روزی روزگاری در یک روستای کوچک"
response = client.responses.create(model="gpt-5-mini", input=prompt, store=False)

print(response.output_text)
اگر از Azure استفاده میکنید، هنگام ساخت کلاینت یک base_url هم بدهید که به آدرس سرویس شما و مسیر /openai/v1/ ختم میشود. بهجای نام مدل هم نام استقرار (deployment) خودتان را بنویسید. با اجرای برنامه، چند جمله در ادامهی داستان چاپ میشود.
کیفیت خروجی این برنامه مستقیم به پرامپت بستگی دارد. بنابراین پیش از رفتن به پروژهی عملی، روشهایی مثل few-shot و زنجیرهی فکر را مرور کنید.
بیشتر بخوانید: تکنیکهای پرامپت نویسی پیشرفته؛ از زنجیره فکر تا خوداصلاحی
پروژهی عملی؛ برنامهی پیشنهاد دستور پخت
فرض کنید چند قلم مواد غذایی در خانه دارید و نمیدانید چه بپزید. میخواهیم برنامهای بسازیم که با گرفتن فهرست مواد، چند دستور پخت پیشنهاد دهد. این پروژه نشان میدهد پرامپت چطور به بخشی از منطق برنامه تبدیل میشود.
نسخهی اول با پرامپت ثابت
در سادهترین حالت، پرامپت را مستقیم در کد مینویسیم. مثلاً «پنج دستور پخت با مرغ، سیبزمینی و هویج پیشنهاد بده و برای هر کدام همهی مواد لازم را فهرست کن». مدل پنج غذا با فهرست کامل مواد برمیگرداند.
نتیجه خوب است، اما برنامه انعطاف ندارد. هر بار که مواد عوض شود، باید کد را تغییر دهید. همچنین یادتان باشد مدل غیرقطعی است؛ دو اجرای پشتسرهم ممکن است غذاهای متفاوتی پیشنهاد دهند.
گرفتن ورودی از کاربر
قدم بعدی این است که تعداد دستور پخت و فهرست مواد را از کاربر بگیریم و در پرامپت قرار دهیم. این کار با یک f-string ساده در پایتون انجام میشود:
no_recipes = input("تعداد دستور پخت (مثلاً ۵): ")
ingredients = input("مواد موجود (مثلاً مرغ، سیبزمینی، هویج): ")
prompt = (
f"{no_recipes} دستور پخت با این مواد پیشنهاد بده: {ingredients}. "
"برای هر دستور، همهی مواد لازم را فهرست کن."
)حالا با ورودی «۳» و «شیر، توتفرنگی» برنامه چیزهایی مثل شیک توتفرنگی و کیک توتفرنگی پیشنهاد میدهد. پرامپت شما در واقع یک قالب با دو جای خالی شده است؛ همان مفهومی که در قسمت اول دیدیم.
فیلتر مواد و ساخت فهرست خرید
دو بهبود دیگر هم میخواهیم. اول، کاربر بتواند موادی را که دوست ندارد یا به آن حساسیت دارد حذف کند. کافی است یک ورودی دیگر بگیرید و آن را به انتهای پرامپت اضافه کنید؛ مثلاً «بدون سیر». فقط دقت کنید فیلتر باید روشن باشد. کسی که لاکتوز را تحمل نمیکند، احتمالاً پنیر را هم نمیخواهد، نه فقط شیر را.
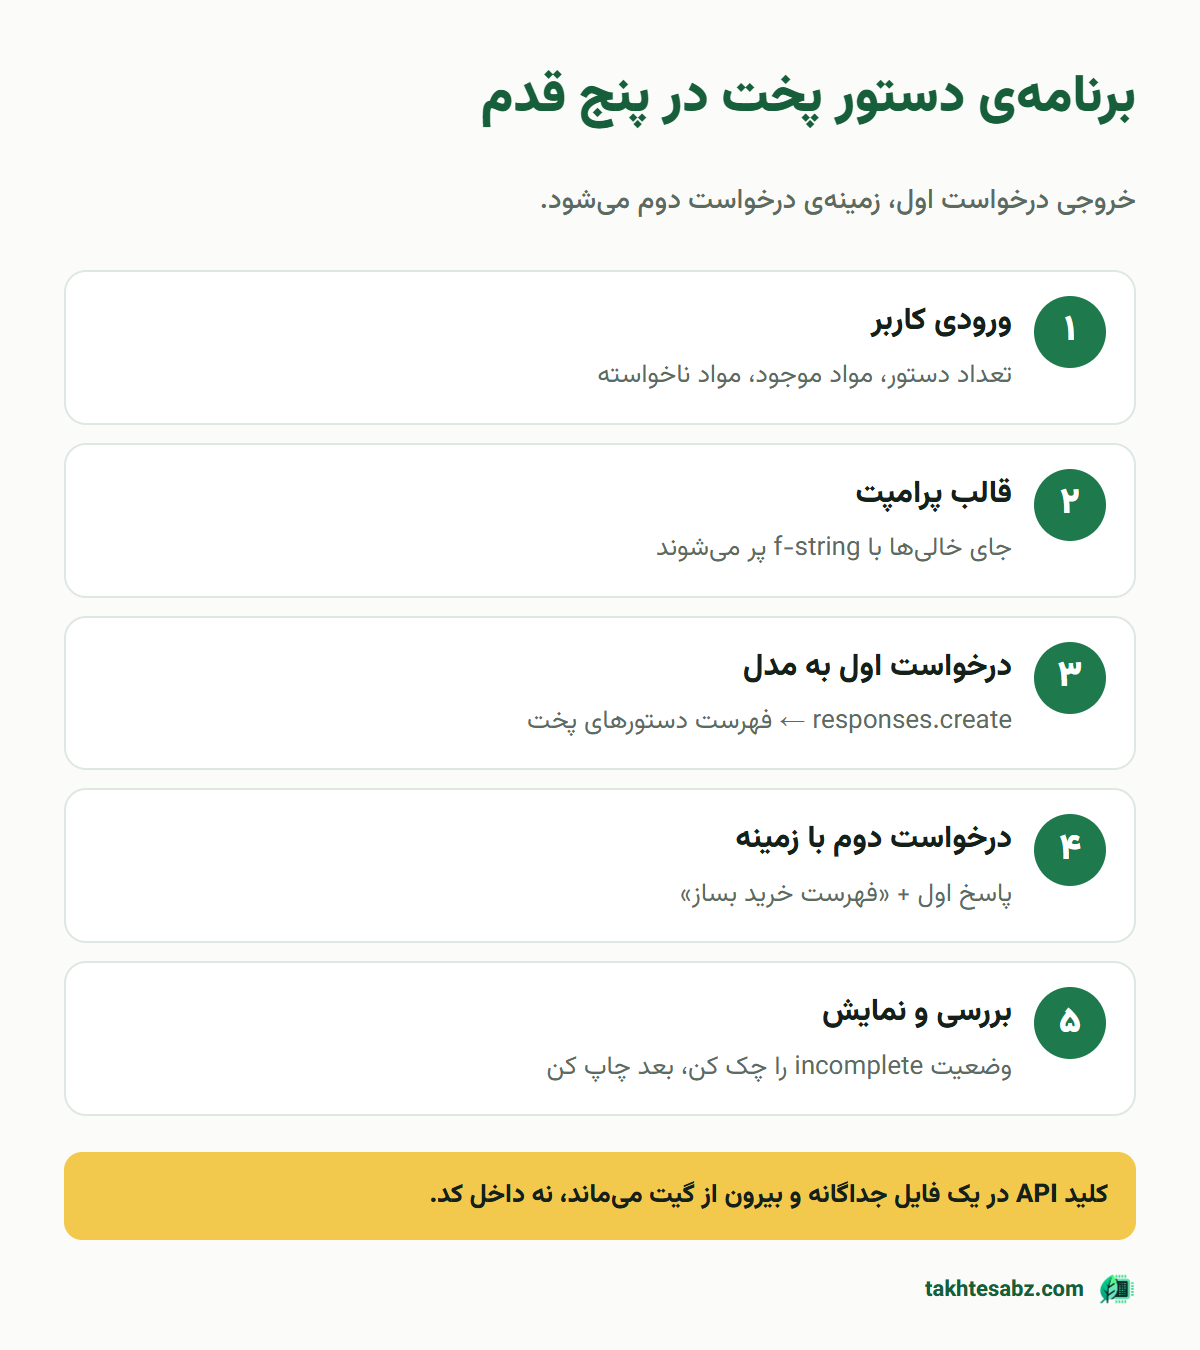
دوم، فهرست خرید. میتوانستیم همهچیز را در یک پرامپت بخواهیم، اما تقسیم کار نتیجهی بهتری میدهد. پاسخ درخواست اول را در درخواست دوم قرار میدهیم و از مدل میخواهیم فقط موادی را فهرست کند که در خانه نداریم. کد کامل app.py با هر سه بهبود این شکل است:
import os
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
no_recipes = input("تعداد دستور پخت (مثلاً ۵): ")
ingredients = input("مواد موجود (مثلاً مرغ، سیبزمینی، هویج): ")
avoid = input("موادی که نمیخواهید (مثلاً سیر): ")
prompt = (
f"{no_recipes} دستور پخت با این مواد پیشنهاد بده: {ingredients}. "
f"از این مواد و هر چیزی که آن را دارد استفاده نکن: {avoid}. "
"برای هر دستور، همهی مواد لازم را فهرست کن."
)
response = client.responses.create(model="gpt-5-mini", input=prompt, store=False)
old_result = response.output_text
print(old_result)
prompt = (
f"مواد موجود در خانه: {ingredients}. "
"برای دستورهای بالا فهرست خرید بساز و موادی را که در خانه دارم نیاور."
)
response = client.responses.create(
model="gpt-5-mini",
input=f"{old_result}\n\n{prompt}",
max_output_tokens=4000,
store=False,
)
if response.status == "incomplete":
print("پاسخ به سقف توکن رسید؛ max_output_tokens را بیشتر کنید.")
print("فهرست خرید:")
print(response.output_text)این الگو، یعنی استفاده از خروجی یک درخواست بهعنوان زمینهی درخواست بعدی، در بیشتر برنامههای واقعی تکرار میشود. در قسمت چتبات همین ایده را به تاریخچهی گفتوگو تبدیل میکنیم.
بهبود تنظیمات برنامه
کد ما کار میکند، اما برای استفادهی واقعی چند نکته را باید رعایت کرد. این نکتهها به امنیت، هزینه و میزان تنوع خروجی مربوطاند.
کلید API را از کد جدا کنید
کلید API جایش داخل کد نیست. کد معمولاً در گیت ذخیره یا با همکاران به اشتراک گذاشته میشود. اگر کلید داخل کد باشد، دیر یا زود لو میرود و هر کسی میتواند به حساب شما هزینه بسازد.
راهحل ساده، فایل .env است. این فایل مثل گاوصندوق کوچک کنار پروژه است؛ کد فقط میداند کلید کجاست، اما خود کلید را در خودش ندارد. کلید را در این فایل بنویسید و فایل را به .gitignore اضافه کنید:
OPENAI_API_KEY=sk-...سپس در کد با load_dotenv() آن را بخوانید:
import os
from dotenv import load_dotenv
from openai import OpenAI
load_dotenv()
client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])به این ترتیب کد را میتوانید بیخطر با دیگران به اشتراک بگذارید، چون کلید فقط روی سیستم خودتان است.
مصرف توکن را کنترل کنید
هزینهی مدل بر اساس توکن محاسبه میشود؛ هم توکنهای پرامپت و هم توکنهای پاسخ. پس هرچه پرامپت کوتاهتر و دقیقتر باشد، هزینه کمتر است. قبل از افزودن توضیحات طولانی بپرسید: آیا واقعاً لازم است؟
با پارامتر max_output_tokens هم سقف طول پاسخ را تعیین میکنید. اما در مدلهای استدلالی مثل gpt-5-mini، این سقف توکنهای استدلال پنهان را هم شامل میشود. پس اگر عدد خیلی کم باشد، پاسخ با وضعیت incomplete و گاهی بدون هیچ متنی برمیگردد. برای همین در کد بالا عدد را بزرگتر گذاشتیم و وضعیت پاسخ را بررسی کردیم.
temperature و مدلهای استدلالی
در قسمت دوم دیدیم temperature میزان تنوع خروجی را تعیین میکند. در مدلهایی که از آن پشتیبانی میکنند، کافی است پارامتر temperature را هنگام فرستادن درخواست تنظیم کنید. هرچه به یک نزدیکتر باشد، خروجی متنوعتر است.
اما یک تغییر مهم را باید بدانید. مدلهای استدلالی مثل gpt-5 و gpt-5-mini پارامترهای temperature و top_p را پشتیبانی نمیکنند یا فقط مقدار پیشفرض را میپذیرند. اگر مقدار دیگری بفرستید، خطای «پارامتر پشتیبانی نمیشود» میگیرید. در این مدلها کیفیت را با پرامپت دقیق، مثال و قالب خروجی کنترل میکنید. تنظیمهایی مثل میزان استدلال هم تعادل بین دقت، سرعت و هزینه را مشخص میکنند.
تمرین؛ یک دستیار کوچک برای خودتان بسازید
حالا نوبت شماست. یکی از این سه پروژه را انتخاب کنید و با همان کد پایه بسازید:
- برنامهی دستور پخت را کاملتر کنید و با پرامپتها و تنظیمات مختلف آزمایش کنید.
- یک «همدرس» بسازید که دربارهی یک موضوع، مثلاً پایتون، درس کوتاه همراه تمرین و پاسخ پیشنهاد دهد.
- یک ربات تاریخ بسازید که نقش یک شخصیت تاریخی را بازی کند و با لحن همان دوره جواب دهد.
برای پروژهی مشترک مجموعه، گزینهی دوم را به دستیار دورهها نزدیک کنید. فهرست چند دوره را در پرامپت بگذارید و از برنامه بخواهید بر اساس سطح کاربر یک دوره پیشنهاد دهد.
سخن پایانی
ساخت برنامه تولید متن با هوش مصنوعی از آنچه به نظر میرسد سادهتر است. یک کتابخانه، یک کلید و چند خط کد کافی است تا پرامپتهایتان داخل برنامهی واقعی کار کنند. با این حال نکتهی اصلی اینجاست که پرامپت حالا بخشی از منطق برنامه است. پس باید آن را مثل کد نوشت، آزمایش کرد و نگه داشت. شما کدام یک از سه پروژهی تمرین را اول میسازید؟
در قسمت چهارم همین برنامه را به یک چتبات تبدیل میکنیم که گفتوگو را به خاطر میسپارد و رفتار مشخصی دارد.
این آموزش بر پایهی درس Building Text Generation Applications از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- تکنیکهای پرامپت نویسی پیشرفته: قسمت دوم همین مجموعه؛ پرامپتی که داخل برنامه میگذارید با این تکنیکها بهتر میشود؛ برای مبتدی.
- Building Text Generation Applications (انگلیسی): درس اصلی مایکروسافت با نسخهی Azure و نوتبوک تمرین؛ برای مبتدی تا متوسط.
- Text generation در مستندات OpenAI (انگلیسی): راهنمای رسمی Responses API، نقش پیامها و قالب خروجی؛ برای متوسط.
- کتابخانهی openai-python در GitHub (انگلیسی): نمونهکدهای رسمی، اتصال Azure، مدیریت خطا و تلاش دوباره؛ برای متوسط.
- Reasoning models در مستندات OpenAI (انگلیسی): چرا max_output_tokens در مدلهای استدلالی رفتار متفاوتی دارد و میزان استدلال چطور تنظیم میشود؛ برای متوسط تا پیشرفته.
پرسشهای پرتکرار
برای ساخت برنامه تولید متن چه پیشنیازی لازم است؟
آشنایی مقدماتی با پایتون، نصب Python روی سیستم و یک کلید API از سرویس مدل زبانی مثل OpenAI یا Azure OpenAI. بقیهی کار با نصب کتابخانهی openai و چند خط کد انجام میشود.
فرق استفاده از API و کتابخانه چیست؟
در روش API خودتان درخواست وب را میسازید و پاسخ را میخوانید. کتابخانهها همین درخواستها را در چند تابع ساده بستهبندی میکنند و کار را سریعتر و کمخطاتر میکنند.
چرا نباید کلید API را داخل کد بنویسم؟
کد معمولاً در گیت ذخیره یا با دیگران به اشتراک گذاشته میشود. کلیدی که داخل کد باشد بهراحتی لو میرود و هر کسی میتواند به حساب شما هزینه بسازد. کلید را در متغیر محیطی یا یک فایل env جداگانه نگه دارید.
چرا مدلهای جدید پارامتر temperature را قبول نمیکنند؟
مدلهای استدلالی مثل gpt-5 و gpt-5-mini پارامترهای نمونهگیری مثل temperature و top_p را پشتیبانی نمیکنند یا فقط مقدار پیشفرض را میپذیرند. در این مدلها کیفیت خروجی را با پرامپت دقیق و تنظیمهای مخصوص استدلال کنترل میکنید.
max_output_tokens چه کاربردی دارد؟
حداکثر طول پاسخ مدل را بر حسب توکن تعیین میکند. چون هزینه بر اساس توکن محاسبه میشود، این پارامتر هزینه را هم کنترل میکند. در مدلهای استدلالی این سقف توکنهای استدلال پنهان را هم شامل میشود؛ پس اگر خیلی کم باشد، پاسخ ناقص یا حتی خالی برمیگردد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.