
اجرای همزمان ایجنتها وسوسهانگیز است؛ چرا سه کار را پشت سر هم انجام دهیم وقتی میشود همزمان انجامشان داد؟ اجرای همزمان واقعاً میتواند زمان انتظار کاربر را کم کند. اما فقط وقتی کارها واقعاً مستقل باشند. نمیتوان خلاصهی نهایی را پیش از رسیدن منابع نوشت و انتظار نتیجهی قابلاعتماد داشت.
در قسمت قبل الگوی ترتیبی و طراحی وضعیت را دیدیم. در این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز، دو الگو را کنار هم میگذاریم و میبینیم کی کدام را انتخاب کنیم. بعد الگوی پخش و جمع را با پایتون میسازیم و مهمترین مشکلش را حل میکنیم: وقتی یکی از شاخهها شکست میخورد چه باید کرد؟
اجرای ترتیبی؛ خط تولید ایجنتها
در اجرای ترتیبی، ایجنتها مثل ایستگاههای یک خط تولید پشت سر هم کار میکنند. خروجی هر ایجنت ورودی ایجنت بعدی است. ایجنت دوم تا کار اولی تمام نشود شروع نمیکند.
کاربردهای ترتیبی
این الگو برای کارهایی مناسب است که هر مرحله به نتیجهی مرحلهی قبل نیاز دارد. نمونههای رایجش خط پردازش سند است: دریافت، تحلیل، خلاصه و گزارش. یا گردش تولید محتوا: تحقیق، پیشنویس، بازبینی و انتشار. یا زنجیرهی کنترل کیفیت که هر مرحله معیار خودش را دارد.
مزیت اصلی اجرای ترتیبی سادگی و قابلیت اطمینان است. مسیر روشن است، هر مرحله جداگانه قابل آزمون است و زمینه بهطور کامل از مرحلهای به مرحلهی بعد میرسد. اشکالزدایی هم ساده است؛ اگر نتیجهی نهایی اشتباه بود، خروجی مرحلهها را یکییکی بررسی میکنید.
هزینهی ترتیبی بودن
عیب اجرای ترتیبی سرعت است. زمان کل برابر مجموع زمان همهی مرحلههاست. اگر هر فراخوانی مدل پنج ثانیه طول بکشد و چهار مرحله داشته باشید، کاربر دستکم بیست ثانیه منتظر میماند.
این زمان برای کاری که در پسزمینه اجرا میشود قابلقبول است. اما برای دستیاری که کاربر منتظر پاسخش است، ممکن است زیاد باشد. همینجاست که اجرای همزمان به کار میآید.
اجرای همزمان ایجنتها؛ پخش و جمع
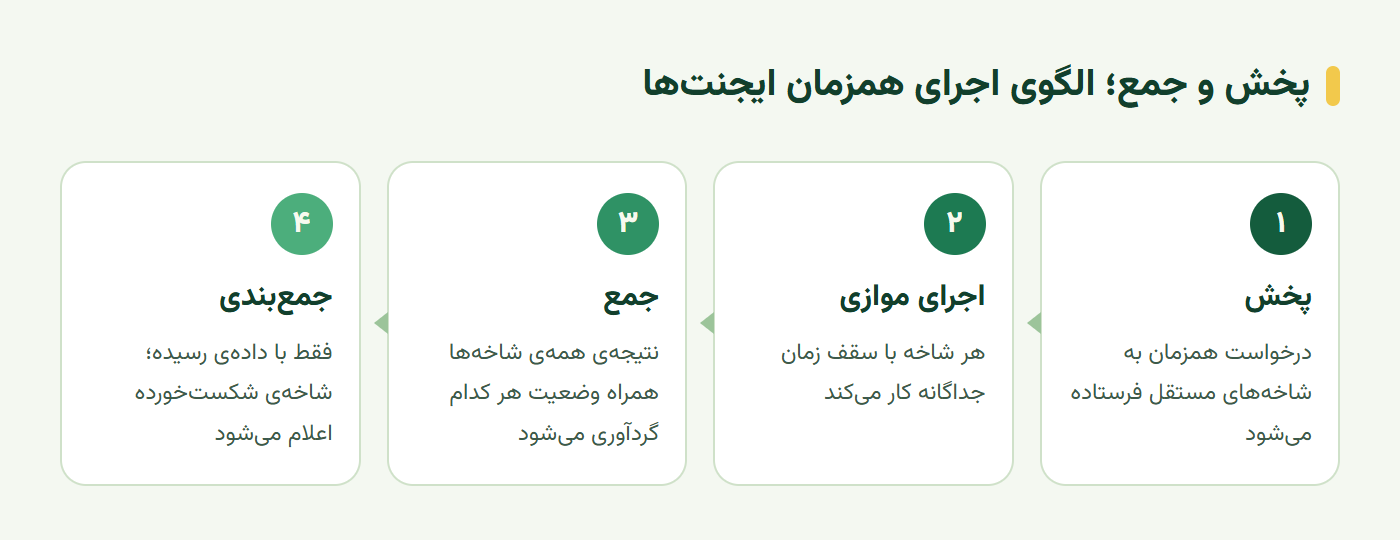
در اجرای همزمان، ایجنتها موازی روی بخشهای مختلف یک کار کار میکنند. الگوی اصلی آن پخش و جمع (fan-out و fan-in) است. در مرحلهی پخش، یک ورودی همزمان به چند شاخه فرستاده میشود. در مرحلهی جمع، نتیجهی همهی شاخهها گردآوری و ترکیب میشود.
مثال درسنامه؛ برنامهی سفر
درسنامهی مایکروسافت مثال روشنی دارد. کاربر برنامهی سفر به سیاتل در ماه دسامبر را میخواهد. درخواست همزمان به دو ایجنت فرستاده میشود. ایجنت پژوهشگر جاذبهها، آبوهوا و نکات کلیدی سفر را پیدا میکند. ایجنت برنامهریز بهطور مستقل برنامهی روزبهروز را میسازد.
در پایان، جمعکننده خروجی هر دو را کنار هم میگذارد. چون این دو کار به هم وابسته نیستند، اجرای همزمانشان زمان کل را تقریباً نصف میکند. در Microsoft Agent Framework سازندهی مخصوصی برای همین الگو وجود دارد که منطق پخش و جمع را مدیریت میکند.
کاربردهای همزمان
الگوی همزمان در چند نوع کار رایج است. پژوهش موازی که چند ایجنت هر کدام یک منبع را بررسی میکنند. پردازش داده از چند منبع که هر منبع جداگانه پردازش و در پایان یکپارچه میشود. تولید محتوای چندگانه که چند نسخه همزمان ساخته و بعد بهترین انتخاب میشود.
در همهی این موارد، یک شرط مشترک وجود دارد: شاخهها به هم وابسته نیستند. اگر شاخهای به خروجی شاخهی دیگر نیاز داشته باشد، دیگر نمیتواند همزمان اجرا شود.
ترتیبی یا همزمان؟ یک قاعدهی ساده
انتخاب میان دو الگو با یک پرسش ساده شروع میشود: آیا این مرحله به خروجی مرحلهی دیگری نیاز دارد؟ اگر بله، ترتیبی. اگر نه، میتواند همزمان باشد. بیشتر جریانهای واقعی ترکیبیاند؛ بخشی همزمان و بخشی ترتیبی.
مقایسهی دو الگو
جدول زیر دو الگو را از جنبههای مختلف مقایسه میکند.
| جنبه | اجرای ترتیبی | اجرای همزمان |
|---|---|---|
| زمان کل | مجموع زمان مرحلهها | زمان کندترین شاخه |
| هزینهی کل | یکسان | یکسان؛ همان تعداد فراخوانی |
| وابستگی مرحلهها | مجاز | ممنوع |
| اشکالزدایی | ساده | پیچیدهتر |
| رفتار هنگام شکست | توقف در همان مرحله | شکست جزئی؛ باید مدیریت شود |
| محدودیت نرخ سرویس | معمولاً مشکلی نیست | ممکن است به سقف برسد |
هزینه یکسان است، نه کمتر
یک سوءتفاهم رایج این است که اجرای همزمان ارزانتر است. اینطور نیست. همان تعداد فراخوانی مدل انجام میشود؛ فقط زمان انتظار کمتر است. حتی گاهی اجرای همزمان زیاد، به سقف نرخ درخواست سرویس میخورد و خطا یا کندی بیشتری میآورد.
پس تعداد شاخههای همزمان را محدود کنید. برای ده منبع، شاید بهتر باشد سهتا سهتا اجرا کنید تا همه را یکجا بفرستید.
پیادهسازی پخش و جمع با پایتون
حالا الگوی پخش و جمع را با کتابخانهی استاندارد asyncio پایتون میسازیم. سناریو مقایسهی سه دوره است؛ اسناد هر دوره جداگانه خوانده میشود:
import asyncio

async def read_course(course_id: str, fetch, timeout: float = 20) -> dict:
    try:
        text = await asyncio.wait_for(fetch(course_id), timeout=timeout)
        return {"course_id": course_id, "ok": True, "text": text}
    except asyncio.TimeoutError:
        return {"course_id": course_id, "ok": False, "error": "timeout"}
    except Exception as e:
        return {"course_id": course_id, "ok": False, "error": str(e)}

async def compare(course_ids: list[str], fetch, summarize):
    branches = await asyncio.gather(*(read_course(c, fetch) for c in course_ids))  # پخش
    ok = [b for b in branches if b["ok"]]
    failed = [b["course_id"] for b in branches if not b["ok"]]                      # جمع
    summary = await summarize(ok) if ok else None
    return {"summary": summary, "missing": failed, "complete": not failed}
هر شاخه سقف زمان خودش را دارد. اگر خواندن یک دوره بیش از حد طول بکشد، فقط همان شاخه شکست میخورد و بقیه منتظر نمیمانند. خروجی هر شاخه هم وضعیت دارد؛ موفق یا ناموفق، همراه دلیل.
جمعبندی صادقانه
مهمترین بخش کد، مرحلهی جمع است. جمعبندی فقط با دادههای رسیده ساخته میشود و فهرست دورههای گمشده جداگانه برمیگردد. فیلد complete هم مشخص میکند نتیجه کامل است یا جزئی.
در لایهی نمایش، این اطلاعات باید به کاربر برسد. پاسخی مثل «دو دوره را مقایسه کردم؛ اطلاعات دورهی سوم در دسترس نبود» صادقانه و مفید است. جمعبندیای که جای خالی را با حدس پر کند، هرچند کامل به نظر برسد، خطرناک است.
سناریوی عملی؛ مقایسهی سه دوره
دستیار برای مقایسهی سه دوره باید اسناد هر کدام را بخواند و در پایان یک جمعبندی بسازد. خواندن اسناد سه دوره به هم وابسته نیست؛ پس کاندید خوبی برای اجرای همزمان است. نمودار زیر الگوی پخش و جمع این سناریو را نشان میدهد.
ورودی و معیار پذیرش
ورودی آزمون سه شناسهی دوره و معیارهای یکسان مقایسه است. یک نمونهی ناقص هم بگذارید؛ مثلاً شناسهای که سندش در دسترس نیست. اقدام مورد بررسی، خواندن مستقل منابع بهصورت همزمان و جمعبندی پس از تکمیل شاخههاست.
معیار پذیرش سه بخش دارد: زمان کل، پوشش هر سه منبع و مشخص بودن شاخهی شکستخورده. نسخهی ترتیبی همین جریان را هم بسازید و زمان و کیفیت دو نسخه را مقایسه کنید. اگر کیفیت یکسان و زمان همزمان بهطور محسوسی کمتر بود، اجرای همزمان ارزشش را دارد.
نمونهی شکست؛ مقایسهی کامل با دادهی ناقص
شکستی که باید عمداً دنبالش بگردید این است: ساخت مقایسهی کامل در حالی که اطلاعات یکی از دورهها نرسیده است. مدل که ستون سوم جدول مقایسه را خالی میبیند، ممکن است آن را با اطلاعات عمومی یا حدس پر کند.
این خطا را با قطع عمدی یکی از شاخهها بازسازی کنید. بعد بررسی کنید آیا خروجی فیلد missing را درست پر میکند و آیا جمعبندی نهایی کمبود داده را اعلام میکند یا نه.
تمرین عملی؛ دو نسخه و گزارش مقایسه
خروجی این تمرین دو نسخهی جریان کار و گزارش مقایسهی سرعت و کیفیت است:
- نسخهی ترتیبی خواندن سه دوره را با یک حلقهی ساده بسازید.
- نسخهی همزمان را با کد بالا بسازید و در هر دو، زمان کل را اندازه بگیرید.
- یکی از شاخهها را عمداً با تأخیر یا خطا روبهرو کنید و رفتار هر دو نسخه را مقایسه کنید.
مشخص کنید کدام بخش را واقعاً اجرا کردهاید و کدام هنوز فرض است.
سخن پایانی
اجرای همزمان ایجنتها ابزاری برای کم کردن زمان انتظار است، نه برای کم کردن هزینه. فقط وقتی به کار میآید که شاخهها واقعاً مستقل باشند. الگوی ترتیبی سادهتر و قابلاعتمادتر است و برای مرحلههای وابسته تنها گزینه است. بیشتر جریانهای واقعی ترکیب هر دو هستند. در اجرای همزمان هم سقف زمان هر شاخه، محدودیت تعداد شاخهها و جمعبندی صادقانه با اعلام شاخههای شکستخورده، سه اصلیاند که سرعت را بدون قربانی کردن درستی به دست میدهند.
در قسمت بعد مسیریابی شرطی درخواستها را میبینیم؛ چه وقت پاسخ بدهیم و چه وقت ارجاع دهیم.
این آموزش بر پایهی نمونههای گردش کار ترتیبی و همزمان Microsoft Agent Framework در مجموعهی آزاد AI Agents for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
کی باید ایجنتها را همزمان اجرا کرد؟
وقتی کارها واقعاً از هم مستقلاند و خروجی یکی ورودی دیگری نیست؛ مثلاً خواندن اسناد سه دورهی مختلف یا پرسوجو از چند منبع جداگانه. اگر مرحلهای به نتیجهی مرحلهی دیگر نیاز دارد، باید ترتیبی اجرا شود.
الگوی پخش و جمع (fan-out و fan-in) چیست؟
در مرحلهی پخش، یک ورودی همزمان به چند ایجنت یا شاخه فرستاده میشود. در مرحلهی جمع، خروجی همهی شاخهها گردآوری و در یک نتیجهی نهایی ترکیب میشود.
اگر یکی از شاخههای همزمان شکست بخورد چه کنیم؟
نتیجه را با وضعیت هر شاخه جمع کنید، نه فقط با دادههای موفق. جمعبندی نهایی باید صادقانه بگوید کدام بخش داده ندارد، بهجای اینکه جای خالی را با حدس پر کند.
آیا اجرای همزمان همیشه ارزانتر است؟
نه. اجرای همزمان زمان انتظار را کم میکند اما هزینهی کل را کم نمیکند؛ همان تعداد فراخوانی مدل انجام میشود. گاهی به دلیل محدودیت نرخ سرویس، اجرای همزمان زیاد حتی خطا و کندی بیشتری میآورد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.