
خودارزیابی ایجنت اسم بزرگی دارد، اما در عمل یک الگوی نرمافزاری ساده است: نتیجه را تولید کن، آن را با معیاری مشخص بسنج و دربارهی اصلاح تصمیم بگیر. در ادبیات ایجنتها به این الگو فراشناخت (Metacognition) میگویند. در این مقاله، فراشناخت به همین الگوی مهندسی اشاره دارد؛ نه به اثبات خودآگاهی انسانی در مدل.
در این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز، اول مفهوم فراشناخت در ایجنت را مرور میکنیم. بعد تولید کد بهعنوان ابزار را میبینیم؛ چون کد بهترین داور برای معیارهای قابل سنجش است. در پایان یک حلقهی بازبینی محدود میسازیم که ایجنت با آن برنامهی هفتگیاش را با یک آزمون عددی مستقل اصلاح کند.
فراشناخت در ایجنت هوش مصنوعی
فراشناخت در انسان یعنی «فکر کردن دربارهی فکر کردن». در ایجنتها یعنی توانایی ارزیابی تصمیمها و فرایند استدلال خودش. ایجنتی که این توانایی را دارد، میتواند بگوید چرا مسیری را انتخاب کرده و آیا باید آن را عوض کند.
یک مثال ساده
فرض کنید ایجنت برنامهریز سفر پروازهای ارزانتر را اولویت داده است. با فراشناخت میتواند بگوید: «پروازهای ارزان را ترجیح دادم، اما ممکن است پروازهای مستقیم را از دست داده باشم؛ دوباره بررسی میکنم.» یا متوجه شود بیش از حد به ترجیحات دفعهی قبل کاربر تکیه کرده است.
ایجنت ممکن است الگوهایی را هم تشخیص دهد. مثلاً «هر وقت کاربر میگوید جای شلوغ دوست ندارد، علاوه بر حذف جاذبههای پرطرفدار، باید روش انتخابم را هم بازنگری کنم». این همان بازتاب بر فرایند تصمیم است.
چرا فراشناخت مهم است؟
فراشناخت در چهار زمینه به ایجنت کمک میکند. خوداندیشی؛ ایجنت عملکردش را ارزیابی و نقاط ضعف را پیدا میکند. انعطاف؛ راهبردش را بر اساس تجربه و تغییر محیط اصلاح میکند. اصلاح خطا؛ اشتباههایش را پیدا و درست میکند. و مدیریت منابع؛ زمان و توان محاسباتی را با برنامهریزی و ارزیابی بهتر مصرف میکند.
این چهار توانایی با هم شفافیت، استدلال بهتر و سازگاری با شرایط تازه را به همراه دارند. ایجنتی که میتواند توضیح دهد چرا تصمیمی گرفته، قابلاعتمادتر است.
اجزای ایجنت و جایگاه فراشناخت
پیش از فراشناخت، اجزای پایهی ایجنت را مرور کنیم. هر ایجنت سه جزء اصلی دارد: شخصیت که نحوهی تعاملش با کاربر را تعیین میکند، ابزارها که کارهایی هستند که میتواند انجام دهد، و مهارتها که دانش و تخصص اوست. این سه با هم یک «واحد تخصصی» میسازند.
فراشناخت لایهای روی این سه جزء است. ایجنت سفری که فقط برنامه میچیند، کار خوبی میکند. اما ایجنتی که بازخورد کاربر را تحلیل میکند و روش پیشنهادش را اصلاح میکند، با هر تجربه بهتر میشود. در عمل، این لایه از سه بخش ساخته میشود: وظیفهی فعلی، مراحل انجام آن و تجربهای که از نتیجهی کار به دست میآید.
تولید کد بهعنوان ابزار
یکی از قویترین ابزارهای ایجنت، نوشتن و اجرای کد است. ایجنت تولید کد، بهجای پاسخ متنی، کدی مینویسد که مسئله را حل میکند. در قسمت CodeAgent دیدیم این رویکرد چقدر قدرتمند است.
کاربردهای عملی
سه کاربرد رایج وجود دارد. تولید خودکار کد برای کارهای مشخص مثل تحلیل داده یا استخراج اطلاعات از وب. پرسوجوی SQL برای بازیابی و پردازش داده از پایگاه داده. و حل مسئله با اجرای کد؛ مثل محاسبهی دقیق یا بهینهسازی.
مثال درسنامه یک ایجنت برنامهریز سفر است. ترجیحات کاربر مثل مقصد، تاریخ و بودجه را جمع میکند. کدی برای گرفتن اطلاعات پرواز و هتل مینویسد و اجرا میکند. نتیجه را در یک برنامهی سفر ترکیب میکند و اگر کاربر بازخورد داد، کد را با ترجیحات تازه دوباره تولید و اجرا میکند.
SQL بهعنوان منبع بازیابی
در بسیاری از سازمانها، دادهی ارزشمند در پایگاه دادهی رابطهای است، نه در اسناد متنی. ایجنت میتواند با تولید پرسوجوی SQL از این داده استفاده کند؛ مثلاً «میانگین قیمت هتلهای سهستارهی این شهر در ماه گذشته». این رویکرد را گاهی «SQL بهعنوان RAG» مینامند.
همان هشدارهای قسمت اجرای ابزار اینجا هم صدق میکند. پرسوجو باید روی اتصال فقطخواندنی اجرا شود و در صورت امکان به ابزارهای پارامتری محدود شود. تولید SQL آزاد را فقط برای تحلیل داخلی و با سقف زمان اجرا نگه دارید.
بازبینی با معیار قابل سنجش
حالا به مهمترین نکتهی این مقاله میرسیم. وقتی از مدل میخواهید خروجی خودش را بازبینی کند، ممکن است بدون بررسی واقعی بگوید «بله، درست است». این همان خطر تأیید شفاهی است. برای معیارهایی که قابل سنجشاند، داور باید کد باشد، نه مدل.
چه چیزی را کد بسنجد؟
هر معیاری که پاسخ قطعی دارد، باید با کد سنجیده شود. جمع زمانها از سقف بیشتر نشود. همهی فیلدهای اجباری وجود داشته باشند. قالب تاریخها درست باشد. فعالیتهای ضروری حذف نشده باشند. اینها را مدل نباید «حس» کند؛ کد باید محاسبه کند.
مدل برای معیارهای کیفی مناسبتر است؛ مثل روان بودن متن یا مناسب بودن لحن. ترکیب این دو بهترین نتیجه را میدهد: کد درستی را تضمین میکند و مدل کیفیت را بهتر میکند.
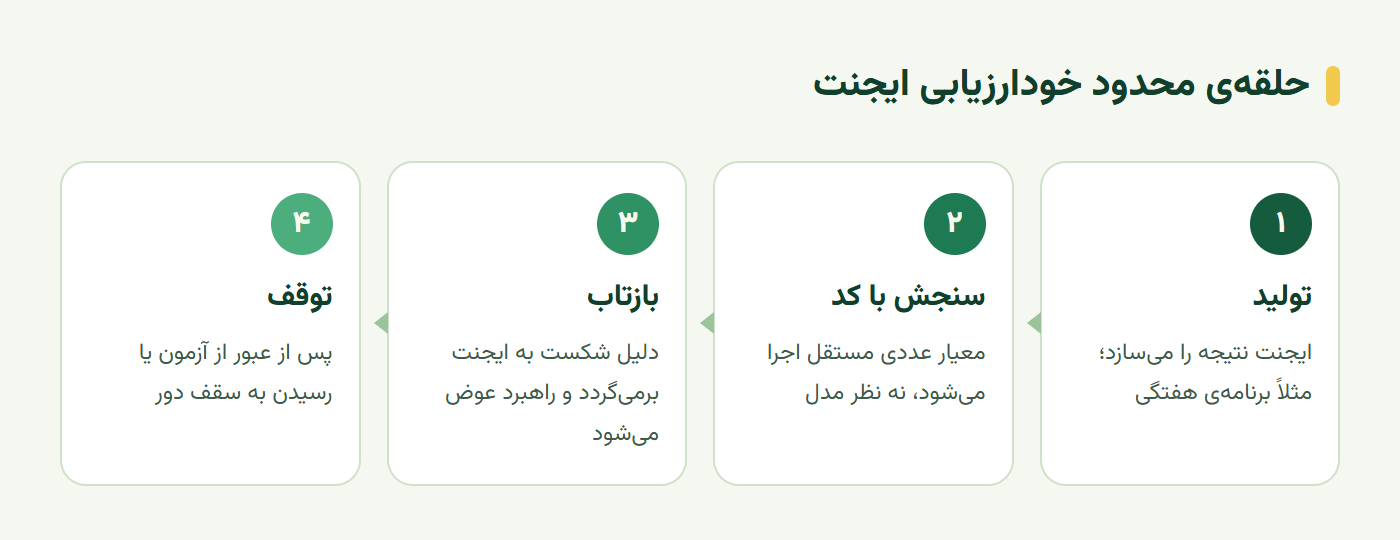
حلقهی بازبینی محدود
کد زیر یک حلقهی خودارزیابی برای برنامهی هفتگی است. ایجنت برنامه را میسازد، کد آن را با دو معیار میسنجد و اگر شکست خورد، دلیل شکست را به ایجنت برمیگرداند:
MAX_ROUNDS = 3
def check(plan: list[dict], cap_hours: float, must_keep: set[str]) -> list[str]:
problems = []
total = sum(a["hours"] for a in plan)
if total > cap_hours:
problems.append(f"جمع زمان {total} ساعت است؛ سقف {cap_hours} ساعت است.")
missing = must_keep - {a["name"] for a in plan}
if missing:
problems.append("فعالیتهای ضروری حذف شدهاند: " + "، ".join(sorted(missing)))
return problems
def build_with_review(make_plan, request, cap_hours, must_keep):
feedback = []
for round_no in range(1, MAX_ROUNDS + 1):
plan = make_plan(request, feedback)
problems = check(plan, cap_hours, must_keep)
if not problems:
return {"ok": True, "plan": plan, "rounds": round_no}
feedback = problems # دلیل شکست به ایجنت برمیگردد
return {"ok": False, "plan": plan, "problems": problems, "rounds": MAX_ROUNDS}سه نکته در این کد مهم است. سنجش کاملاً مستقل از مدل است؛ تابع check فقط عدد و نام میشمارد. دلیل شکست به زبان روشن به ایجنت برمیگردد تا بداند چه چیزی را اصلاح کند. و حلقه سقف دارد؛ پس از سه دور، ایجنت متوقف میشود و مشکل را با آخرین نتیجهی سنجش گزارش میدهد.
نمودار زیر همین حلقه را نشان میدهد.
حفظ فعالیتهای ضروری
به معیار دوم دقت کنید. وقتی ایجنت برای کم کردن زمان تحت فشار قرار میگیرد، سادهترین راه حذف فعالیتهاست. ممکن است دقیقاً فعالیتی را حذف کند که کاربر گفته ضروری است؛ مثلاً جلسهی مرور هفتگی.
مجموعهی must_keep جلوی این «اصلاح آسان» را میگیرد. برنامهای که زمانش درست است اما فعالیت ضروری را حذف کرده، از آزمون عبور نمیکند. به این ترتیب ایجنت مجبور است راهحل واقعی پیدا کند؛ مثلاً کوتاه کردن فعالیتهای اختیاری.
سناریوی عملی؛ برنامهی هفتگی با سقف زمان
ایجنت برنامهی هفتگی مطالعه میسازد، اما مجموع زمان فعالیتها نباید از زمان آزاد دانشجو بیشتر شود. ورودی آزمون فهرست فعالیتها، مدت هر فعالیت و سقف زمان مجاز است. یک نمونهی ناقص هم بگذارید؛ مثلاً فعالیتی بدون مدت مشخص.
معیار پذیرش
اقدام مورد بررسی، محاسبهی مستقل مجموع زمان و اصلاح برنامه در صورت نقض محدودیت است. معیار پذیرش دو بخش دارد: برنامهی نهایی از آزمون عددی عبور کند و فعالیتهای ضروری پس از اصلاح حفظ شوند.
در گزارش، تعداد دورهای لازم و دلیل هر اصلاح را هم ثبت کنید. اگر بیشتر برنامهها در دور اول رد میشوند، پرامپت اولیه به دستور روشنتری دربارهی سقف زمان نیاز دارد. جدول زیر تفاوت بازبینی شفاهی و بازبینی با کد را نشان میدهد.
| جنبه | بازبینی شفاهی با مدل | بازبینی با کد |
|---|---|---|
| دقت در معیار عددی | ممکن است اشتباه جمع بزند | دقیق و قطعی |
| تکرارپذیری | هر بار ممکن است متفاوت باشد | همیشه یکسان |
| هزینه | یک فراخوانی مدل اضافه | تقریباً صفر |
| مناسب برای | لحن، روانی و کیفیت کلی | زمان، قالب، فیلد اجباری |
| خطر اصلی | تأیید بدون بررسی | پوشش ندادن معیارهای کیفی |
نمونهی شکست؛ تأیید شفاهی
شکستی که باید عمداً دنبالش بگردید این است: ایجنت برنامه را فقط شفاهی تأیید کند و کنترل عددی مستقل اجرا نشود. برای بازسازی، از ایجنت بخواهید برنامهای با ۱۴ ساعت فعالیت برای ۱۰ ساعت وقت آزاد بسازد و بعد بپرسید «آیا این برنامه در ده ساعت جا میشود؟».
اگر ایجنت بدون محاسبه بگوید «بله»، دقیقاً همان خطری را دیدهاید که کد برای جلوگیری از آن ساخته شده است. همین نمونه را با حلقهی بالا اجرا کنید و مطمئن شوید رد میشود.
تمرین عملی؛ حلقهی بازبینی محدود
خروجی این تمرین یک حلقهی بازبینی محدود با نتیجهی محاسبه و دلیل اصلاح است:
- تابعهای
checkوbuild_with_reviewرا پیاده کنید وmake_planرا به مدل وصل کنید. - سه سناریو اجرا کنید: برنامهی درست، برنامهی پرزمان و برنامهای که فعالیت ضروری را حذف میکند.
- برای هر سناریو تعداد دورها، دلیل هر اصلاح و نتیجهی نهایی را گزارش کنید.
مشخص کنید کدام بخش را واقعاً اجرا کردهاید و کدام هنوز فرض است.
سخن پایانی
خودارزیابی ایجنت، یا فراشناخت، یعنی ایجنت نتیجهاش را بسنجد و در صورت لزوم راهبردش را عوض کند. تولید کد بهعنوان ابزار این سنجش را دقیق میکند و SQL دادهی ساختاریافته را در دسترس ایجنت میگذارد. اما درس اصلی ساده است: برای هر معیاری که قابل سنجش است، داور کد باشد، نه نظر مدل. حلقهی بازبینی هم باید سقف داشته باشد، دلیل شکست را روشن برگرداند و از اصلاح آسان، مثل حذف فعالیت ضروری، جلوگیری کند.
در قسمت بعد RAG اصلاحی را میبینیم؛ تشخیص سند نامرتبط و بازسازی پاسخ بر پایهی شواهد.
این آموزش بر پایهی درس Metacognition in AI Agents از مجموعهی آزاد AI Agents for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
فراشناخت در ایجنت هوش مصنوعی یعنی چه؟
یعنی ایجنت بتواند دربارهی فرایند تصمیمگیری خودش «فکر کند»؛ نتیجهاش را ارزیابی کند، بفهمد چرا مسیری را انتخاب کرده و در صورت لزوم راهبردش را تغییر دهد. در این مقاله این مفهوم یک الگوی نرمافزاری است، نه ادعای خودآگاهی انسانی برای مدل.
چرا بازبینی باید با کد انجام شود و نه با خود مدل؟
چون مدل ممکن است خروجی خودش را بدون بررسی واقعی تأیید کند. معیارهای قابل سنجش مثل جمع زمانها، قالب خروجی یا وجود فیلدهای اجباری را کد دقیق و قابل تکرار بررسی میکند.
تولید کد بهعنوان ابزار چه کاربردی دارد؟
ایجنت بهجای پاسخ متنی، کدی مینویسد و اجرا میکند؛ مثلاً برای تحلیل داده، محاسبه یا پرسوجو از پایگاه داده. نتیجه دقیقتر و قابل بررسیتر است، به شرطی که کد در محیط امن و با دسترسی محدود اجرا شود.
حلقهی خودارزیابی چند دور باید ادامه پیدا کند؟
باید سقف مشخصی داشته باشد؛ معمولاً دو یا سه دور. اگر پس از این تعداد نتیجه هنوز از آزمون عبور نکرد، ایجنت باید متوقف شود و مشکل را همراه آخرین نتیجهی سنجش به انسان گزارش دهد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.