
RAG اصلاحی پاسخی به یک خطای رایج در سیستمهای RAG است. وجود چند قطعه متن در ورودی مدل تضمین نمیکند پاسخ مستند باشد. ممکن است سند بازیابیشده مربوط به دورهی دیگری باشد، نسخهی قدیمی باشد یا فقط بخشی از پرسش را پوشش دهد. مدل هم معمولاً با همان متنی که دارد، پاسخی روان و مطمئن میسازد.
در این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز، RAG اصلاحی را میسازیم. یعنی RAG با یک مرحلهی بررسی پیش از تولید پاسخ. ابتدا آن را با بارگذاری پیشاپیش زمینه مقایسه میکنیم. سپس داوری تناسب، بازچینی و جستجو بر اساس نیت را میبینیم. در پایان هم سناریویی را حل میکنیم که جستجو اول سند نسخهی قدیمی را پیدا میکند.
RAG یا بارگذاری پیشاپیش زمینه؟
دو راه اصلی برای دادن دانش بیرونی به ایجنت وجود دارد. در RAG، سیستم بازیابی هنگام هر پرسش اسناد مرتبط را از منبع بیرونی پیدا میکند و به مدل میدهد. در مقابل، در بارگذاری پیشاپیش زمینه، اطلاعات پیش از هر پرسش در زمینهی مدل قرار میگیرد.
فرقشان مثل فرق جزوهی خلاصه با کتابخانه است. جزوهی چندبرگی را سر کلاس همراه دارید و فوری به آن نگاه میکنید. اما وقتی موضوع بزرگ شد، باید به کتابخانه بروید و فقط کتاب مرتبط را بردارید. خطر کتابخانه هم همین است؛ ممکن است کتاب اشتباه یا چاپ قدیمی را بردارید.
کدام را انتخاب کنیم؟
بارگذاری پیشاپیش برای دادهی کم و ثابت مناسب است. مثلاً ایجنت سفری که اطلاعات چند مقصد پرطرفدار را از ابتدا در حافظه دارد، بدون جستجو و سریع پاسخ میدهد. اما وقتی داده زیاد میشود یا مرتب تغییر میکند، دیگر در زمینه جا نمیشود و بهروز نگه داشتنش سخت است.
RAG برای دادهی زیاد و متغیر ساخته شده است. فقط بخش مرتبط به مدل میرسد، پس هزینهی توکن کمتر است و بهروزرسانی داده سادهتر است. در عوض، یک خطر تازه دارد؛ ممکن است سند اشتباه بازیابی شود. RAG اصلاحی دقیقاً برای مدیریت همین خطر ساخته شده است.
RAG بهعنوان تکنیک یا ابزار
RAG را به دو شکل میتوان پیاده کرد. بهعنوان تکنیک پرامپت، شما برای هر پرسش، پرسوجوی جستجو را میسازید، نتیجه را میگیرید و در پرامپت میگذارید. در این حالت کنترل بیشتری دارید، اما کار دستی بیشتری هم لازم است.
در مقابل، بهعنوان ابزار، RAG در معماری ایجنت جاسازی میشود و ایجنت خودش تصمیم میگیرد کی جستجو کند. این روش خودکارتر و برای مقیاس بزرگ کارآمدتر است. جدول زیر دو رویکرد را مقایسه میکند.
| جنبه | RAG بهعنوان تکنیک پرامپت | RAG بهعنوان ابزار ایجنت |
|---|---|---|
| تصمیم به جستجو | کد شما در هر پرسش | ایجنت در صورت نیاز |
| کنترل | بیشتر | کمتر |
| انعطاف | پرامپت سفارشی برای هر نیاز | مناسب مقیاس بزرگ |
| پیچیدگی | ساخت و تنظیم پرامپتها | یکپارچهسازی سادهتر |
RAG اصلاحی چیست؟
RAG اصلاحی (Corrective RAG) بر اصلاح خطاهای بازیابی و بهبود دقت پاسخ تمرکز دارد. این روش سه جزء اصلی دارد؛ پرامپتی که بازیابی درست را هدایت میکند، ابزارهایی که تناسب سند را میسنجند و ارزیابی مداوم برای بهبود عملکرد.
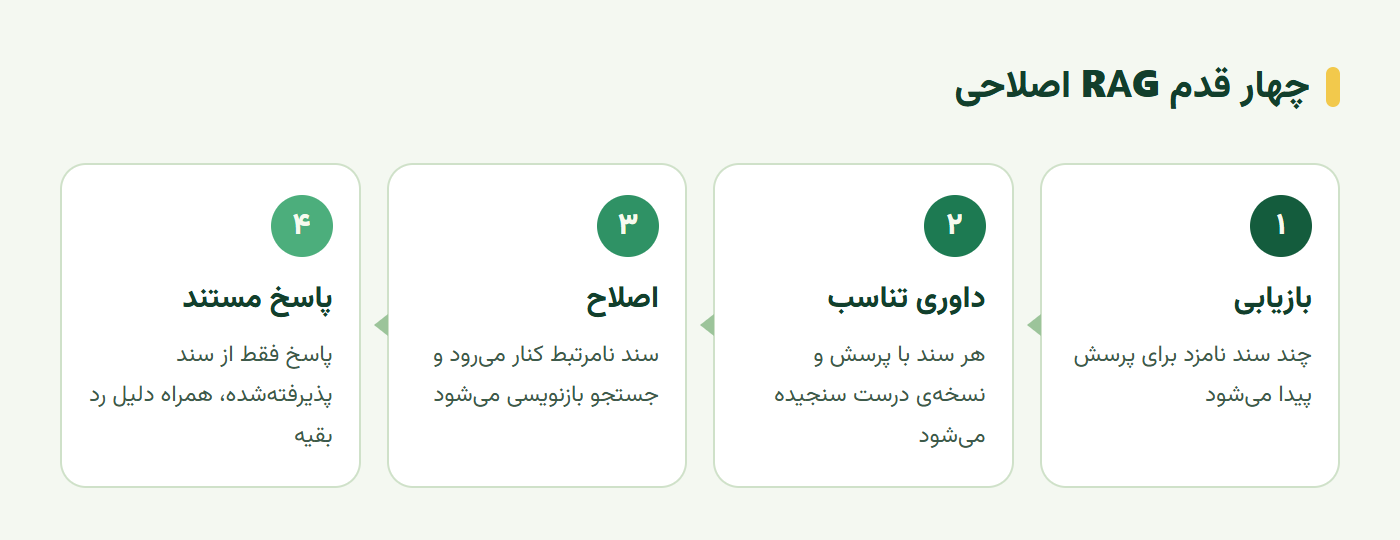
ایدهی اصلی ساده است. پیش از تولید پاسخ، یک داور بررسی میکند آیا هر سند واقعاً به پرسش مربوط است. سپس سندهای نامرتبط کنار میروند. اگر سند مناسبی نماند، پرسوجو بازنویسی و جستجو تکرار میشود. در نهایت پاسخ فقط از سندهای پذیرفتهشده ساخته میشود.
کار داور شبیه کار داروساز است. داروساز پیش از تحویل دارو، نام و دوز روی جعبه را با نسخه مقایسه میکند؛ چون دو جعبهی شبیه ممکن است دوز متفاوت داشته باشند. سند نسخهی قدیمی یک دوره هم همان جعبهی شبیه با دوز متفاوت است. البته داروساز نسخه را خودش میفهمد؛ اما داور RAG فقط همان معیارهایی را میسنجد که شما برایش تعریف کردهاید.
بازچینی و امتیازدهی با مدل
مدلهای زبانی میتوانند نقش داور را بازی کنند. ابتدا بازیابی چند سند نامزد پیدا میکند. سپس در مرحلهی بازچینی، مدل این نامزدها را بر اساس تناسب و کیفیت دوباره مرتب میکند. در مرحلهی امتیازدهی هم به هر نامزد امتیازی میدهد که نشان میدهد چقدر مرتبط است.
مثال درسنامه ایجنت سفری است که مقصدها را بر اساس ترجیحات کاربر بازچینی میکند. ابتدا فهرستی از مقصدهای ممکن بازیابی میشود. بعد مدل آنها را بر اساس بودجه، علاقهها و زمان سفر کاربر امتیاز میدهد و مرتب میکند.
بیشتر بخوانید: بازچینی و بازیابی ترکیبی در RAG پایه را در RAG چیست؟ و حلقهی بازنویسی جستجو را در مدیریت شکست در Agentic RAG دیدهایم.
ارزیابی تناسب؛ چه چیزی یک سند را مرتبط میکند؟
تناسب فقط شباهت معنایی نیست. زیرا سندی ممکن است از نظر برداری به پرسش نزدیک باشد، اما پاسخ درستی نداشته باشد. چهار جنبهی تناسب را باید در نظر گرفت.
چهار جنبهی تناسب
نخست، آگاهی از زمینه؛ داور باید زمینهی پرسش را بفهمد. برای مثال اگر کاربر دربارهی «بهترین رستورانهای پاریس» میپرسد، ترجیحات او مثل نوع غذا و بودجه هم مهم است. دوم، دقت؛ اطلاعات باید درست و بهروز باشد. رستورانی که بسته شده، هرچقدر هم نظرات خوبی داشته، پاسخ درستی نیست.
سوم، نیت کاربر؛ اگر کاربر «هتل ارزان» میخواهد، گزینههای گران حتی اگر عالی باشند، مرتبط نیستند. چهارم، حلقهی بازخورد؛ رتبهبندی و بازخورد کاربران دربارهی پیشنهادهای قبلی، داوری تناسب را بهمرور دقیقتر میکند.
جستجو بر اساس نیت
جستجو بر اساس نیت یعنی پیش از جستجو، هدف پشت پرسش را بفهمیم. نیت کاربر معمولاً یکی از سه نوع است. نیت اطلاعاتی؛ کاربر میخواهد چیزی بداند، مثل «شرایط آزمون این دوره چیست؟». گاهی هم نیت مسیریابی است؛ کاربر میخواهد به منبع مشخصی برسد، مثل «صفحهی ثبتنام دورهی پایتون».
نیت تراکنشی؛ میخواهد کاری انجام دهد، مثل «در این دوره ثبتنامم کن». تشخیص نیت، جستجو را دقیقتر میکند. همچنین تعیین میکند اصلاً جستجو لازم است یا کاربر باید به ابزار دیگری برسد. بنابراین پیام تراکنشی را نباید با RAG جواب داد؛ باید به مسیر اقدام با تأیید برسد.
پیادهسازی داور تناسب
حالا یک داور تناسب ساده میسازیم. این داور برای هر سند دو چیز را بررسی میکند. اول اینکه به همان دوره و نسخهای مربوط است که کاربر پرسیده یا نه. دوم اینکه واقعاً به پرسش پاسخ میدهد یا نه:
from pydantic import BaseModel
from openai import OpenAI
class Grade(BaseModel):
relevant: bool
reason: str
client = OpenAI()
def grade(question: str, doc: dict, course_id: str, version: str) -> Grade:
if doc["course_id"] != course_id or doc["version"] != version:
return Grade(relevant=False, reason=f"سند مربوط به {doc['course_id']} نسخهی {doc['version']} است")
prompt = f"آیا این متن به پرسش پاسخ میدهد؟ فقط بر اساس متن داوری کن.\n\nپرسش: {question}\n\nمتن: {doc['text']}"
return client.responses.parse(model="gpt-5-mini", input=prompt, text_format=Grade).output_parsed
def corrective_answer(question, course_id, version, search, rewrite, answer, max_rounds=2):
query, rejected = question, []
for _ in range(max_rounds):
docs = search(query)
accepted = []
for d in docs:
g = grade(question, d, course_id, version)
item = {"doc": d["id"], "reason": g.reason}
if g.relevant:
accepted.append({**item, "text": d["text"]}) # متن برای ساخت پاسخ لازم است
else:
rejected.append(item)
if accepted:
return {"answer": answer(question, accepted), "sources": accepted, "rejected": rejected}
query = rewrite(question, rejected)
return {"answer": None, "rejected": rejected, "status": "not_found"}به ترتیب بررسیها دقت کنید. بررسی فراداده (Metadata؛ اطلاعات کنار متن مثل دوره و نسخه) پیش از داوری مدل انجام میشود. این بررسی ارزان و قطعی است؛ لازم نیست برای سندی که آشکارا مال دورهی دیگری است، مدل را صدا بزنید. فقط سندهایی که از این فیلتر عبور میکنند، به داوری معنایی مدل میرسند. سندهای پذیرفتهشده همراه متنشان به تابع answer میرسند تا پاسخ فقط از همین شواهد ساخته شود.
ثبت دلیل رد
خروجی تابع فقط پاسخ نیست؛ فهرست سندهای ردشده و دلیل رد هر کدام را هم دارد. چرا اینقدر مهم است؟ این اطلاعات دو کاربرد دارد. اول، بازنویسی جستجو را هدایت میکند؛ ایجنت میداند چرا نتایج قبلی رد شدند.
دوم، اشکالزدایی را ممکن میکند. اگر کاربر گفت پاسخ اشتباه بود، میتوانید ببینید کدام سندها بررسی شدند و چرا پذیرفته یا رد شدند. نمودار زیر چهار قدم این فرایند را نشان میدهد.
سناریوی عملی؛ سند نسخهی قدیمی
دانشجویی دربارهی شرایط آزمون نسخهی جدید یک دوره میپرسد. اما جستجو اول سند نسخهی قبلی را پیدا میکند. این سند از نظر معنا تقریباً یکسان است، ولی شرایط آزمونش عوض شده است.
ورودی و معیار پذیرش
ورودی آزمون سه بخش دارد؛ پرسش، قطعههای بازیابیشده و مشخصات نسخهی هر سند. یک نمونهی عادی و یک نمونهی مشکلدار آماده کنید؛ در نمونهی مشکلدار، سند نسخهی قدیمی بالاترین امتیاز شباهت را دارد.
اقدام مورد بررسی، بررسی تناسب سند و جستجوی دوباره هنگام ناسازگاری نسخه است. معیار پذیرش دو بخش دارد. نخست، پاسخ به سند درست ارجاع دهد. دوم، دلیل کنار گذاشتن نتیجهی قبلی ثبت شود.
نمونهی شکست؛ ترکیب دو دوره
شکستی که باید عمداً دنبالش بگردید این است: ترکیب شرایط دو دوره و ارائهی آن بهعنوان یک پاسخ قطعی. فرض کنید سند دورهی «پایتون مقدماتی» و «پایتون پیشرفته» هر دو بازیابی شدهاند. مدل بدون داور ممکن است مدت یکی و پیشنیاز دیگری را در یک پاسخ ترکیب کند.
این نمونه را با اسناد مشابه اما نامرتبط بازسازی کنید. سپس بررسی کنید آیا داور سند دورهی دیگر را رد میکند. آیا پاسخ نهایی فقط از سند درست ساخته میشود؟
تمرین عملی؛ بازیابی اصلاحی با اسناد مشابه
خروجی این تمرین یک نمونه بازیابی اصلاحی است که با اسناد مشابه اما نامرتبط آزموده شده باشد:
- برای هر قطعهی سند، فرادادهی دوره و نسخه را ذخیره کنید.
- تابعهای
gradeوcorrective_answerرا پیاده کنید. - سناریوی نسخهی قدیمی و سناریوی دو دورهی مشابه را اجرا کنید و فهرست سندهای ردشده و دلایلشان را گزارش کنید.
مشخص کنید کدام بخش را واقعاً اجرا کردهاید و کدام هنوز فرض است.
سخن پایانی
RAG اصلاحی یک مرحلهی ساده اما حیاتی به RAG اضافه میکند؛ داوری تناسب پیش از تولید پاسخ. سندی که مال دوره یا نسخهی دیگری است، با فیلتر ارزان فراداده کنار میرود. سپس سندی که از نظر معنا پاسخ پرسش را ندارد، با داوری مدل رد میشود.
اگر سند مناسبی نماند، جستجو اصلاح و تکرار میشود. در نهایت پاسخ فقط از شواهد پذیرفتهشده ساخته میشود و دلیل رد بقیه ثبت میشود. نتیجه، دستیاری است که شباهت ظاهری فریبش نمیدهد.
در قسمت بعد پایش دستیار در استفادهی واقعی را میبینیم؛ پیدا کردن خطا، هزینه و کندی.
این آموزش بر پایهی بخشهای RAG اصلاحی درس Metacognition in AI Agents از مجموعهی آزاد AI Agents for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- RAG چیست؟: مراحل RAG، بازیابی ترکیبی و بازچینی؛ پیشنیاز همین قسمت، برای مبتدی.
- مدیریت شکست در Agentic RAG: حلقهی بازنویسی جستجو و سقف تلاش؛ برای متوسط.
- Metacognition in AI Agents (انگلیسی): درس اصلی مایکروسافت که بخش RAG اصلاحی این آموزش بر پایهی آن است؛ برای متوسط.
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (انگلیسی): مقالهی اصلی معرفی RAG؛ برای پیشرفته.
- Corrective Retrieval Augmented Generation (انگلیسی): مقالهی پژوهشی CRAG که ارزیاب کیفیت سند و اقدام اصلاحی پس از بازیابی را پیشنهاد میکند؛ برای پیشرفته.
پرسشهای پرتکرار
RAG اصلاحی چه فرقی با RAG معمولی دارد؟
RAG معمولی هر سندی را که بازیابی شد به مدل میدهد. RAG اصلاحی پیش از تولید پاسخ، تناسب هر سند را با پرسش میسنجد، سند نامرتبط را کنار میگذارد و اگر سند مناسبی نماند، جستجو را اصلاح و تکرار میکند.
بارگذاری پیشاپیش زمینه چیست؟
یعنی اطلاعات ثابت و پرکاربرد را پیش از هر پرسش در زمینهی مدل قرار دهیم، بهجای اینکه هر بار جستجو کنیم. برای دادهی کم و ثابت ساده و سریع است؛ برای دادهی زیاد و متغیر، RAG مناسبتر است.
سه نوع نیت کاربر در جستجو کداماند؟
نیت اطلاعاتی که کاربر دنبال دانستن چیزی است، نیت مسیریابی که میخواهد به صفحه یا منبع مشخصی برسد، و نیت تراکنشی که میخواهد کاری مثل ثبتنام یا خرید انجام دهد.
چطور جلوی استفاده از نسخهی قدیمی یک سند را بگیریم؟
نسخه و تاریخ اعتبار را بهعنوان فراداده کنار هر قطعه ذخیره کنید و در داوری تناسب بررسی کنید. سندی که مربوط به دوره یا نسخهی دیگری است، حتی اگر از نظر معنا شبیه باشد، باید کنار گذاشته شود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.