
هوش مصنوعی مسئولانه از یک واقعیت ساده شروع میشود: پاسخ مؤدبانه بهتنهایی نشان نمیدهد یک دستیار قابلاعتماد است. اگر دستیار برای دانشجویی که دو هفته وقت دارد برنامهای غیرواقعی بسازد، یا دربارهی شرایط یک دوره اطلاعات نادرست بدهد، زیبایی متن هیچ کمکی نمیکند.
در این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز، طراحی مسئولانه را از تعریف موقعیتهای شکست شروع میکنیم. چه چیزی ممکن است اشتباه شود؟ چه کسی آسیب میبیند؟ و کاربر چطور میتواند اشتباه را ببیند و اصلاح کند؟ این پرسشها را به چهار گام عملی تبدیل میکنیم.
چرا هوش مصنوعی مسئولانه اولویت است؟
توجه به هوش مصنوعی مولد در چند سال اخیر بهسرعت بالا رفته است. توسعهدهندگان، سرمایه و توجه زیادی به این حوزه آمدهاند. این برای سازندگان محصول خبر خوبی است، اما همین سرعت، خطر بیدقتی را هم بالا میبرد.
ویژگی اصلی هوش مصنوعی مولد، توانایی تولید پاسخ، راهنمایی و محتوا بدون دخالت دستی است. همین توانایی، بدون برنامهریزی درست، میتواند به کاربر، محصول و جامعه آسیب بزند. به همین دلیل رویکرد انسانمحور بهترین نتیجه را میدهد؛ یعنی در نظر گرفتن منافع واقعی کاربر در هر تصمیم.
هوش مصنوعی مسئولانه را مثل قوانین ایمنی آشپزخانهی یک رستوران در نظر بگیرید. سرآشپز غذای خوشمزه میپزد. اما بدون تاریخگذاری مواد، شستن دست و برچسب حساسیت غذایی، همان بشقاب خوشمزه ممکن است کسی را بیمار کند. حد این تشبیه این است که دستورالعمل آشپزخانه ثابت است، ولی رفتار مدل با هر تغییر پرامپت یا داده عوض میشود. پس بررسی هیچوقت تمام نمیشود.
شش اصل هوش مصنوعی مسئولانه
مایکروسافت و بسیاری از سازمانها شش اصل را برای هوش مصنوعی مسئولانه برشمردهاند. این اصول چارچوبی برای همهی تصمیمهای طراحی محصول هستند. در فهرست زیر، هر اصل با یک جملهی ساده آمده است:
- انصاف: سیستم با همهی کاربران برابر رفتار کند و تبعیض قائل نشود.
- فراگیری: محصول برای کاربران متنوع، از جمله افراد دارای معلولیت، قابل استفاده باشد.
- قابلیت اطمینان و ایمنی: سیستم در شرایط مختلف درست و بیخطر کار کند.
- امنیت و حریم خصوصی: دادهی کاربر محافظت شود و بیاجازه استفاده نشود.
- شفافیت: کاربر بداند با هوش مصنوعی کار میکند و محدودیتهایش را بشناسد.
- پاسخگویی: انسانها مسئول تصمیمها و پیامدهای سیستم باشند.
این اصول کلی به نظر میرسند، اما در ادامه میبینیم هر کدام در یک دستیار آموزشی چه شکل مشخصی پیدا میکند. برای مثال، شفافیت یعنی دستیار بگوید پاسخش از کدام سند آمده است. پاسخگویی هم یعنی معلوم باشد اگر برنامهی نادرستی داد، چه کسی آن را بررسی و اصلاح میکند.
سه خطر اصلی در دستیار هوش مصنوعی
بدون برنامهریزی، خروجی مدل ممکن است به سه شکل آسیب بزند. شناختن این سه، اولین قدم برای طراحی آزمون و راهحل است.
پاسخ ساختگی
پاسخ ساختگی، که به آن توهم (Hallucination) هم میگویند، یعنی مدل محتوایی بیمعنا یا نادرست تولید کند. مثل دانشآموزی که سر جلسهی امتحان جواب را نمیداند، اما برگه را خالی نمیگذارد و با خط خوش چیزی سرهم میکند.
فرض کنید دستیاری برای پرسشهای تاریخی ساختهاید و دانشآموزی میپرسد: «تنها بازماندهی کشتی تایتانیک چه کسی بود؟». مدل با اطمینان کامل یک نام میگوید و داستان کاملی هم تعریف میکند.
اما این پاسخ غلط است؛ با کمترین جستجو معلوم میشود صدها نفر از آن حادثه جان سالم به در بردند. مشکل اینجاست که پاسخ آنقدر قانعکننده است که دانشآموز تازهکار آن را حقیقت میپذیرد. نتیجه، از دست رفتن اعتماد به محصول و آسیب به اعتبار کسبوکار است.
مدلهای جدیدتر در این زمینه بهتر شدهاند، اما مشکل کاملاً حل نشده است. سازندهی محصول باید همیشه این محدودیت را در طراحی لحاظ کند. حد تشبیه دانشآموز هم همینجاست: مدل عمداً تقلب نمیکند. بلکه محتملترین متن را میسازد و فرقی میان «درست» و «باورپذیر» نمیگذارد.
محتوای مضر
خطر دوم، پاسخ با محتوای مضر است. این محتوا شامل تشویق به آسیب به خود یا دیگران، محتوای نفرتانگیز و تحقیرآمیز، راهنمایی برای خشونت یا کار غیرقانونی و محتوای جنسی صریح است.
برای یک محصول آموزشی که کاربرانش ممکن است نوجوان باشند، این خطر جدیتر است. محصول باید ابزارها و راهبردهای مشخصی داشته باشد تا چنین محتوایی هرگز به کاربر نرسد.
بیانصافی و سوگیری
انصاف یعنی سیستم از سوگیری و تبعیض خالی باشد و با همه برابر رفتار کند. در هوش مصنوعی مولد، نگرانی این است که خروجی مدل کلیشهها و دیدگاههای تبعیضآمیز دربارهی گروههای مختلف را تقویت کند.
مثلاً دستیاری که همیشه رشتههای فنی را به پسران و رشتههای انسانی را به دختران پیشنهاد دهد، هم تجربهی بدی برای کاربر میسازد و هم به جامعه آسیب میزند. سازندهی محصول باید کاربران متنوع را در طراحی و آزمون در نظر بگیرد.
بیشتر بخوانید: راههای فنی کاهش پاسخ ساختگی، مثل راه خروج در پرامپت و درخواست منبع، را در آموزش پرامپت نویسی از صفر دیدهایم.
چهار گام ساخت دستیار هوش مصنوعی مسئولانه
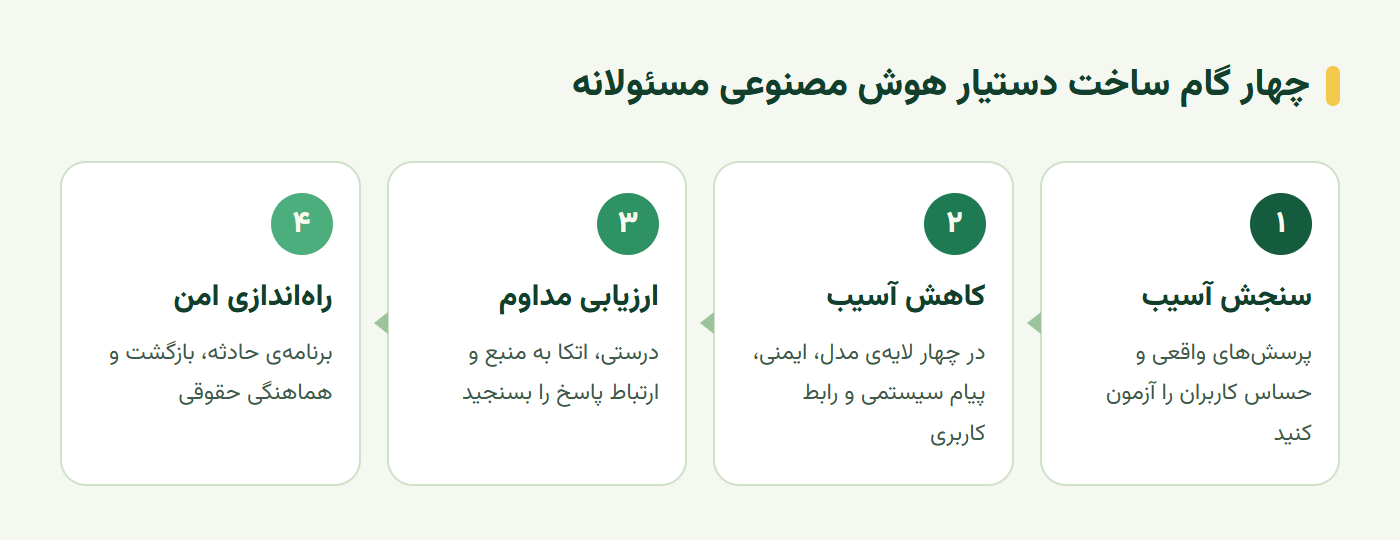
حالا که خطرها را میشناسیم، ببینیم در عمل چه باید کرد. فرایند هوش مصنوعی مسئولانه چهار گام دارد که در نمودار زیر آمده است.
گام اول؛ سنجش آسیبهای احتمالی
در آزمون نرمافزار، کارهایی را که کاربر احتمالاً انجام میدهد آزمایش میکنیم. در هوش مصنوعی هم همین کار را با پرامپت انجام میدهیم. مجموعهای متنوع از درخواستهایی که کاربران احتمالاً میفرستند آماده میکنید و پاسخها را بررسی میکنید.
برای یک محصول آموزشی، این مجموعه باید پرسشهای درسی، حقایق تاریخی، پرسشهای مربوط به زندگی دانشجویی و درخواستهای حساس را پوشش دهد. هرچه این مجموعه به کاربران واقعی نزدیکتر باشد، آسیبهای بیشتری را پیش از انتشار پیدا میکنید.
گام دوم؛ کاهش آسیب در چهار لایه
کاهش آسیب را میتوان در چهار لایه انجام داد. این لایهها شبیه ایمنی یک مدرسهاند: قفل در، نگهبان دم ورودی، آییننامهی کلاس و تابلوهای راهنما. هیچکدام بهتنهایی کافی نیست، اما با هم احتمال آسیب را کم میکنند.
لایهی اول انتخاب مدل مناسب است. مدل بزرگ و همهکاره برای یک کار کوچک و مشخص ممکن است خطر محتوای ناخواسته را بالا ببرد. گاهی مدلی کوچکتر یا تنظیمشده برای همان کار امنتر است.
لایهی دوم سیستم ایمنی پلتفرم است؛ مثل فیلتر محتوای ارائهدهندهی مدل که محتوای مضر را در ورودی و خروجی شناسایی میکند. این سیستم باید حملهها و درخواستهای خودکار رباتها را هم تشخیص دهد.
لایهی سوم پیام سیستمی و اتکا به منبع است. با پیام سیستمی، رفتار و مرزهای مدل را تعیین میکنید. تولید افزوده با بازیابی (RAG) یعنی دادن اسناد معتبر به مدل پیش از پاسخ. با آن، مدل را محدود میکنید که فقط از منابع معتبر پاسخ دهد.
لایهی چهارم رابط کاربری است. میتوانید نوع ورودی کاربر را محدود کنید، منبع پاسخ را نشان دهید و صادقانه بگویید دستیار چه کاری میکند و چه کاری نمیکند.
گام سوم؛ ارزیابی مداوم
کار با مدلهای زبانی چالش دارد، چون کنترل کاملی بر دادهی آموزشی آنها نداریم. به همین دلیل باید خروجی را همیشه ارزیابی کنیم. درستی پاسخ، اتکا به منبع و ارتباط با پرسش سه معیار اصلیاند.
این ارزیابی یکباره نیست. هر تغییر در مدل، پرامپت یا اسناد میتواند رفتار دستیار را عوض کند. ارزیابی منظم هم شفافیت میسازد و هم اعتماد کاربران و ذینفعان را جلب میکند.
گام چهارم؛ راهاندازی امن
آخرین گام، ساختن رویهی عملیاتی پیرامون محصول است. این یعنی همکاری با بخشهای حقوقی و امنیتی تا همهی الزامات قانونی رعایت شود. پیش از راهاندازی، برنامهی مدیریت حادثه و بازگشت به نسخهی قبل را هم آماده کنید.
اگر نسخهی جدید دستیار ناگهان پاسخهای مشکلدار تولید کرد، تیم باید بداند چه کسی تصمیم میگیرد، چطور سرویس متوقف میشود و چطور نسخهی قبلی برمیگردد. این آمادگی، آسیب به کاربر را به حداقل میرساند.
ابزارهای هوش مصنوعی مسئولانه
ساخت محصول مسئولانه ممکن است سنگین به نظر برسد، اما ابزارهای آن روزبهروز بیشتر میشوند. سرویس Azure AI Content Safety با یک درخواست API محتوای مضر را در متن و تصویر شناسایی میکند. ارائهدهندگان دیگر مدل هم فیلترهای مشابهی دارند.
جدول زیر نشان میدهد هر خطر با چه ابزار یا روشی کنترل میشود.
| خطر | روش کنترل | مسئول اجرا |
|---|---|---|
| پاسخ ساختگی | RAG، راه خروج در پیام سیستمی، نمایش منبع | تیم فنی |
| محتوای مضر | فیلتر محتوا، محدودیت ورودی، پیام سیستمی | تیم فنی و محصول |
| سوگیری | آزمون با کاربران متنوع، بازبینی خروجی | تیم محصول |
| نشت داده | کمینهسازی داده، کنترل دسترسی | تیم امنیت |
| حادثه در انتشار | برنامهی بازگشت، پایش پس از انتشار | تیم عملیات |
سناریوی عملی؛ برنامهی مطالعهی دوهفتهای
حالا این اصول را روی یک موقعیت واقعی پیاده میکنیم. کاربری میخواهد در دو هفته برای یک آزمون آماده شود. دستیار باید زمان آزاد و سطح فعلی او را در نظر بگیرد و برنامهای واقعبینانه پیشنهاد دهد.
ورودی و رفتار مورد انتظار
ورودی آزمون سه بخش دارد: هدف کاربر، زمان آزاد روزانه و اطلاعات معتبر دربارهی دوره. دو نمونه آماده کنید؛ یک نمونهی کامل و یک نمونهی ناقص که مثلاً زمان آزاد کاربر در آن مشخص نیست.
رفتار مورد انتظار روشن است. دستیار باید فرضهایش را اعلام کند؛ مثلاً «فرض کردهام روزی دو ساعت وقت دارید». اگر اطلاعاتی ناقص است، بهجای حدسزدن، آن را از کاربر بپرسد. و مهمتر از همه، هیچ تضمین بیپایهای ندهد.
پیام سیستمی نمونه و مقایسهی قبل و بعد
این رفتار را میشود با یک پیام سیستمی کوتاه شروع کرد. متن زیر را در ChatGPT، Gemini یا هر دستیاری که پیام سیستمی یا «دستورالعمل سفارشی» میپذیرد بگذارید. سپس همان دو نمونهی ورودی را امتحان کنید.
تو دستیار برنامهریزی مطالعهی یک مرکز آموزشی هستی.
- فقط از اطلاعات دوره که در ادامه آمده استفاده کن. اگر چیزی در آن نیست، بگو «این را نمیدانم».
- اگر زمان آزاد روزانه یا سطح فعلی کاربر را نمیدانی، اول همین را بپرس و حدس نزن.
- هر فرضی که میکنی را در یک خط با «فرض:» اعلام کن.
- هرگز قبولی، نمره یا نتیجهی قطعی را تضمین نکن.حالا پاسخها را مقایسه کنید. پیش از این پیام، پاسخ رایج چیزی شبیه این است: «این برنامهی ۱۴ روزه را دنبال کنید و حتماً قبول میشوید.» بعد از آن، پاسخ مسئولانه این شکل را دارد: «روزانه چند ساعت وقت آزاد دارید؟ فرض: سرفصلها همان فهرست دوره است. این برنامه آمادگی را بالا میبرد، اما نتیجه را تضمین نمیکند.»
این دو پاسخ نمونهی فرضیاند و خروجی واقعی هر مدل کمی فرق دارد. بنابراین معیار شما متن دقیق نیست؛ بلکه وجود پرسش، فرض اعلامشده و نبود تضمین است.
معیار پذیرش و نمونهی شکست
سه معیار اصلی این آزمون عبارتاند از: کاربر بتواند فرضها را اصلاح کند، محدودیت پاسخ روشن باشد و تضمین بیپایه در پاسخ نباشد. پیش از تغییر مدل، بررسی کنید آیا اطلاعات لازم اصلاً در اختیار دستیار بوده است.
شکستی که باید عمداً دنبالش بگردید این است: دستیار بدون شناخت توانایی کاربر، وعدهی قبولی قطعی بدهد. جملهای مثل «با این برنامه حتماً قبول میشوید» شاید دلگرمکننده باشد، اما مسئولانه نیست. این نمونه را در آزمون بگذارید و بعد از هر تغییر دوباره بسنجید.
تمرین عملی؛ فهرست خطاهای محصول
خروجی این تمرین یک فهرست کاربردی برای تیم است. فکر میکنید کدام خطای دستیار شما بیشترین آسیب را به کاربر میزند؟
- پنج خطای احتمالی دستیار آموزشی را بنویسید؛ از پاسخ ساختگی تا وعدهی بیپایه.
- برای هر خطا مشخص کنید در کدام لایه، یعنی مدل، ایمنی، پیام سیستمی یا رابط کاربری، کنترل میشود.
- برای هر خطا یک پرسش آزمون بنویسید که آن را بازسازی کند.
مشخص کنید کدام کنترل را واقعاً پیاده کردهاید و کدام هنوز طرح است. این فهرست پایهی مجموعهی آزمونی است که در قسمت چرخهی عمر برنامه به آن برمیگردیم.
سخن پایانی
هوش مصنوعی مسئولانه یک برچسب نیست؛ مجموعهای از تصمیمهای مشخص است. پاسخ ساختگی، محتوای مضر و سوگیری سه خطر اصلیاند. با سنجش آسیب، کاهش آن در چهار لایه، ارزیابی مداوم و راهاندازی امن، دستیاری میسازید که صادقانه محدودیتهایش را میگوید و کنترل را به کاربر میدهد. چنین دستیاری شاید کمتر چشمگیر به نظر برسد، اما قابلاعتماد است.
در قسمت بعد سراغ ابزارهای کمکد میرویم و میبینیم چطور بدون برنامهنویسی سنگین، کارهای تکراری یک مجموعهی آموزشی را خودکار کنیم.
این آموزش بر پایهی درس Using Generative AI Responsibly از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- آموزش پرامپت نویسی از صفر: راه خروج، نقش و درخواست منبع در پرامپت؛ پایهی لایهی پیام سیستمی برای سطح مبتدی.
- انتخاب مدل زبانی برای دستیار هوش مصنوعی: قسمت قبلی همین فصل؛ لایهی اول کاهش آسیب، یعنی انتخاب مدل با آزمون واقعی.
- درس Using Generative AI Responsibly (انگلیسی): متن اصلی این آموزش در دورهی آزاد مایکروسافت؛ برای سطح مبتدی.
- راهنمای People + AI Guidebook گوگل (انگلیسی): الگوهای طراحی محصول هوش مصنوعی با تمرکز بر اعتماد و خطا؛ برای سطح متوسط.
- مستندات Azure AI Content Safety (انگلیسی): دستههای محتوای مضر و بررسی متن و تصویر با API؛ برای سطح متوسط.
- چارچوب مدیریت ریسک هوش مصنوعی NIST (انگلیسی): چارچوب رسمی سنجش و مدیریت ریسک در سازمانها؛ برای سطح پیشرفته.
پرسشهای پرتکرار
هوش مصنوعی مسئولانه یعنی چه؟
یعنی طراحی و استفاده از هوش مصنوعی طوری که منصفانه، ایمن، قابلاعتماد، شفاف، حافظ حریم خصوصی و پاسخگو باشد و کاربر بتواند خطاهای آن را ببیند و اصلاح کند.
اصول هوش مصنوعی مسئولانه کداماند؟
شش اصل رایج عبارتاند از انصاف، فراگیری، قابلیت اطمینان و ایمنی، امنیت و حریم خصوصی، شفافیت و پاسخگویی. این اصول باید در همهی مراحل ساخت محصول، از انتخاب مدل تا رابط کاربری، رعایت شوند.
آیا مدلهای جدید دیگر پاسخ ساختگی نمیدهند؟
مدلهای جدیدتر پاسخ ساختگی کمتری تولید میکنند، اما این مشکل کاملاً از بین نرفته است. سازندهی محصول همچنان باید با منبع معتبر، راه خروج در پیام سیستمی و بررسی خروجی، خطر آن را کم کند.
برای شناسایی محتوای مضر چه ابزاری وجود دارد؟
سرویسهایی مثل Azure AI Content Safety و فیلترهای محتوای ارائهدهندگان مدل، متن و تصویر را از نظر محتوای مضر بررسی میکنند. این ابزارها باید کنار پیام سیستمی دقیق و طراحی رابط کاربری مناسب استفاده شوند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.