
انتخاب مدل زبانی از جایی سخت میشود که چند پاسخ نمایشی خوب جای ارزیابی واقعی را بگیرد. مدلی که در یک گفتوگوی آزمایشی درخشان است، ممکن است پرسش فارسی کاربران شما را بد بفهمد، محدودیت منابع را رعایت نکند یا آنقدر کند باشد که کاربر صفحه را ببندد.
این مقاله آغاز فصل دوم مجموعهی آموزش هوش مصنوعی تخته سبز است. در بیست قسمت اول از پرامپت به ایجنت رسیدیم. حالا سراغ تصمیمهای طراحی یک محصول واقعی میرویم و اولینشان انتخاب مدل است. هدف پیدا کردن «بهترین مدل دنیا» نیست؛ بلکه هدف انتخاب مدل مناسب برای همین محصول و همین کاربران است.
چرا انتخاب مدل زبانی یک تصمیم آزمایشی است؟
بسیاری از تیمها مدل را بر اساس شهرت، تاریخ انتشار یا جدولهای مقایسهی عمومی انتخاب میکنند. این جدولها مفیدند، اما کار شما را نمیسنجند. برای مثال، یک دستیار آموزشی فارسی با یک دستیار کدنویسی انگلیسی نیازهای کاملاً متفاوتی دارد.
یک مثال روزمره کمک میکند. وقتی برای مغازهتان فروشنده استخدام میکنید، به رتبهی کنکورش بسنده نمیکنید. بلکه یک روز آزمایشی پشت پیشخوان میگذاریدش. جدولهای عمومی همان رتبهی کنکورند و آزمون روی کار واقعی همان روز آزمایشی. البته این تشبیه یک حد دارد. مدل برخلاف آدم با تکرار آزمون خسته یا باتجربهتر نمیشود. پس آزمون را میشود عیناً تکرار کرد.
به همین دلیل انتخاب مدل را باید مثل یک آزمایش دید. ابتدا مجموعهای از کارهای واقعی تعریف میکنید و چند مدل را روی آن اجرا میکنید. سپس کیفیت پاسخ را کنار هزینه، زمان پاسخ و امکان استقرار میسنجید. نتیجه یک تصمیم مستند است که هر وقت مدل تازهای آمد، میتوانید دوباره تکرارش کنید.
انواع مدلهای زبانی را بشناسید
پیش از انتخاب مدل زبانی، باید بدانید با چه دستههایی روبهرو هستید. مدلها را میتوان بر اساس کاربرد، نوع دسترسی، خروجی و معماری دستهبندی کرد. هر دستهبندی یک پرسش تازه در انتخاب شما ایجاد میکند.
دستهبندی بر اساس نوع کار
بسته به اینکه با متن، صدا، تصویر یا ویدئو کار دارید، مدل متفاوتی لازم است. برای تبدیل گفتار به متن، مدلهای خانوادهی Whisper و نسلهای جدیدتر گفتار به متن گزینههای رایجاند. پوشش زبان فارسی، تأخیر و هزینه را برای آنها جداگانه بسنجید.
برای تولید تصویر، مدلهایی مثل GPT Image، Stable Diffusion، Imagen و Flux وجود دارند. برای متن، طیف گستردهای از مدلهای پیشرو، مدلهای استدلالی، مدلهای کوچک و سریع و مدلهای وزنباز در دسترس است.
علاوه بر این، بسیاری از مدلهای امروزی چندحالتی (Multimodal) هستند؛ یعنی جز متن، تصویر یا صدا را هم میفهمند. کارت مدل (Model Card) شناسنامهی رسمی مدل است. بنابراین پیش از ساخت هر گردش کاری، ورودیها و خروجیهای پشتیبانیشده را در آن بخوانید.
مدل پایه در برابر مدل زبانی بزرگ
اصطلاح مدل پایه (Foundation Model) را پژوهشگران دانشگاه استنفورد مطرح کردند. مدل پایه سه ویژگی دارد. اول، با یادگیری خودنظارتی روی دادهی بیبرچسب آموزش دیده است. دوم، بسیار بزرگ است و میلیاردها پارامتر دارد. سوم، پایهای برای ساخت مدلهای دیگر است.
مدل پایه را مثل فارغالتحصیلی در نظر بگیرید که کتابخانهی بزرگی را خوانده، اما هنوز شغل مشخصی ندارد. مدل زبانی بزرگ (LLM) معمولاً نوعی مدل پایه است که روی متن تمرکز دارد. نسخههای اولیهی ChatGPT نمونهی خوبیاند. آنها از یک مدل پایه شروع کردند و با دادهی گفتوگو برای چت تنظیم شدند.
با این حال، امروز سرویسها مرتب میان نسخههای مختلف مدل جابهجا میشوند. در نتیجه نام سرویس همیشه با نام مدل زیرساختی یکی نیست. وقتی نتیجهی آزمون را ثبت میکنید، نام و نسخهی دقیق مدل را هم بنویسید.
وزنباز یا اختصاصی؟
مدلهای وزنباز و متنباز اجازه میدهند وزنها، یعنی عددهایی که دانش مدل در آنها ذخیره شده، را دانلود، بررسی و سفارشی کنید. نمونههایشان Llama، بعضی مدلهای Mistral و هزاران مدل در Hugging Face است. این مدلها وقتی ارزش دارند که کنترل بیشتری بر محل داده، هزینه یا سفارشیسازی لازم دارید. اما مجوزشان یکسان نیست و اجرایشان سختافزار و تخصص عملیاتی میخواهد.
در مقابل، مدلهای اختصاصی مثل مدلهای OpenAI، Gemini و Claude متعلق به ارائهدهندهاند و از طریق سرویس او در دسترساند. معمولاً برای استفادهی تولیدی بهینه شدهاند و پشتیبانی، سازوکار ایمنی و ابزارهای یکپارچه دارند. در عوض، وزنها در اختیار شما نیست و باید شرایط حریم خصوصی و نگهداری داده را دقیق بخوانید.
تفاوت این دو شبیه خرید خانه و اجارهی آپارتمان مبله است. خانهی خودتان را هر طور بخواهید بازسازی میکنید، اما تعمیرش هم با خودتان است. در عوض آپارتمان مبله فوراً آماده است، ولی اجازهی تغییر دیوارها را ندارید. جدول زیر تفاوتهای اصلی را کنار هم میگذارد.
| معیار | مدل وزنباز | مدل اختصاصی |
|---|---|---|
| دسترسی به وزنها | دارد؛ طبق مجوز | ندارد |
| محل پردازش داده | زیرساخت خودتان | سرورهای ارائهدهنده |
| هزینهی شروع | سختافزار و راهاندازی | تقریباً صفر؛ پرداخت مصرفی |
| نگهداری و بهروزرسانی | بر عهدهی تیم شما | بر عهدهی ارائهدهنده |
| سفارشیسازی عمیق | آزادتر | محدود به امکانات سرویس |
تعبیه، تولید تصویر و تولید متن
مدلها را بر اساس خروجی هم دستهبندی میکنند. مدلهای تعبیه (Embedding) متن را به بردار عددی تبدیل میکنند و پایهی جستجوی معنایی و تولید افزوده با بازیابی (RAG) هستند. تعبیه شبیه شمارهی قفسه در کتابخانه است. کتابهای همموضوع کنار هم قرار میگیرند، پس با یک شماره به همسایههای مرتبط هم میرسید. مدلهای تولید تصویر نیز برای ساخت، ویرایش و بزرگنمایی تصویر به کار میروند.
مدلهای تولید متن و کد هم برای خلاصهسازی، ترجمه، پاسخ به پرسش و نوشتن کد استفاده میشوند. یک دستیار واقعی معمولاً از چند نوع کنار هم استفاده میکند؛ مثلاً یک مدل تعبیه برای جستجو و یک مدل متنی برای تولید پاسخ.
معماری؛ رمزگذار، رمزگشا یا هر دو
یک مثال ساده کمک میکند. فرض کنید باید برای دانشآموزان آزمونی بسازید و دو همکار دارید. همکار اول محتوا تولید میکند؛ این مثل مدل فقط-رمزگشا (Decoder-only) است، مانند خانوادهی GPT و Llama. در نوشتن محتوای روان عالی است، اما برای دستهبندی و بازیابی بهترین گزینه نیست.
همکار دوم متن را بازبینی میکند و رابطهی پرسش و پاسخ را میفهمد؛ این مثل مدل فقط-رمزگذار (Encoder-only) است، مانند BERT. کسی که هم بسازد و هم بازبینی کند، مدل رمزگذار-رمزگشاست، مثل BART و T5. این تفاوت توضیح میدهد چرا برای جستجو و دستهبندی گاهی مدلهای کوچکتر و تخصصیتر بهتر عمل میکنند.
بیشتر بخوانید: مدلهای تعبیه و کاربردشان در جستجو را در جستجوی معنایی چیست؟ با مثال کد توضیح دادهایم.
سرویس یا مدل؛ تفاوت در عمل
سرویس محصولی است که یک ارائهدهندهی ابری عرضه میکند و ترکیبی از مدل، زیرساخت و امکانات دیگر است. Azure OpenAI نمونهای از سرویس است. پرداخت بر اساس مصرف است، امنیت سازمانی و چارچوب هوش مصنوعی مسئولانه هم کنار مدل ارائه میشود.
مدل، خود شبکهی عصبی است: پارامترها، وزنها، معماری، توکنایزر و پیکربندی. اجرای مدل در محیط خودتان سختافزار مناسب، زیرساخت سرویسدهی، پایش و مجوز سازگار میخواهد. پس «رایگان بودن» مدل وزنباز به معنای رایگان بودن اجرای آن نیست.
به زبان ساده، مدل مثل موتور خودرو است و سرویس مثل تاکسی اینترنتی. با تاکسی به مقصد میرسید و به موتور فکر نمیکنید. اما اگر موتور را بخرید، شاسی، بنزین و تعمیرگاه هم با خودتان است. حد این تشبیه اینجاست که بعضی سرویسها اجازهی کمی سفارشیسازی میدهند. در حالی که مسافر تاکسی هیچ دستی در موتور ندارد.
پلتفرمهای مقایسهی مدل
پلتفرمهایی مثل Microsoft Foundry، که پیشتر Azure AI Foundry نام داشت، فهرستی از مدلهای اختصاصی و وزنباز را یکجا ارائه میدهند. میتوانید مدلها را بر اساس کار، ارائهدهنده، مجوز و نوع استقرار فیلتر کنید و کارت هر مدل را ببینید.
این پلتفرمها معمولاً بخش مقایسهی عملکرد روی مجموعهدادههای استاندارد، امکان فاینتیون و استقرار روی نقطهی پاسخگویی (Endpoint) هم دارند. فقط یادتان باشد همهی مدلهای فهرست برای فاینتیون یا استقرار مصرفی در دسترس نیستند. بنابراین کارت مدل را پیش از تصمیم بخوانید.
سه راه بهبود نتیجهی مدل
انتخاب مدل فقط توانایی پایه را به شما میدهد. تقریباً همیشه دادهی خاص کسبوکار شما باید بهنحوی به مدل برسد. سه رویکرد اصلی وجود دارد که از ساده و ارزان تا پیچیده و پرهزینه مرتب شدهاند.
مهندسی پرامپت با زمینه
مدلهای آموزشدیده در کارهای عمومی زبان حتی با یک پرامپت کوتاه خوب عمل میکنند. اما هرچه درخواست را با دستور دقیق و مثال، یعنی زمینه، بهتر قالببندی کنید، پاسخ به انتظارتان نزدیکتر میشود. آوردن یک مثال را یادگیری تکنمونهای (One-shot) و چند مثال را یادگیری چندنمونهای (Few-shot) میگویند.
این ارزانترین و سریعترین نقطهی شروع است. پیش از هر کار پیچیدهتری، مطمئن شوید پرامپت شما دقیق است. در بسیاری از پروژهها، همین قدم بیشتر مشکلات را حل میکند.
تولید افزوده با بازیابی
مدل فقط از دادهای که با آن آموزش دیده استفاده میکند. از رویدادهای بعدی و دادهی خصوصی شرکت خبر ندارد. RAG این مشکل را با افزودن بخشهای مرتبط اسناد به پرامپت حل میکند. پایگاههای دادهی برداری بخشهای مفید را پیدا میکنند و به زمینهی پرامپت اضافه میکنند.
RAG شبیه امتحان کتابباز است: دانشجو همهچیز را حفظ نیست، اما میداند کدام صفحه را باز کند. به همین دلیل RAG برای کسبوکاری که داده، زمان یا منابع کافی برای فاینتیون ندارد، بسیار مناسب است. هم پاسخ را به دادهی واقعی متکی میکند و هم احتمال پاسخ ساختگی یا قدیمی را کم میکند.
فاینتیون و آموزش از صفر
فاینتیون (Fine-tuning، تنظیم دقیق) مدل را با نمونههای ورودی و خروجی شما بیشتر آموزش میدهد و یک مدل تازه با وزنهای بهروز میسازد. مثل کارمند تازهواردی است که چند هفته کنار همکار باتجربه کار کرده و حالا سبک کار شرکت را بدون یادداشت رعایت میکند.
این رویکرد در سه حالت مناسب است. مثلاً میخواهید یک مدل کوچکتر را برای کاری محدود ارزانتر و سریعتر کنید. یا پرامپتهای طولانی زمان پاسخ را بالا برده است. یا رفتار ثابتی در قالب و لحن لازم دارید.
در مقابل، آموزش مدل از صفر سختترین گزینه است و دادهی عظیم، نیروی متخصص و توان محاسباتی زیاد میخواهد. برای بیشتر کسبوکارها گزینهی واقعبینانهای نیست. قاعدهی کلی روشن است: از پرامپت شروع کنید، برای دادهی خصوصی RAG اضافه کنید و فاینتیون را آخرین گزینه بدانید.
بیشتر بخوانید: سازوکار کامل RAG، از قطعهبندی تا بازیابی ترکیبی، در RAG چیست؟ با کد پایتون آمده است.
مقایسهی عملی مدلها برای یک دستیار آموزشی
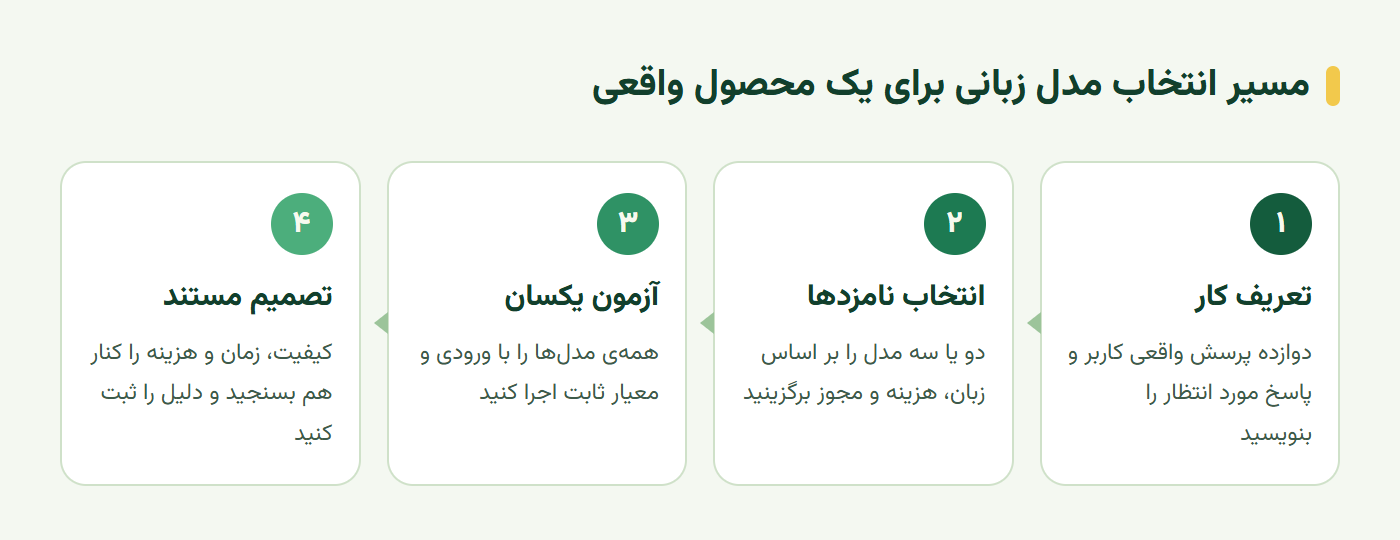
حالا همهی این مفاهیم را روی یک سناریوی واقعی پیاده میکنیم. یک مرکز آموزشی میخواهد دستیاری بسازد که به پرسشها دربارهی پیشنیاز دورهها پاسخ دهد. این دستیار باید سرفصلها را هم مقایسه کند و مسیر یادگیری پیشنهاد دهد. نمودار زیر چهار قدم این مقایسه را نشان میدهد.
تعریف کار و دادهی آزمون
دامنهی نسخهی اول را محدود کنید. دوازده پرسش فارسی واقعی، توضیح سه دوره و یک سقف زمان پاسخ کافی است. برای هر پرسش، پاسخ درست یا معیار پذیرش را پیش از اجرا بنویسید. اگر پاسخ درست معلوم نیست، آن را با کارشناس همان فرایند تعیین کنید.
دو نوع نمونه آماده کنید. نمونهی عادی نشان میدهد مسیر اصلی کار میکند. نمونهی ناقص، مثلاً پرسش دربارهی دورهای که در اسناد نیست، نشان میدهد سیستم هنگام کمبود اطلاعات چه رفتاری دارد.
اجرای آزمون یکسان
پرسشهای یکسان را با ورودی و معیار ثابت روی دو یا سه مدل اجرا کنید. خروجی هر مدل را جدا نگه دارید و به هر نمونه یک شناسه بدهید تا در نسخههای بعدی همان شرایط قابل تکرار باشد.
سه معیار اصلی را بسنجید: درستی پاسخ، وفاداری به سند و رعایت محدودیت طول. زمان پاسخ و هزینهی هر اجرا را هم ثبت کنید. جدول زیر یک قالب ساده برای ثبت نتایج است که میتوانید عیناً در Google Sheets بسازید.
| معیار | مدل الف | مدل ب | مدل ج |
|---|---|---|---|
| پاسخ درست از ۱۲ پرسش | |||
| پاسخ وفادار به سند | |||
| میانگین زمان پاسخ | |||
| هزینهی کل آزمون | |||
| رفتار در پرسش بیجواب |
اسکریپت سادهی اجرای آزمون
اجرای دستی دوازده پرسش روی سه مدل خستهکننده است و خطای کپیکردن دارد. اسکریپت زیر همین کار را با کتابخانهی رسمی openai در پایتون انجام میدهد. هر سرویسی که API سازگار با OpenAI دارد، از جمله Ollama روی رایانهی خودتان، با تغییر base_url و نام مدل کار میکند. نام مدلها در کد فقط نمونهاند؛ آنها را با مدلهایی که واقعاً دسترسی دارید عوض کنید.
import csv, time
from openai import OpenAI
client = OpenAI() # کلید از متغیر محیطی OPENAI_API_KEY خوانده میشود
models = ["gpt-4o-mini", "gpt-4.1-mini"] # نمونه؛ مدلهای خودتان را بگذارید
questions = [
("q01", "پیشنیاز دورهی پایتون مقدماتی چیست؟"),
("q02", "دورهی طراحی رابط کاربری چند جلسه است؟"), # نمونهی ناقص: در اسناد نیست
]
system = "فقط بر اساس متن دورهها پاسخ بده. اگر جواب در متن نیست، بگو «نمیدانم»."
with open("results.csv", "w", newline="", encoding="utf-8") as f:
writer = csv.writer(f)
writer.writerow(["id", "model", "seconds", "tokens", "answer"])
for qid, q in questions:
for m in models:
start = time.time()
r = client.chat.completions.create(
model=m,
messages=[{"role": "system", "content": system},
{"role": "user", "content": q}],
temperature=0,
)
writer.writerow([qid, m, round(time.time() - start, 2),
r.usage.total_tokens, r.choices[0].message.content])خروجی یک فایل results.csv است که در Google Sheets یا اکسل باز میشود. در این فایل زمان و تعداد توکن خودکار ثبت شده و شما فقط ستون درستی و وفاداری را با دست علامت میزنید.
دمای صفر (temperature=0) پاسخها را تکرارپذیرتر میکند. با این حال بعضی مدلهای استدلالی این پارامتر را نمیپذیرند و باید حذفش کنید. در ضمن متن دورهها برای کوتاهی حذف شده است. در آزمون واقعی آن را به پیام سیستمی اضافه کنید.
نمونهی شکستی که باید عمداً دنبالش بگردید
مهمترین خطایی که باید دنبالش باشید این است: مدلی که روانتر مینویسد، اما پیشنیازهای دوره را از خودش اضافه میکند. این خطا در نگاه اول دیده نمیشود، چون پاسخ قانعکننده است. اما برای کاربری که بر اساس آن ثبتنام میکند، خطرناک است.
این نمونه را عمداً در آزمون بگذارید و نتیجهی مورد انتظار را پیش از اجرا ثبت کنید. اگر نسخهی جدیدی ظاهراً بهتر بود، همین نمونه را دوباره بسنجید. خطای داده، خطای انتخاب مسیر و خطای تولید پاسخ را هم از هم جدا کنید؛ هرکدام راهحل متفاوتی دارد.
تمرین عملی؛ گزارش انتخاب مدل
خروجی این تمرین یک گزارش کوتاه انتخاب مدل زبانی است که به همکارتان تحویل میدهید. اگر مدل ارزانتر فقط یک پرسش کمتر درست جواب دهد، شما کدام را انتخاب میکنید؟
- جدول مقایسهی مدلها را با نتایج واقعی آزمون پر کنید.
- مدل منتخب و دلیل انتخابش را در سه جمله بنویسید.
- مشخص کنید کدام بخش را واقعاً اجرا کردهاید و کدام بخش هنوز فرض است.
این تفکیک اهمیت دارد. خوانندهی گزارش باید بداند کدام نتیجه مشاهده شده و کدام تصمیم به آزمون بیشتر نیاز دارد. همین گزارش را نگه دارید؛ در قسمتهای بعدی محدودیتهای ثبتشدهاش را یکییکی بررسی میکنیم.
سخن پایانی
انتخاب مدل زبانی یک تصمیم آزمایشی است، نه یک انتخاب سلیقهای. پس انواع مدلها را بشناسید و تفاوت وزنباز و اختصاصی و سرویس و مدل را در نظر بگیرید. همچنین بدانید پرامپت، RAG و فاینتیون هرکدام چه زمانی به کار میآیند. سپس با کار واقعی محصولتان، چند مدل را منصفانه مقایسه کنید. تصمیمی که با دادهی خودتان گرفته شود، با آمدن مدل بعدی هم قابل تکرار است.
در قسمت بعد سراغ طراحی دستیار مسئولانه میرویم؛ یعنی دستیاری که ادعای نادرست نکند و کنترل را به کاربر بدهد.
این آموزش بر پایهی درس Exploring and Comparing Different LLMs از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- RAG چیست؟ آموزش ساخت دستیار پاسخگو از روی اسناد: مرور فارسی دومین راه بهبود نتیجه با کد پایتون؛ برای سطح مبتدی تا متوسط.
- درس Exploring and Comparing Different LLMs (انگلیسی): متن اصلی این آموزش در دورهی آزاد مایکروسافت؛ برای سطح مبتدی.
- راهنمای انتخاب مدل در مستندات OpenAI (انگلیسی): روش رسمی سنجیدن دقت، هزینه و زمان پاسخ پیش از انتخاب مدل؛ برای سطح متوسط.
- معرفی کاتالوگ مدل در Microsoft Foundry (انگلیسی): فیلتر مدلها بر اساس مجوز، کار و نوع استقرار؛ برای سطح متوسط.
- مستندات مدلها در Hugging Face Hub (انگلیسی): کار با کارت مدل و مدلهای وزنباز؛ برای سطح متوسط.
- مقالهی On the Opportunities and Risks of Foundation Models (انگلیسی): مقالهی استنفورد که اصطلاح مدل پایه را مطرح کرد؛ برای سطح پیشرفته.
پرسشهای پرتکرار
بهترین مدل زبانی کدام است؟
بهترین مدل برای همهی کارها وجود ندارد. مدلی مناسب است که روی کار واقعی محصول شما، با زبان و دادهی شما، کیفیت کافی را با زمان پاسخ و هزینهی قابلقبول بدهد. این را فقط با آزمون روی نمونههای واقعی میشود فهمید.
مدل وزنباز بهتر است یا مدل اختصاصی؟
مدل وزنباز کنترل بیشتری بر محل داده، استقرار و سفارشیسازی میدهد اما زیرساخت و نگهداری میخواهد. مدل اختصاصی آمادهی استفاده است و پشتیبانی و امکانات ایمنی دارد، اما وزنهایش در اختیار شما نیست. انتخاب به نیاز حریم خصوصی، بودجه و تیم شما بستگی دارد.
برای بهبود نتیجهی مدل اول چه کاری کنیم؟
از مهندسی پرامپت و زمینهی دقیق شروع کنید که ارزانترین راه است. اگر مدل به دادهی خصوصی یا بهروز نیاز دارد، RAG را اضافه کنید. فاینتیون را فقط وقتی انتخاب کنید که نمونهی باکیفیت کافی دارید و رفتار ثابتی در قالب یا لحن میخواهید.
تفاوت سرویس و مدل در هوش مصنوعی چیست؟
مدل خود شبکهی عصبی با وزنها و توکنایزر است. سرویس محصولی از یک ارائهدهنده است که مدل را همراه زیرساخت، مقیاسپذیری، امنیت و صورتحساب مصرفی ارائه میکند؛ مثل Azure OpenAI.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.