
ممیزی سئو با هوش مصنوعی وسوسهانگیز است. چند خروجی از سرچ کنسول و خزنده را به مدل میدهید و در چند دقیقه گزارشی مرتب و مفصل میگیرید. اما آیا این گزارش درست هم هست؟ سه متخصص تجربههایی منتشر کردهاند که نشان میدهد پاسخ همیشه مثبت نیست.
برای اینکه این تجربهها را از سطح روایت بالاتر ببریم، آنها را کنار سه منبع مستقل گذاشتیم: بزرگترین پژوهش دقت دستیارهای AI، یک مقاله علمی درباره آدیت وبسایت با GPT و داده Ahrefs درباره آدرسهای ساختگی. این مطلب مرور شواهد است، نه آزمایش تخته سبز.
خلاصه یافته: متن روان و مطمئن نشانه درستی نیست؛ هر یافته آدیت هوش مصنوعی پیش از اجرا به آدرس، شاهد و بررسی انسانی نیاز دارد.
ممیزی سئو با هوش مصنوعی: هر یافته یک ادعاست
هر یافته آدیت هوش مصنوعی را ادعایی بدانید که پیش از اجرا به آدرس، شاهد قابل مشاهده و روش بررسی تکرارپذیر نیاز دارد. یافته بدون شاهد نباید مستقیم به تسک برنامهنویس تبدیل شود. مثل گزارش یک کارآموز در تعمیرگاه: اگر بگوید ترمز خراب است، اول خودتان لنت را نگاه میکنید و بعد قطعه سفارش میدهید.
این قاعده ساده جلوی هزینههای بزرگ را میگیرد. برای نمونه، تغییر اشتباه در canonical (تگی که به گوگل میگوید نسخه اصلی یک صفحه کدام است) یا ریدایرکت میتواند بخشی از سایت را از نتایج بیرون ببرد. راهنمای رسمی گوگل درباره آدرسهای تکراری و canonical نشان میدهد این تصمیمها چقدر به جزئیات وابستهاند.
بیشتر بخوانید: خطاهای سرور هم بخش مهمی از هر آدیت هستند. راهنمای جامع خطاهای سایت معنی و راه رفع هر کد را توضیح میدهد.
سه تجربه از آدیت سئو با AI
در ادامه سه گزارش را مرور میکنیم. اولی نقدی جدی است، دومی تجربهای دوگانه و سومی ترکیبی از صرفهجویی زمان و خطای آشکار. کنار هر کدام محدودیتهایش را هم آوردهایم.
دنیل فولی کارتر: داده بیشتر، نتیجهگیری ضعیف را حذف نکرد
Daniel Foley Carter میگوید فرایندهای آدیت AI را با داده سرچ کنسول، خزنده و ابزارهای سئو شخص ثالث آزمود. با این حال هنوز نتیجهگیریهای ناقص یا گمراهکننده دریافت کرد. گزارش اصلی فولی کارتر
از طرف دیگر، او در همان پست خدمات آدیت حرفهای خودش را تبلیغ میکند. تجربهاش نقد مفیدی است، اما ادعای کلی او درباره نرخ شکست یک معیار منتشرشده نیست. پس نباید آن را بهعنوان آمار تکرار کرد.
کوین کاپزی: ارزش عملی نابرابر فرایندهای محبوب
Kevin Kapezi میگوید فرایندهای پرطرفدار را برای سئو فروشگاهی آزمود. نتیجه ترکیبی از کمک مفید و ضعف در درک تجاری بود. گزارش اصلی کاپزی
نکته مهم این است که مثال «نمره کامل» در ابتدای پستش بازگویی همان پرونده دنیل است. بنابراین رخداد مستقل دوم به حساب نمیآید. آنچه اینجا تجربه جداگانه حساب میشود، آزمون فرایندهای خود اوست.
کاربر sasquatchhere در ردیت: صرفهجویی زمان با خطاهای آشکار
کاربر u/sasquatchhere در یک کامنت ردیت میگوید یک پرامپت آدیت را روی سه مدل اجرا کرد و گزارشها را ترکیب کرد. نتیجه وقتش را صرفهجویی کرد و مشکلهایی را نشان داد که با آنها آشنا نبود. گفتوگوی اصلی در ردیت
اما همین خروجی تعداد نظرات را اشتباه گفت و ادعا کرد ویژگیهایی که سایت داشت وجود ندارند. ارزیابی مثبت و خطاها به یک تجربه تعلق دارند. به همین دلیل این گزارش آموزندهتر از حکم «همه خوب» یا «همه بد» است.
پژوهشهای مستقل درباره خطای مطمئن AI
با این حال، تجربههای بالا شخصیاند. سه منبع زیر با نمونه بزرگتر یا روش علمی نشان میدهند چرا خروجی AI به بررسی نیاز دارد. هیچکدام مستقیماً «آدیت سئو» نیست، اما هر سه همان نوع خطا را اندازه گرفتهاند.
EBU و BBC؛ نزدیک به نیمی از پاسخها مشکل جدی داشتند
اتحادیه پخش اروپا (EBU) به رهبری BBC در ۲۱ اکتبر ۲۰۲۵ نتایج پژوهشی را منتشر کرد که ۲۲ رسانه عمومی از ۱۸ کشور و ۱۴ زبان در آن حضور داشتند. روزنامهنگاران حرفهای بیش از ۳۰۰۰ پاسخ ChatGPT، Copilot، Gemini و Perplexity را ارزیابی کردند. گزارش اصلی EBU
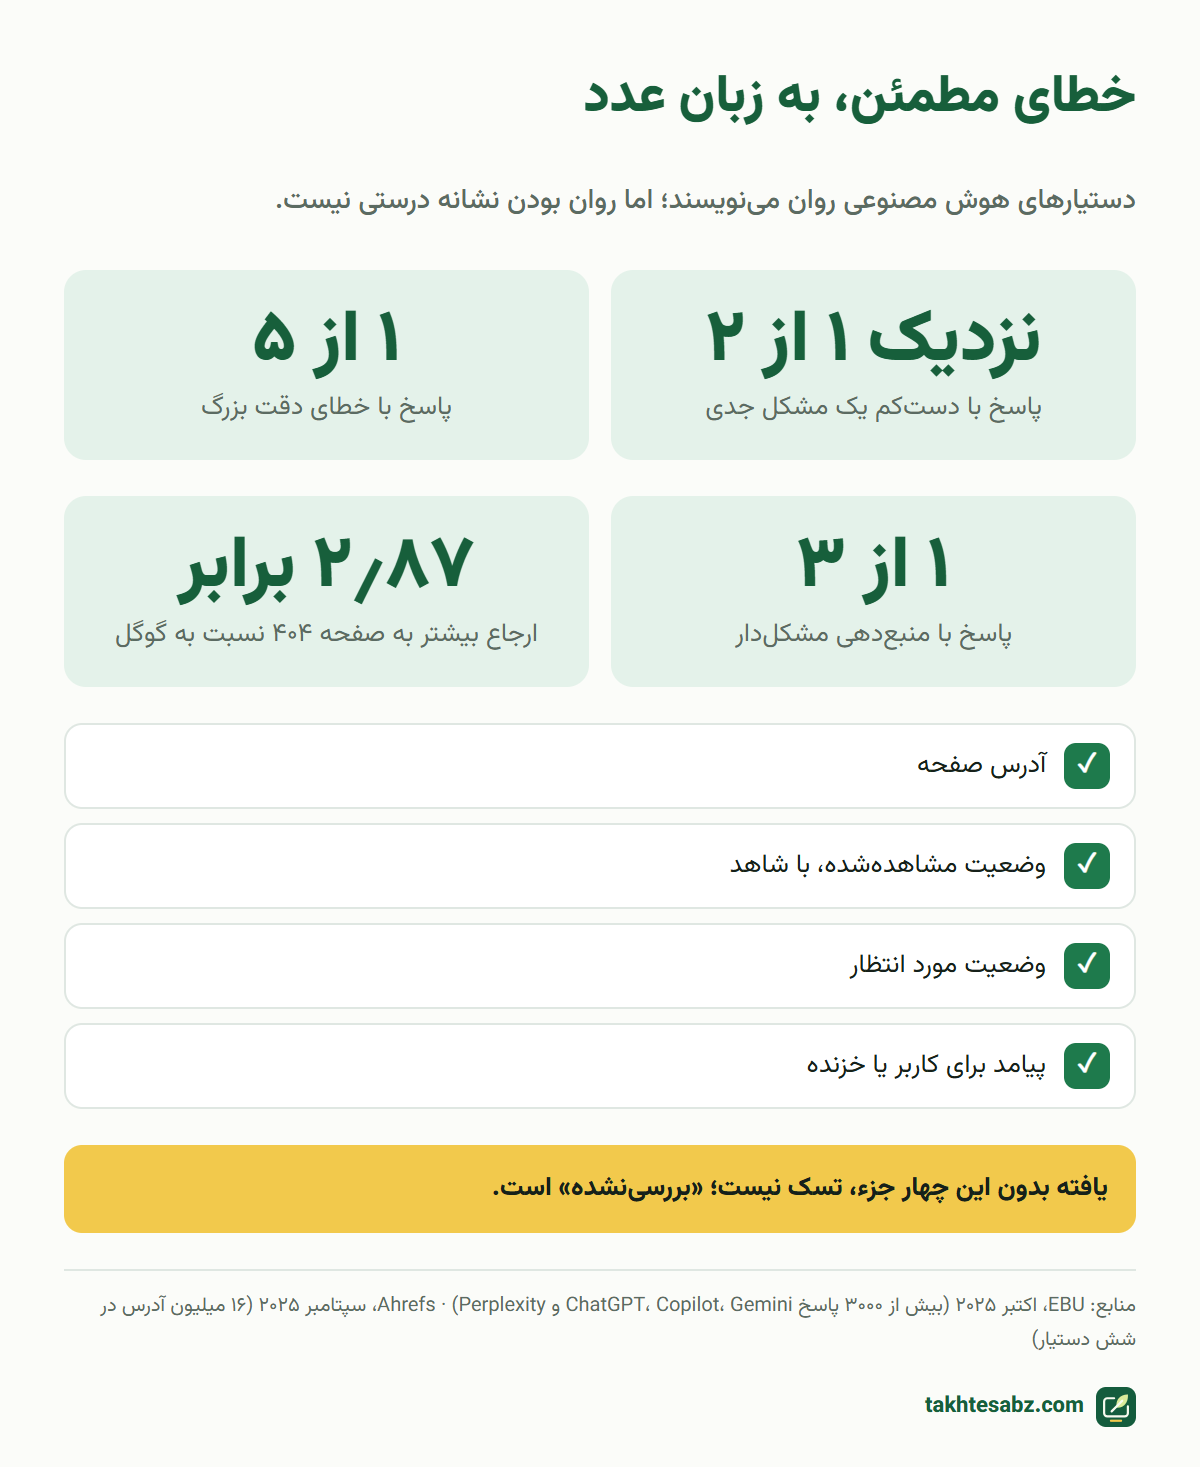
نتیجه: نزدیک به نیمی از پاسخها دستکم یک مشکل جدی داشتند. حدود یکسوم مشکل جدی در منبعدهی داشتند و حدود یکپنجم خطای دقت بزرگ، مثل جزئیات ساختگی یا اطلاعات قدیمی. البته موضوع این پژوهش خبر است، نه سئو؛ اما همان الگوی «پاسخ مطمئن ولی نادرست» را نشان میدهد.
مقاله علمی؛ افزونههای GPT در آدیت کیفیت وبسایت
کارول کرول در مقالهای در مجله علمی Applied Sciences در سال ۲۰۲۵ دو افزونه اختصاصی بر پایه ChatGPT-4o برای آدیت کیفیت وبسایت ساخت. سپس خروجی آنها را با ابزارهای سنتی آدیت مقایسه کرد. مقاله اصلی در MDPI
طبق جمعبندی مقاله، این افزونهها تمایل به خروجی نادرست داشتند. نویسنده هشدار میدهد استفاده از ابزار AI بدون شناخت ویژگیهایش میتواند توهم مدل را به گزارش آدیت منتقل کند. این دقیقاً همان ریسکی است که تجربههای بالا گزارش کردهاند.
توهم (Hallucination) یعنی مدل چیزی را که نمیداند، با اطمینان میسازد. مثل رهگذری که نشانی را بلد نیست، اما برای اینکه دست خالی برتان نگرداند، با اعتمادبهنفس مسیر اشتباهی را نشان میدهد. لحن مطمئن او هیچ اطلاعاتی درباره درستی مسیر نمیدهد.
Ahrefs؛ آدرسهایی که وجود ندارند
Ahrefs در ۲ سپتامبر ۲۰۲۵ حدود ۱۶ میلیون آدرس ارجاعشده در شش دستیار AI را بررسی کرد. دستیارها کاربر را ۲٫۸۷ برابر بیشتر از جستجوی گوگل به صفحه ۴۰۴ فرستادند. مدلها آدرسهایی مثل /blog/internal-links/ برای سایت Ahrefs ساخته بودند که هرگز وجود نداشت. پژوهش اصلی Ahrefs
برای آدیت، پیام این داده مستقیم است. اگر مدل آدرسی را «دارای مشکل» معرفی کرد، اول مطمئن شوید آن آدرس اصلاً در سایت شما وجود دارد. ابزار بازرسی آدرس سرچ کنسول برای همین بررسی ساخته شده است.
وجه مشترک تجربهها و پژوهشها
این منابع به یک مرز عملی میرسند: گزارش میتواند خوب نوشته شده باشد و همچنان درست نباشد. فهرست بلند توصیهها ثابت نمیکند ابزار صفحهها را واقعاً دیده، کسبوکار را فهمیده یا علت تغییر ترافیک را پیدا کرده است.
به عبارت دیگر، یافته قابل بررسی باید آدرس، وضعیت مشاهدهشده، وضعیت مورد انتظار و پیامد را نشان دهد. اگر مدل نتواند مشاهده پایه را ارائه کند، آن مورد را «بررسینشده» علامت بزنید. جدول زیر این اجزا را با یک مثال canonical نشان میدهد.
| اجزای یافته | مثال برای canonical | اگر وجود نداشت |
|---|---|---|
| آدرس | صفحه دستهبندی کفش | یافته را کنار بگذارید |
| وضعیت مشاهدهشده | canonical به صفحه دوم اشاره میکند | «بررسینشده» علامت بزنید |
| وضعیت مورد انتظار | canonical به خود صفحه | از متخصص بپرسید |
| پیامد | صفحه اصلی ممکن است ایندکس نشود | اولویت را پایین نگه دارید |
این شواهد چه چیزی را ثابت نمیکنند؟
در واقع، تجربهها یک مجموعه آزمون مشترک نیستند. ابزار، ورودی، پرامپت و کسبوکار در هر کدام فرق داشته است. نفع تجاری دنیل و ناشناس بودن نویسنده ردیت هم اعتماد به ادعاهای کلی را محدود میکند.
پژوهش EBU درباره خبر است و داده Ahrefs درباره آدرسهای ارجاعشده در پاسخها، نه آدیت فنی. پس هیچکدام نرخ خطای «آدیت سئو با AI» را اندازه نمیگیرند. آنچه ثابت میکنند این است که بررسی، یک انتخاب فرایندی لازم است؛ بهترین مدل را مشخص نمیکنند.
بیشتر بخوانید: بررسی خروجی AI فقط به آدیت محدود نیست. در بهروزرسانی محتوا با هوش مصنوعی بر پایه داده همین منطق را در بازنویسی محتوا میبینید.
آزمون پیشنهادی: دقت آدیت AI را بسنجید
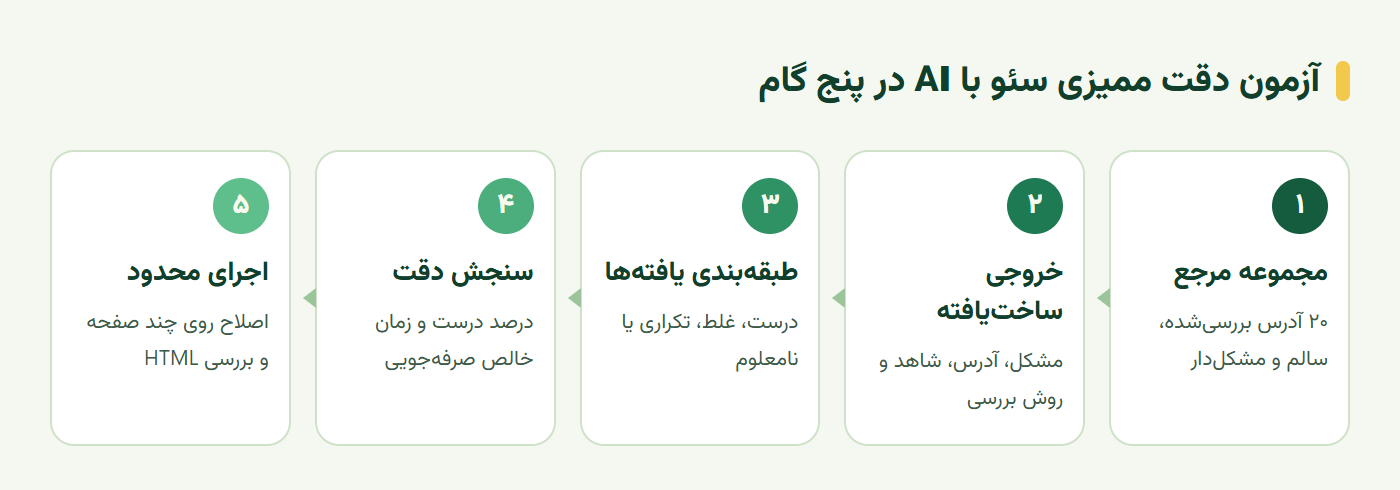
برای اینکه بدانید آدیت هوش مصنوعی در سایت شما چقدر قابل اعتماد است، این آزمون را اجرا کنید. روش پیشنهادی است و نتیجهای از اجرای آن ادعا نمیکنیم:
- مجموعه مرجع: یک خروجی ثابت و یک مجموعه مرجع بررسیشده دستی با ۲۰ آدرس نماینده آماده کنید. صفحههای سالم را هم بگذارید تا مشکلهای ساختگی شناسایی شوند.
- خروجی ساختیافته: از مدل بخواهید مشکل، آدرس، شاهد، رفتار مورد انتظار، اصلاح پیشنهادی و روش بررسی را بنویسد. وقتی شاهد نیست، باید صریحاً «نامعلوم» بنویسد.
- طبقهبندی یافتهها: بازبین هر یافته را درست، غلط، تکراری یا غیرقابل ارزیابی علامت بزند. آدرسهای ساختگی و مشکلهای مهمی را که مدل ندید هم ثبت کنید.
- سنجش دقت: درصد یافتههای درست، پوشش مشکلهای شناختهشده و زمان خالص صرفهجویی بعد از بررسی را حساب کنید. نمره آدیتی که خود مدل میدهد معیار کیفیت نیست.
- اجرای محدود: اصلاحهای تأییدشده را اول روی چند صفحه اجرا کنید و HTML و رفتار نهایی را بررسی کنید. اصلاح فنی را از نتیجه بعدی رتبه یا درآمد جدا کنید.
این آزمون یک بار زمان میبرد، اما بعد از آن میدانید به کدام بخش خروجی مدل میشود تکیه کرد. نمودار زیر مسیر کامل را نشان میدهد.
نکته کاربردی برای متخصصان سئو
هوش مصنوعی میتواند به سازماندهی آدیت کمک کند؛ مثلاً دادهها را دستهبندی کند یا فهرست بررسی بسازد. اما تیم هنوز باید ثابت کند هر اصلاح پیشنهادی به یک وضعیت واقعی در سایت مربوط است.
بنابراین قالب خروجی را از اول سختگیرانه تعریف کنید. وقتی مدل مجبور باشد برای هر ادعا شاهد بیاورد، خطاهایش هم زودتر دیده میشوند.
برای مثال، این جمله را به انتهای پرامپت آدیت اضافه کنید: «هر یافته را دقیقاً در قالب زیر بنویس و اگر شاهد را در دادههای من نمیبینی، به جای شاهد بنویس نامعلوم.» یک یافته درست در این قالب برای یک سایت وردپرسی چنین است:
مشکل: canonical صفحه دستهبندی به صفحه دوم همان دسته اشاره میکند
آدرس: https://example.com/shoes/
شاهد: <link rel="canonical" href="https://example.com/shoes/page/2/">
رفتار مورد انتظار: canonical به خود صفحه، یعنی https://example.com/shoes/
اصلاح پیشنهادی: تنظیم canonical صفحهبندی در افزونه سئو (Yoast یا Rank Math)
روش بررسی: View Source صفحه و بازرسی آدرس در سرچ کنسولاگر خط «شاهد» خالی یا «نامعلوم» بود، آن یافته هنوز تسک نیست؛ فقط یک سؤال است که باید خودتان جوابش را پیدا کنید.
این مطلب را چطور آماده کردیم؟
این مطلب یک مرور است، نه آزمایشی روی سایتهای تخته سبز. سه گزارش عمومی لینکدین و ردیت را خواندیم و کنار یک پژوهش بینالمللی، یک مقاله علمی داوریشده و داده Ahrefs گذاشتیم. منابع در ۴ مهر ۱۴۰۵ (۲۶ سپتامبر ۲۰۲۶) بررسی شدند و گزارش EBU و پژوهش Ahrefs دوباره در ۲۹ مهر ۱۴۰۵ (۲۱ اکتبر ۲۰۲۶).
به داده خام گزارشدهندگان دسترسی نداشتیم؛ پس ادعاهای آنها منتسب به خودشان است. صفحه EBU و پژوهش Ahrefs را مستقیم بررسی کردیم. متن کامل مقاله MDPI از ابزار ما باز نشد؛ برداشت ما از چکیده و مشخصات منتشرشده مقاله است و عددی از آن نقل نکردهایم.
سخن پایانی
ممیزی سئو با هوش مصنوعی ابزار خوبی برای شروع است، اما جای قضاوت متخصص را نمیگیرد. تجربهها و پژوهشها نشان میدهند گزارش زیبا و گزارش درست دو چیز متفاوتاند.
پس از مدل شاهد بخواهید، یافتهها را طبقهبندی کنید و فقط اصلاحهای اثباتشده را اجرا کنید. با این روش، هوش مصنوعی زمان شما را واقعاً کم میکند، نه اینکه کار تازهای برایتان بسازد.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- راهنمای شروع سئو گوگل (SEO Starter Guide) (انگلیسی): مبانی رسمی که هر یافته آدیت باید با آن سنجیده شود؛ مناسب سطح مبتدی.
- بررسی کاهش کلیک در سرچ کنسول؛ راهنمای قدمبهقدم پیدا کردن علت: نمونه یک بررسی شاهدمحور با داده سرچ کنسول؛ سطح متوسط.
- راهنمای گوگل درباره آدرسهای تکراری و canonical (انگلیسی): مرجع رسمی برای بررسی یافتههای canonical؛ سطح متوسط.
- گزارش EBU درباره درستی پاسخ دستیارهای AI (انگلیسی): روش ارزیابی بیش از ۳۰۰۰ پاسخ و انواع خطا؛ سطح حرفهای.
- پژوهش Ahrefs درباره لینکهای ساختگی دستیارهای AI (انگلیسی): داده ۱۶ میلیون آدرس و صفحههای ۴۰۴؛ سطح حرفهای.
پرسشهای پرتکرار
آیا میتوان به ممیزی سئو با هوش مصنوعی اعتماد کرد؟
بهعنوان کمک برای سازماندهی بله، اما هر یافته را باید بررسی کرد. مدلها گاهی ادعای اشتباه را با اطمینان کامل مینویسند؛ مثلاً ویژگی موجود سایت را غایب اعلام میکنند.
دستیارهای هوش مصنوعی چقدر خطا دارند؟
در پژوهش EBU و BBC، روزنامهنگاران بیش از ۳۰۰۰ پاسخ ChatGPT، Copilot، Gemini و Perplexity را بررسی کردند. نزدیک به نیمی از پاسخها دستکم یک مشکل جدی داشتند و حدود یکپنجم خطای دقت بزرگ، مثل اطلاعات ساختگی یا قدیمی.
یک یافته قابل بررسی در آدیت سئو چه اجزایی دارد؟
آدرس صفحه، وضعیت مشاهدهشده، وضعیت مورد انتظار و پیامد آن برای کاربر یا خزنده. مثلاً هشدار canonical باید تگ واقعی و مقصد درست را نشان دهد.
کدام مدل هوش مصنوعی برای آدیت سئو بهتر است؟
شواهد موجود بهترین مدل را مشخص نمیکنند، چون ابزار و ورودیها متفاوت بودند. بهتر است مدلها را روی یک مجموعه مرجع ثابت از صفحههای بررسیشده خودتان مقایسه کنید.
چطور دقت آدیت سئو با AI را اندازه بگیریم؟
یک مجموعه ۲۰ آدرسی با مشکلهای شناختهشده و صفحههای سالم بسازید. سپس درصد یافتههای درست، پوشش مشکلهای شناختهشده و زمان خالص صرفهجویی را بعد از بررسی حساب کنید.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.