
فاینتیون مدل زبانی برای بسیاری از تیمها وسوسهانگیز است؛ مدلی که «مال خودمان» باشد و دقیقاً همانطور که میخواهیم جواب بدهد. اما فاینتیون همیشه اولین راه بهبود یک دستیار نیست. گاهی مشکل با اطلاعات مرجع بهتر، تعریف روشنتر خروجی یا چند مثال خوب در پرامپت حل میشود.
در این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز، فاینتیون را از زاویهی تصمیمگیری بررسی میکنیم. پیش از شروع آموزش باید بدانیم دقیقاً کدام رفتار باید تغییر کند و موفقیت را چطور میسنجیم. در پایان هم آزمایشی طراحی میکنیم که نشان دهد مدل واقعاً چیز تازهای یاد گرفته یا فقط مثالها را حفظ کرده است.
فاینتیون مدل زبانی چیست؟
مدلهای زبانی بزرگ روی حجم عظیمی از متنهای متنوع پیشآموزش دیدهاند. در قسمتهای قبل دیدیم با مهندسی پرامپت و RAG میتوان کیفیت پاسخ آنها را بدون تغییر خود مدل بهتر کرد. یکی از روشهای رایج، یادگیری چندنمونهای است؛ یعنی چند مثال از پاسخ مطلوب در پرامپت میگذاریم.
این روش دو محدودیت دارد. اول، سقف توکن مدل تعداد مثالهایی را که میتوانید بیاورید محدود میکند. دوم، هر مثال در هر درخواست هزینهی توکن دارد. اگر برای هر پرسش ده مثال بفرستید، هزینه و زمان پاسخ بهسرعت بالا میرود.
فاینتیون راه دیگری است. بهجای آوردن مثال در هر پرامپت، مدل را یک بار با مجموعهای از مثالها دوباره آموزش میدهید. نتیجه مدل تازهای با وزنهای بهروزشده است که رفتار مطلوب را بدون مثال در پرامپت نشان میدهد. منظور ما در این مقاله فاینتیون نظارتشده است؛ یعنی آموزش با دادهی تازهای که در آموزش اصلی مدل نبوده است.
پیش از فاینتیون این پرسشها را جواب دهید
فاینتیون یک تکنیک پیشرفته است و به تخصص نیاز دارد. اگر درست انجام نشود، ممکن است بهبودی نیاورد و حتی عملکرد مدل را در حوزهی هدف بدتر کند. پس پیش از اینکه بپرسید «چطور»، باید بدانید «چرا» و «چه زمانی».
کاربرد و جایگزینها
اول بپرسید دقیقاً کدام رفتار مدل را میخواهید بهتر کنید. پاسخی مثل «مدل بهتر شود» کافی نیست. پاسخ خوب مشخص است؛ مثلاً «بازخورد تکالیف همیشه سه بخش ثابت داشته باشد و لحنش در همهی رشتهها یکسان بماند».
بعد بپرسید آیا روشهای سادهتر را امتحان کردهاید. مهندسی پرامپت با چند مثال و RAG با دادهی خودتان را اجرا کنید و کیفیت پاسخها را بسنجید. این نتایج خط مبنای شما هستند. بدون خط مبنا، هرگز نمیتوانید ثابت کنید فاینتیون بهبودی ایجاد کرده است.
هزینهها و مزایا
فاینتیون چهار نوع هزینه دارد. آیا مدل مورد نظر اصلاً قابل فاینتیون است؟ چقدر تلاش برای آمادهسازی داده، ارزیابی و اصلاح لازم است؟ چقدر هزینهی محاسباتی برای آموزش و استقرار دارد؟ و آیا بهاندازهی کافی نمونهی باکیفیت دارید؟
در مقابل، سه مزیت را باید تأیید کنید. کیفیت؛ آیا مدل فاینتیونشده از خط مبنا بهتر است؟ هزینه؛ آیا با کوتاهشدن پرامپت، مصرف توکن کم میشود؟ و گسترشپذیری؛ آیا میتوانید همین مدل را برای حوزههای دیگر هم استفاده کنید؟ فاینتیون فقط وقتی معتبر است که مزایا از هزینهها بیشتر باشند.
جدول زیر نشان میدهد کدام مشکل با کدام روش بهتر حل میشود.
| مشکل | روش مناسبتر | دلیل |
|---|---|---|
| مدل از دادهی خصوصی یا بهروز خبر ندارد | RAG | دانش مرتب تغییر میکند و باید قابل ردیابی باشد |
| قالب خروجی گاهی رعایت نمیشود | پرامپت دقیق و مثال | معمولاً با دستور و نمونه حل میشود |
| لحن و ساختار ثابت در هزاران پاسخ | فاینتیون | رفتار پایدار بدون پرامپت طولانی |
| پرامپت طولانی زمان پاسخ را بالا برده | فاینتیون مدل کوچکتر | مثالها در وزن مدل جا میگیرند |
| دانش تخصصی عمیق در یک حوزهی محدود | ترکیب RAG و فاینتیون | هم دانش و هم الگوی پاسخ لازم است |
چطور یک مدل را فاینتیون کنیم؟
برای فاینتیون چهار چیز لازم دارید: یک مدل آمادهی قابل فاینتیون، یک مجموعهدادهی آموزشی، یک محیط برای اجرای آموزش و یک محیط برای میزبانی مدل نهایی. پلتفرمهایی مثل Microsoft Foundry هر چهار را یکجا فراهم میکنند.
سه روش آموزش
Foundry و بسیاری از پلتفرمهای دیگر سه روش فاینتیون را پشتیبانی میکنند. تفاوت آنها در نوع دادهای است که مدل از آن یاد میگیرد:
- فاینتیون نظارتشده (SFT): با جفتهای ورودی و خروجی مطلوب آموزش میدهد. پیشفرض بیشتر کارها؛ از تخصص حوزه تا لحن و دنبالکردن دستور.
- بهینهسازی ترجیح مستقیم (DPO): از جفت پاسخهای ترجیحدادهشده و ردشده یاد میگیرد. برای بهبود کیفیت و ایمنی وقتی بازخورد مقایسهای دارید.
- فاینتیون تقویتی (RFT): با سیگنال پاداش از یک ارزیاب، رفتارهای پیچیده را بهینه میکند. برای حوزههای استدلالی با پاسخ درست یا غلط روشن، مثل ریاضی.
توصیهی عملی ساده است: با SFT شروع کنید. این روش بیشترین سناریوها را پوشش میدهد و آمادهسازی دادهاش سادهتر است.
سطح آموزش و مدل پایه
در Foundry میتوانید مشخص کنید آموزش کجا و چطور انجام شود. سطح استاندارد داده را در منطقهی جغرافیایی شما نگه میدارد؛ برای وقتی که محل داده اهمیت دارد. سطح جهانی ارزانتر و سریعتر است، چون از ظرفیت مناطق دیگر استفاده میکند. سطح توسعهدهنده هم ارزانترین است، اما تضمین زمانی ندارد و برای آزمایش مناسب است.
مدلهای قابل فاینتیون شامل مدلهای کوچک و متوسط OpenAI و مدلهای وزنباز مثل Llama، Qwen و Mistral است. فهرست دقیق مرتب تغییر میکند؛ پیش از شروع، مستندات پلتفرم را ببینید. یک قاعدهی کلی هم وجود دارد: اگر هدف کاهش هزینه است، مدل کوچکتری را فاینتیون کنید که بعد از آموزش، کار مدل بزرگتر را انجام دهد.
آمادهسازی داده
دادهی آموزش معمولاً در قالب JSONL است؛ یعنی هر خط یک نمونهی کامل گفتوگو. هر نمونه همان پیام سیستمی، پرسش کاربر و پاسخ مطلوب را دارد:
{"messages": [{"role": "system", "content": "تو دستیار بازخورد تکالیف هستی. بازخورد را در سه بخش نقاط قوت، اشکالات و قدم بعدی بنویس."}, {"role": "user", "content": "تکلیف: تابعی برای محاسبهی میانگین نوشتهام اما برای فهرست خالی خطا میدهد."}, {"role": "assistant", "content": "نقاط قوت: ساختار تابع روشن است.\nاشکالات: حالت فهرست خالی بررسی نشده است.\nقدم بعدی: پیش از تقسیم، خالی بودن فهرست را بررسی کنید."}]}با ۵۰ تا ۱۰۰ نمونهی باکیفیت شروع کنید تا رویکرد تأیید شود. برای استفادهی تولیدی به چند صد نمونه برسید. نمونههای ضعیف را حذف کنید؛ کیفیت از کمیت مهمتر است. همیشه یک فایل اعتبارسنجی جدا هم داشته باشید تا بیشبرازش را تشخیص دهید.
بهترین روشهای فاینتیون
چند نکتهی عملی تفاوت یک فاینتیون موفق با یک هزینهی هدررفته را میسازد. همهی این نکتهها از تجربهی تیمهایی آمده که این مسیر را رفتهاند.
در آموزش
پیش از هر چیز خط مبنا را بسنجید. همان پیام سیستمی را که در آموزش استفاده کردهاید، هنگام استفاده از مدل هم نگه دارید؛ تغییرش ممکن است رفتار آموختهشده را خراب کند.
کورکورانه آخرین نقطهی ذخیره را مستقر نکنید. پلتفرمها معمولاً چند نقطهی ذخیرهی آخر آموزش را نگه میدارند. با نگاه به خطای آموزش و خطای اعتبارسنجی، نسخهای را انتخاب کنید که بهترین تعمیم را دارد. اگر خطای آموزش پایین میرود اما خطای اعتبارسنجی بالا، مدل در حال حفظکردن است.
پس از آموزش
هزینهی توکن را همراه کیفیت بسنجید. مدل فاینتیونشده باید در مجموع ارزش هزینهاش را داشته باشد. هزینهی میزبانی را هم فراموش نکنید؛ مدل سفارشی مستقرشده معمولاً ساعتی هزینه دارد. استقرارهای بلااستفاده را پاک کنید.
فاینتیون هم یک کار یکباره نیست. میتوانید مدل فاینتیونشده را با دادهی تازه دوباره فاینتیون کنید. برای شروع عملی، راهنمای فاینتیون مدلهای چت در OpenAI Cookbook و برای مدلهای وزنباز کتابخانههایی مثل TRL و Unsloth نقطهی شروع خوبیاند.
آزمایش پیشنهادی؛ آیا مدل واقعاً یاد گرفته است؟
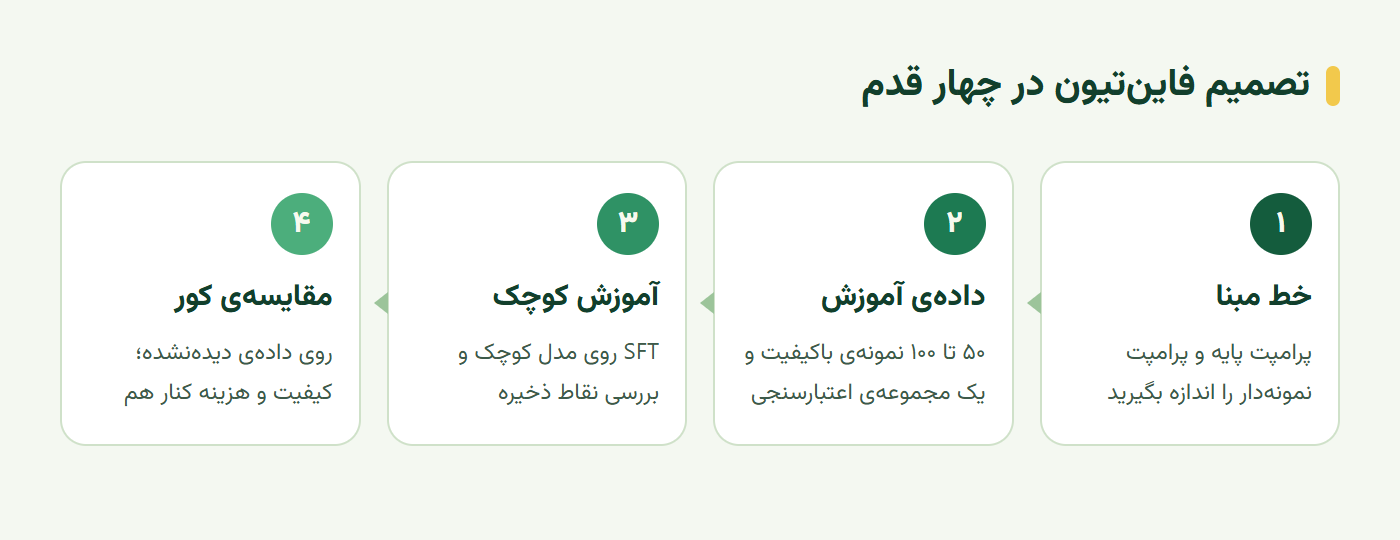
حالا مهمترین بخش را روی یک سناریو پیاده میکنیم. مدرسان میخواهند بازخورد تکالیف همیشه در سه بخش مشخص نوشته شود و لحن آن در رشتههای مختلف ثابت بماند. نمودار زیر چهار قدم این آزمایش را نشان میدهد.
سه نسخه، یک آزمون
سه نسخه را مقایسه میکنید: پرامپت پایه، پرامپت همراه چند مثال، و مدل فاینتیونشده. ورودی آزمون نمونههای بازخورد تأییدشده و یک مجموعهی ارزیابی مستقل است. معیار پذیرش سه بخش دارد: رعایت قالب سهبخشی، درستی بازخورد و عملکرد روی تکالیفی که در آموزش نبودهاند.
یک نکتهی مهم دربارهی مجموعهی ارزیابی: فرض کنید بیشتر دادهی آموزش دربارهی تمرینهای برنامهنویسی بوده است. اگر آزمون را هم از همان جنس بگیرید، فقط شباهت را سنجیدهاید. یک بخش ارزیابی جدا برای موضوع تازه، مثلاً ریاضی یا نگارش، بگذارید.
ارزیابی کور و نتیجهی گروهی
پاسخ نسخهی فاینتیوننشده را هم نگه دارید. بازبین هنگام نمرهدادن نباید بداند هر پاسخ از کدام نسخه است؛ این همان ارزیابی کور است. وگرنه انتظار بهتر بودن مدل جدید، ناخودآگاه روی نمره اثر میگذارد.
نتیجه را هم فقط در یک میانگین خلاصه نکنید. ممکن است مدل روی تکالیف برنامهنویسی بهتر و روی تکالیف نگارش بدتر شده باشد. نتیجهی هر گروه را جدا گزارش کنید.
نمونهی شکست؛ نشت آزمون به آموزش
خطرناکترین شکست این آزمایش، قرار گرفتن نمونههای آزمون در دادهی آموزش است. در این حالت مدل پاسخ آزمون را از قبل دیده و نتیجه تصوری کاذب از بهبود میسازد. این اتفاق بیشتر از آنچه فکر میکنید رخ میدهد؛ مخصوصاً وقتی دادهها از یک منبع جمع شده باشند.
نمونههای ناموفق را هم بلافاصله به دادهی آموزش اضافه نکنید. اول علت شکست را بررسی کنید و بخشی از آنها را برای آزمون آینده نگه دارید. در غیر این صورت، با هر دور اصلاح، مجموعهی آزمون کمکم به بخشی از دادهی آموزش تبدیل میشود و دیگر چیزی را نمیسنجد.
تمرین عملی؛ گزارش تصمیم فاینتیون
خروجی این تمرین یک گزارش تصمیم است؛ انجام فاینتیون یا کنار گذاشتن آن:
- رفتار هدف را در یک جملهی قابل سنجش بنویسید.
- خط مبنای پرامپت پایه و پرامپت نمونهدار را روی مجموعهی ارزیابی اندازه بگیرید.
- اگر فاینتیون کردید، نتیجهی ارزیابی کور را به تفکیک گروهها گزارش کنید.
تصمیم نهایی را با هزینهها مقایسه کنید. مشخص کنید کدام بخش را واقعاً اجرا کردهاید و کدام بخش هنوز فرض است. گزارشی که نتیجهاش «فاینتیون لازم نیست» باشد، به همان اندازه ارزشمند است.
سخن پایانی
فاینتیون مدل زبانی ابزاری قدرتمند است، اما اولین ابزار نیست. پیش از آن پرامپت و RAG را بسنجید و خط مبنا بسازید. اگر رفتار پایدار، لحن ثابت یا مدل کوچکتر و ارزانتر لازم داشتید، با SFT و چند ده نمونهی باکیفیت شروع کنید. در ارزیابی هم سختگیر باشید؛ دادهی دیدهنشده، ارزیابی کور و گزارش گروهی نشان میدهند مدل واقعاً یاد گرفته یا فقط حفظ کرده است.
در قسمت بعد سراغ مدلهای زبانی کوچک میرویم و میبینیم کجا یک مدل کوچک کار مدل بزرگ را انجام میدهد.
این آموزش بر پایهی درس Fine-Tuning Your LLM از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
فاینتیون مدل زبانی یعنی چه؟
یعنی آموزش دوبارهی یک مدل آماده با نمونههای ورودی و خروجی خودتان تا در یک کار مشخص بهتر عمل کند. نتیجه یک مدل تازه با وزنهای بهروزشده است که بدون آوردن مثال در پرامپت، رفتار مطلوب را نشان میدهد.
پیش از فاینتیون چه کارهایی باید امتحان کرد؟
مهندسی پرامپت و یادگیری چندنمونهای، و اگر مشکل کمبود دانش است، RAG. نتیجهی این روشها را اندازه بگیرید تا خط مبنایی برای مقایسه داشته باشید؛ بدون خط مبنا نمیتوانید ثابت کنید فاینتیون بهبود داده است.
برای فاینتیون چند نمونه لازم است؟
برای آزمودن رویکرد، ۵۰ تا ۱۰۰ نمونهی باکیفیت کافی است. برای استفادهی تولیدی معمولاً چند صد نمونه لازم میشود. کیفیت نمونهها از تعدادشان مهمتر است و یک مجموعهی اعتبارسنجی جدا هم باید داشته باشید.
فرق SFT، DPO و RFT چیست؟
SFT با جفتهای ورودی و خروجی مطلوب آموزش میدهد و پیشفرض بیشتر کارهاست. DPO از جفت پاسخهای ترجیحدادهشده و ردشده یاد میگیرد. RFT با سیگنال پاداش از یک ارزیاب، رفتارهای استدلالی پیچیده را بهینه میکند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.