
چرخه عمر برنامه هوش مصنوعی با یک نکتهی غافلگیرکننده شروع میشود: رفتار دستیار میتواند بدون تغییر حتی یک خط کد عوض شود. کافی است پرامپت را کمی ویرایش کنید، مدل را به نسخهی جدید ببرید یا اسناد مرجع را بهروز کنید. نمونهی اولیه وقتی موفق است که یک کار را انجام دهد. اما محصول وقتی قابلاتکاست که تغییراتش قابل پیگیری باشند.
در این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز، چرخهی عمر یک برنامهی مبتنی بر مدل زبانی را از ایده تا عملیات مرور میکنیم. سپس میبینیم چطور هر تغییر را منتشر کنیم تا اگر کیفیت افت کرد، علتش را پیدا کنیم و به نسخهی قبل برگردیم.
چرا چرخه عمر برنامه هوش مصنوعی مهم است؟
هوش مصنوعی حوزهای است که با سرعت زیاد تغییر میکند. مدلهای تازه هر چند ماه یک بار میآیند، قیمتها عوض میشوند و انتظار کاربران بالا میرود. بنابراین برنامهای که امروز خوب کار میکند، اگر مدیریت نشود، چند ماه بعد عقب میماند.
چرخهی عمر هوش مصنوعی مولد چارچوبی است که شما را در توسعه، استقرار و نگهداری برنامه راهنمایی میکند. این چارچوب کمک میکند هدف را تعریف کنید و عملکرد را بسنجید. همچنین چالشها را پیدا میکنید و راهحل را پیاده میکنید. بدون این چارچوب، هر تغییر یک قمار است.
یک تشبیه ساده کمک میکند. چرخهی عمر شبیه دفترچهی سرویس خودرو است. هر بار که روغن یا لنت عوض میشود، تاریخ و قطعه در دفترچه ثبت میشود. در نتیجه اگر خودرو صدای عجیبی داد، تعمیرکار میداند آخرین تغییر چه بوده است. البته این تشبیه یک حد دارد: خودرو با گذشت زمان فرسوده میشود، اما رفتار دستیار معمولاً فقط با تغییرهای شما یا ارائهدهندهی مدل عوض میشود.
از MLOps به LLMOps
مدلهای زبانی بزرگ ابزار تازهای در جعبهابزار هوش مصنوعیاند. در تحلیل و تولید بسیار قدرتمندند، اما همین قدرت شیوهی کار با هوش مصنوعی را تغییر داده است. برنامههای قدیمیتر را میتوان «برنامههای یادگیری ماشین» نامید و برنامههای جدید را «برنامههای هوش مصنوعی مولد».
تفاوت در عمل
در MLOps، یعنی عملیات یادگیری ماشین، تیم معمولاً مدل را خودش آموزش میدهد. تمرکز بر جمعآوری داده، آموزش مدل و استقرار آن است و دانشمند داده نقش اصلی دارد. در مقابل، در LLMOps، یعنی عملیات مدلهای زبانی بزرگ، بیشتر از مدلهای آماده بهشکل سرویس استفاده میشود. به همین دلیل توسعهدهندهی برنامه نقش محوری پیدا میکند.
تفاوت این دو مثل نانوایی و ساندویچی است. نانوا خودش خمیر را ورز میدهد و نان میپزد. اما ساندویچی نان آماده میخرد و هنرش در ترکیب مواد، سرعت سرو و یکدست بودن طعم است. البته ساندویچی هم اگر نانواییاش عوض شود، باید طعم ساندویچها را دوباره بچشد.
پس کار اصلی در LLMOps یکپارچهسازی است؛ یعنی وصلکردن مدل به داده، ابزار و رابط کاربری. مهارتهای تازهای هم لازم شده است: طراحی پرامپت، RAG، ارزیابی پاسخ و هوش مصنوعی مسئولانه. جدول زیر تفاوتها را کنار هم میگذارد.
| جنبه | MLOps | LLMOps |
|---|---|---|
| منبع مدل | معمولاً آموزش توسط تیم | معمولاً مدل آماده بهصورت سرویس |
| نقش محوری | دانشمند داده | توسعهدهندهی برنامه |
| کار اصلی | آموزش و استقرار مدل | پرامپت، یکپارچهسازی و RAG |
| شیوهی ارزیابی | معیارهای عددی روی دادهی برچسبدار | کیفیت، اتکا به منبع و آسیب پاسخ |
| چیزهایی که نسخهبندی میشوند | داده و مدل | مدل، پرامپت، اسناد و تنظیمات |
پنج معیار LLMOps
در LLMOps عملکرد را با پنج معیار میسنجیم. هر کدام پرسش متفاوتی را جواب میدهد:
- کیفیت: پاسخ چقدر خوب و مفید است؟
- آسیب: آیا پاسخ اصول هوش مصنوعی مسئولانه را رعایت میکند؟
- صداقت: آیا پاسخ منطقی و درست است و به منبع متکی است؟
- هزینه: آیا راهحل در بودجهی تعیینشده میماند؟
- تأخیر: میانگین زمان تولید پاسخ چقدر است؟
این پنج معیار باید در همهی مراحل چرخه سنجیده شوند؛ نه فقط پیش از انتشار. زیرا هر تغییر ممکن است یکی را بهتر و دیگری را بدتر کند. مثلاً مدل ارزانتر هزینه را کم میکند، اما شاید صداقت پاسخ را هم پایین بیاورد.
سه مرحلهی چرخهی عمر
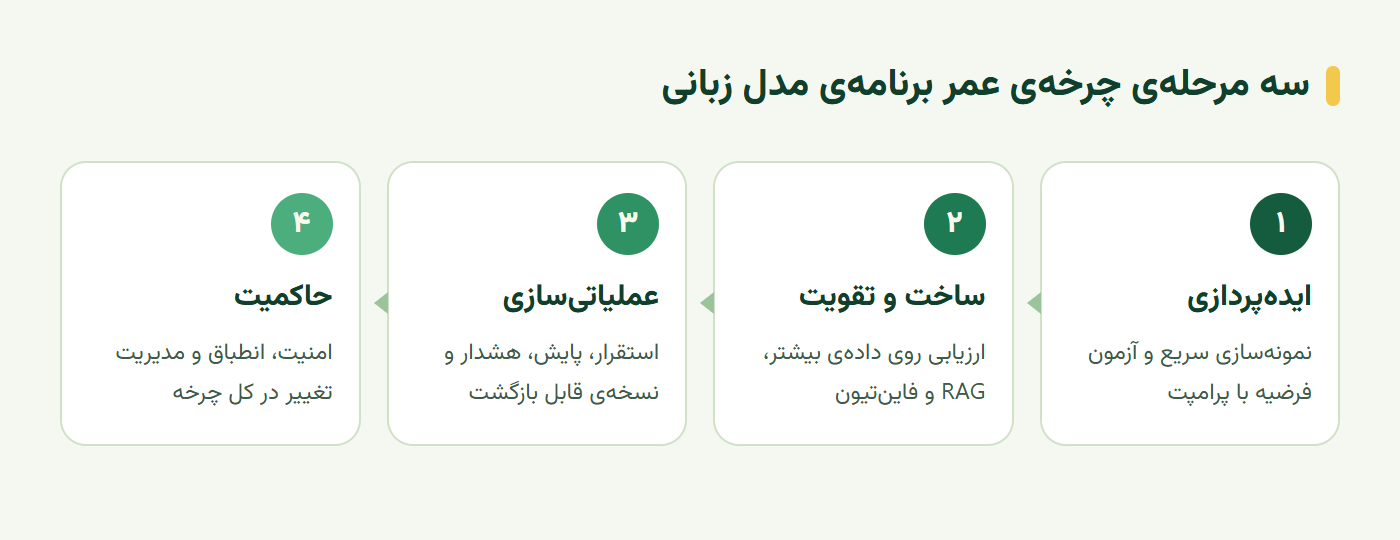
چرخهی عمر برنامهی مدل زبانی با چرخهی کلاسیک MLOps فرق دارد. نیازهای تازهای مثل طراحی پرامپت، روشهای بهبود کیفیت و ارزیابی متفاوت در آن وجود دارد. همچنین این چرخه خطی نیست؛ حلقههایی تکراری دارد که بارها به عقب برمیگردند. نمودار زیر مراحل اصلی را نشان میدهد.
ایدهپردازی و کاوش
در این مرحله بر اساس نیاز کسبوکار کاوش میکنید. با مهندسی پرامپت، چند مدل را آزمایش میکنید تا ببینید فرضیهتان درست است یا نه. ابزارهایی مثل PromptFlow کمک میکنند یک نمونهی اولیهی سریع بسازید و آزمایشش کنید.
هدف این مرحله کمال نیست؛ بلکه پاسخ به یک پرسش است: آیا این ایده اصلاً شدنی است؟ اگر نمونهی اولیه روی چند مثال واقعی کار نکرد، زود رهایش کنید یا مسیر را عوض کنید.
ساخت و تقویت
وقتی فرضیه تأیید شد، ارزیابی را روی دادهی بیشتری انجام میدهید. در این مرحله تکنیکهایی مثل RAG و فاینتیون را امتحان میکنید تا ببینید راهحل چقدر مقاوم است. اگر نتیجه کافی نبود، جریان را بازطراحی میکنید. گاهی هم مرحلههای تازه اضافه میکنید یا دادهها را بازسازی میکنید.
این مرحله بیشترین تکرار را دارد. پس هر بار که چیزی را عوض میکنید، مجموعهی آزمون ثابت را دوباره اجرا کنید. به این ترتیب میفهمید تغییر واقعاً بهبود بوده یا فقط روی یک مثال خوششانس جواب داده است.
عملیاتیسازی
در این مرحله سامانههای پایش و هشدار را اضافه میکنید و برنامه را مستقر و با سیستمهای دیگر یکپارچه میکنید. علاوه بر این، دور همهی این مراحل یک چرخهی مدیریتی قرار دارد. این چرخه بر امنیت، انطباق با قوانین و حاکمیت تمرکز میکند.
برای نمونهی عملی یک برنامهی کامل، مخزن Contoso Chat مایکروسافت یک چتبات فروشگاهی را با همین چرخه نشان میدهد؛ از ایده تا استقرار.
بیشتر بخوانید: معیارها و روشهای پایش که در مرحلهی عملیاتیسازی لازم دارید، در ارزیابی ایجنت هوش مصنوعی با جزئیات آمدهاند.
ابزارهای چرخهی عمر
مایکروسافت برای این چرخه دو ابزار اصلی پیشنهاد میکند. Microsoft Foundry، که پیشتر Azure AI Studio بود، پورتالی وب برای کاوش مدلها، آزمایش نمونهها، ارزیابی و استقرار است. همچنین منابعی مثل جستجوی برداری و پایگاه داده را در یکجا مدیریت میکند.
PromptFlow ابزار ساخت جریانهای مبتنی بر مدل زبانی است؛ از اثبات مفهوم تا برنامهی مقیاس بزرگ. میتوانید در VS Code جریان را با ابزارهای تصویری طراحی، آزمایش و تنظیم کنید و سپس در فضای ابری منتشرش کنید. البته ابزارهای مشابه از ارائهدهندگان دیگر هم وجود دارد. مهم این است که چرخه را با ابزاری مدیریت کنید، نه با حافظهی تیم.
بهداشت فنی در هر نسخه
جدا از مراحل کلی، چند نکتهی فنی در هر نسخهی برنامه باید رعایت شود. این نکتهها سادهاند، اما فراموشکردنشان هزینهی سنگینی دارد.
رازها بیرون از کد
کلید API هرگز نباید داخل کد باشد. آن را در متغیر محیطی یا فایل .env نگه دارید و این فایل را به .gitignore اضافه کنید. سپس در کد با کتابخانهای مثل python-dotenv آن را بخوانید:
import os
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
در محیطهای ابری از مدیر رازها استفاده کنید؛ مثل Secrets در GitHub Codespaces یا Key Vault در Azure. این کار هم امنیت را بالا میبرد و هم تعویض کلید را بدون تغییر کد ممکن میکند.
توکن، تنظیمات و مدلهای استدلالی
هزینه بر اساس توکن محاسبه میشود. پس سقف طول پاسخ را تعیین کنید؛ در Responses API با پارامتر max_output_tokens و در Chat Completions با max_completion_tokens. پرامپت را هم تا جای ممکن فشرده نگه دارید. تنظیماتی مثل temperature نیز بخشی از نسخهی شما هستند و باید ثبت شوند.
یک تغییر مهم را هم در نظر داشته باشید. بسیاری از مدلهای استدلالی جدید OpenAI، وقتی سطح استدلال (reasoning effort) روی چیزی جز none باشد، پارامترهای temperature و top_p را نمیپذیرند. اگر مدل را به چنین نسخهای ارتقا دهید و کدتان این پارامتر را بفرستد، خطا میگیرید. این دقیقاً از همان تغییرهایی است که بدون آزمون پیش از انتشار، به کاربر میرسد.
نسخهی قابل بازگشت؛ سناریوی بهروزرسانی سرفصل
حالا مهمترین درس این قسمت را روی یک سناریو پیاده میکنیم. سرفصل یک دوره تغییر کرده است. تیم باید اسناد و پرامپت دستیار را بهروز کند، بدون اینکه پاسخهای قبلی خراب شوند.
ورودی و اقدام
ورودی آزمون سه بخش دارد: نسخهی قبلی اسناد، نسخهی جدید و مجموعهای از پرسشهای ثابت. پرسشها باید هم دورهی تغییرکرده و هم دورههای دیگر را پوشش دهند. یک نمونهی ناقص هم بگذارید؛ مثلاً پرسش دربارهی بخشی از سرفصل که حذف شده است.
اقدام سه مرحله دارد. ابتدا یک نسخهی آزمایشی میسازید. سپس مجموعهی آزمون را روی نسخهی قبلی و جدید اجرا و مقایسه میکنید. در نهایت نتیجه را پیش از انتشار ثبت میکنید. معیار پذیرش هم روشن است: پاسخهای سرفصل جدید درست باشند و کیفیت پرسشهای قدیمی افت نکند.
اسکریپت آزمون ثابت برای دو نسخه
به این آزمون ثابت، آزمون رگرسیون (Regression test) میگویند؛ یعنی بررسی اینکه چیزی که قبلاً درست کار میکرد، خراب نشده باشد. مثل چکلیست ثابتی است که تعمیرگاه بعد از هر تعمیر روی خودرو اجرا میکند: ترمز، چراغها و بوق، حتی اگر فقط لاستیک عوض شده باشد.
اسکریپت پایتون زیر دو نسخهی پیام سیستمی را روی پرسشهای ثابت اجرا میکند. برای هر پرسش، عبارتی که پاسخ درست باید داشته باشد را از قبل نوشتهایم. نام مدل و متنها نمونهی فرضیاند؛ آنها را با دادهی خودتان عوض کنید.
from openai import OpenAI
client = OpenAI() # کلید از متغیر محیطی OPENAI_API_KEY خوانده میشود
MODEL = "gpt-4o-mini" # نمونه؛ نسخهی دقیق مدل را ثابت نگه دارید
prompts = {
"v1": "تو دستیار دورهها هستی. فقط از متن سرفصل پاسخ بده.\nسرفصل: جلسه ۳ درباره حلقهها است.",
"v2": "تو دستیار دورهها هستی. فقط از متن سرفصل پاسخ بده.\nسرفصل: جلسه ۳ درباره توابع است.",
}
tests = [ # (پرسش، عبارتی که پاسخ درست باید داشته باشد)
("جلسه ۳ درباره چیست؟", "توابع"),
("جلسه ۹ درباره چیست؟", "نمیدانم"), # نمونهی ناقص
]
for version, system in prompts.items():
passed = 0
for question, expected in tests:
answer = client.chat.completions.create(
model=MODEL,
messages=[{"role": "system", "content": system + "\nاگر جواب در سرفصل نیست بگو «نمیدانم»."},
{"role": "user", "content": question}],
).choices[0].message.content
passed += expected in answer
print(version, f"{passed}/{len(tests)}")خروجی برای هر نسخه یک عدد مثل v2 2/2 است. اگر نسخهی جدید در پرسشهای قدیمی امتیاز کمتری گرفت، منتشرش نکنید. البته بررسی با «وجود یک عبارت» سادهترین روش است. برای پاسخهای بازتر، بعدها از ارزیابی با کمک مدل یا بازبین انسانی استفاده کنید.
برگهی انتشار
هر نسخه باید یک برگهی انتشار داشته باشد که دقیقاً بگوید چه چیزی عوض شده است. این برگه مثل رسید تعمیرگاه است؛ اگر فردا مشکلی پیش آمد، اولین جایی است که نگاه میکنید.
برگه را کنار کد در همان مخزن گیت نگه دارید تا تاریخچهاش گم نشود. جدول زیر یک قالب ساده است.
| مورد | نسخهی قبلی | نسخهی جدید | تغییر کرده؟ |
|---|---|---|---|
| مدل | |||
| پرامپت و پیام سیستمی | |||
| اسناد مرجع | |||
| تنظیمات مدل | |||
| نتیجهی مجموعهی آزمون | |||
| مسیر بازگشت |
نمونهی شکست؛ چند تغییر همزمان
خطرناکترین اشتباه در این سناریو، انتشار همزمان چند تغییر است. فرض کنید هم اسناد را بهروز کردهاید، هم پرامپت را بهتر کردهاید و هم مدل را ارتقا دادهاید. حالا کیفیت پاسخها افت کرده است. کدام تغییر مقصر است؟ نمیدانید.
راهحل ساده است: تغییرها را یکییکی منتشر کنید و بعد از هر کدام مجموعهی آزمون را اجرا کنید. مسیر بازگشت را هم پیش از انتشار آماده کنید. اگر نسخهی جدید مشکل داشت، باید بتوانید در چند دقیقه به نسخهی قبل برگردید، نه در چند روز.
تمرین عملی؛ برگهی انتشار دستیار
برای دستیاری که در این مجموعه ساختهاید، یک فرایند انتشار ساده بسازید. آخرین بار که پرامپت دستیارتان را عوض کردید، میدانستید پاسخ کدام پرسشها تغییر کرد؟
- همهی چیزهایی را که رفتار دستیار را تغییر میدهند فهرست کنید: مدل، پرامپت، اسناد و تنظیمات.
- برای هر کدام یک شمارهی نسخه تعیین و در گیت ثبت کنید.
- یک مجموعهی آزمون دهپرسشی بسازید و قبل از هر انتشار اجرایش کنید.
در پایان یک تغییر کوچک، مثلاً ویرایش پیام سیستمی، را با همین فرایند منتشر کنید و برگهی انتشارش را پر کنید. مشخص کنید کدام بخش را واقعاً اجرا کردهاید.
سخن پایانی
چرخه عمر برنامه هوش مصنوعی به ما یادآوری میکند که رفتار برنامه فقط در کد نیست؛ در مدل، پرامپت، اسناد و تنظیمات هم هست. LLMOps این پیچیدگی را با پنج معیار کیفیت، آسیب، صداقت، هزینه و تأخیر مدیریت میکند. همچنین سه مرحلهی ایدهپردازی، ساخت و عملیاتیسازی را پیش میبرد.
در نهایت نسخهبندی همهی اجزا، انتشار تکبهتک تغییرها و مسیر بازگشت آماده، تفاوت یک نمونهی موفق با یک محصول قابلاتکاست.
در قسمت بعد بررسی میکنیم فاینتیون چه زمانی ارزش دارد و چطور پیش از آموزش، آزمایش درستی طراحی کنیم.
این آموزش بر پایهی درس The Generative AI Application Lifecycle از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- ارزیابی ایجنت هوش مصنوعی؛ سنجش کیفیت، زمان و هزینه: مرور فارسی معیارها و مجموعهی آزمون؛ مکمل همین درس برای سطح متوسط.
- درس The Generative AI Application Lifecycle (انگلیسی): متن اصلی این آموزش در دورهی آزاد مایکروسافت؛ برای سطح مبتدی.
- مستندات PromptFlow (انگلیسی): ساخت، آزمون و ارزیابی جریانهای مدل زبانی؛ برای سطح متوسط.
- رویکردهای ارزیابی هوش مصنوعی مولد در Microsoft Foundry (انگلیسی): ارزیابی در هر مرحلهی چرخهی عمر؛ برای سطح متوسط.
- راهنمای Evals در مستندات OpenAI (انگلیسی): ساخت ارزیابی خودکار برای مقایسهی نسخهها؛ برای سطح پیشرفته.
پرسشهای پرتکرار
LLMOps چه فرقی با MLOps دارد؟
در MLOps تیم معمولاً مدل را خودش آموزش میدهد و تمرکز بر داده و آموزش مدل است. در LLMOps بیشتر از مدلهای آماده بهصورت سرویس استفاده میشود و تمرکز بر طراحی پرامپت، یکپارچهسازی، RAG و ارزیابی پاسخهاست.
در LLMOps چه چیزهایی را باید نسخهبندی کرد؟
علاوه بر کد، نسخهی مدل، متن پرامپت و پیام سیستمی، اسناد مرجع RAG، تنظیمات مدل و مجموعهی آزمون. هر کدام از اینها رفتار برنامه را تغییر میدهد و بدون نسخهبندی، علت افت کیفیت قابل ردیابی نیست.
چرا نباید چند تغییر را همزمان منتشر کرد؟
اگر مدل، پرامپت و اسناد با هم عوض شوند و کیفیت پایین بیاید، نمیدانید کدام تغییر مقصر است. انتشار تغییرها یکییکی، همراه اجرای مجموعهی آزمون ثابت، تشخیص علت و بازگشت را ممکن میکند.
کلید API را در برنامهی هوش مصنوعی کجا نگه داریم؟
هرگز داخل کد. کلید را در متغیر محیطی یا فایل .env که در گیت ثبت نمیشود نگه دارید و در محیطهای ابری از مدیر رازها مثل Codespaces Secrets یا Key Vault استفاده کنید.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.