
جستجوی معنایی یعنی موتور جستجو منظور شما را بفهمد، نه فقط کلمههایتان را. اگر در یک فروشگاه اینترنتی بنویسید «ماشین رویایی من»، جستجوی کلمهای شاید دنبال متنهایی دربارهی «رویا» بگردد. جستجوی معنایی اما میفهمد دنبال خودروی ایدئال برای خرید هستید.
مدلهای زبانی فقط برای چتبات و تولید متن نیستند. با قابلیتی به نام Embedding میتوان موتور جستجویی ساخت که بر اساس معنا کار میکند. در این قسمت از مجموعهی «از پرامپت تا دستیار هوش مصنوعی» میبینیم Embedding چیست، شاخص برداری چطور ساخته میشود و شباهت کسینوسی چطور نزدیکترین پاسخ را پیدا میکند.
جستجوی معنایی چیست و چه فرقی با جستجوی کلمهای دارد؟
جستجوی کلمهای سالها روش اصلی جستجو بوده است. کلمههای پرسش را میگیرد و متنهایی را پیدا میکند که همان کلمهها را دارند. این روش سریع است، اما وقتی کاربر منظورش را با کلمههای دیگری بیان کند، شکست میخورد.
در مقابل، جستجوی معنایی از معنای کلمهها استفاده میکند. پرسش «چطور وزن کم کنم؟» میتواند مقالهای با عنوان «راهکارهای کاهش چربی بدن» را پیدا کند، با اینکه تقریباً هیچ کلمهی مشترکی ندارند. همین قابلیت پایهی دستیارهایی است که از روی اسناد پاسخ میدهند.
مثال واقعی؛ جستجو در ویدئوهای آموزشی
درسنامهی مایکروسافت یک سناریوی جذاب دارد. یک مؤسسهی آموزشی صدها ویدئوی آموزشی دربارهی هوش مصنوعی دارد. دانشجو باید بتواند سؤالش را تایپ کند و ویدئوی مرتبط را پیدا کند؛ آن هم دقیقاً با لینک به دقیقهای که پاسخ در آن گفته شده است.
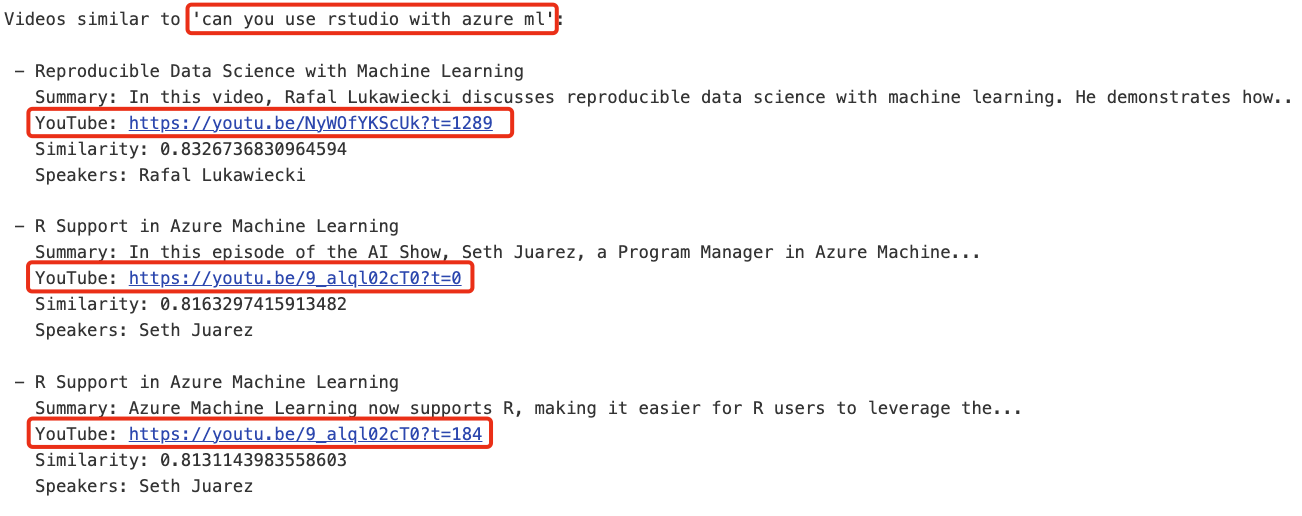
برای این کار متن پیادهشدهی همهی ویدئوهای یک کانال آموزشی جمعآوری شد. بعد برای هر قطعهی سهدقیقهای یک بردار معنایی ساخته شد. حالا اگر دانشجو بپرسد «آیا میشود RStudio را با Azure ML استفاده کرد؟»، سیستم ویدئوهای مرتبط را همراه زمان دقیق پاسخ برمیگرداند.
خروجی همین جستجو را در تصویر زیر میبینید. هر نتیجه یک خلاصه، لینک با زمان دقیق و عدد شباهت دارد.
Embedding چیست؟
Embedding (بردار معنایی) یک روش نمایش متن در پردازش زبان طبیعی است. متن را به فهرستی از عددها، یعنی یک بردار، تبدیل میکند. این عددها معنای متن را طوری نشان میدهند که کامپیوتر بتواند آن را مقایسه کند.
سادهترین تصویر، نقشهی شهر است. هر متن یک نقطه روی نقشه میگیرد و متنهای هممعنا در یک محله کنار هم مینشینند؛ «نانوایی» نزدیک «شیرینیفروشی» است و دور از «تعمیرگاه». حد این تشبیه این است که نقشهی شهر دو بعد دارد، اما بردار معنایی صدها یا هزاران بعد دارد که هیچکدام بهتنهایی معنای روشنی ندارند.
فرض کنید جملهی «امروز دربارهی یادگیری ماشین در Azure یاد میگیریم» را به API مخصوص Embedding بفرستید. پاسخ برداری با ۱۵۳۶ عدد است. هر عدد جنبهای از معنای جمله را نشان میدهد؛ مثلاً ده عدد اول چیزی شبیه این است:
[-0.0066, 0.0026, 0.0087, -0.0244, -0.0085, 0.0220, -0.0107, 0.0033, -0.0116, -0.0218, ...]این عددها بهتنهایی معنایی برای ما ندارند. ارزششان در مقایسه است. دو جمله با معنای نزدیک، بردارهای نزدیکی دارند؛ حتی اگر کلمههایشان کاملاً متفاوت باشد.
ساخت شاخص برداری در پنج مرحله
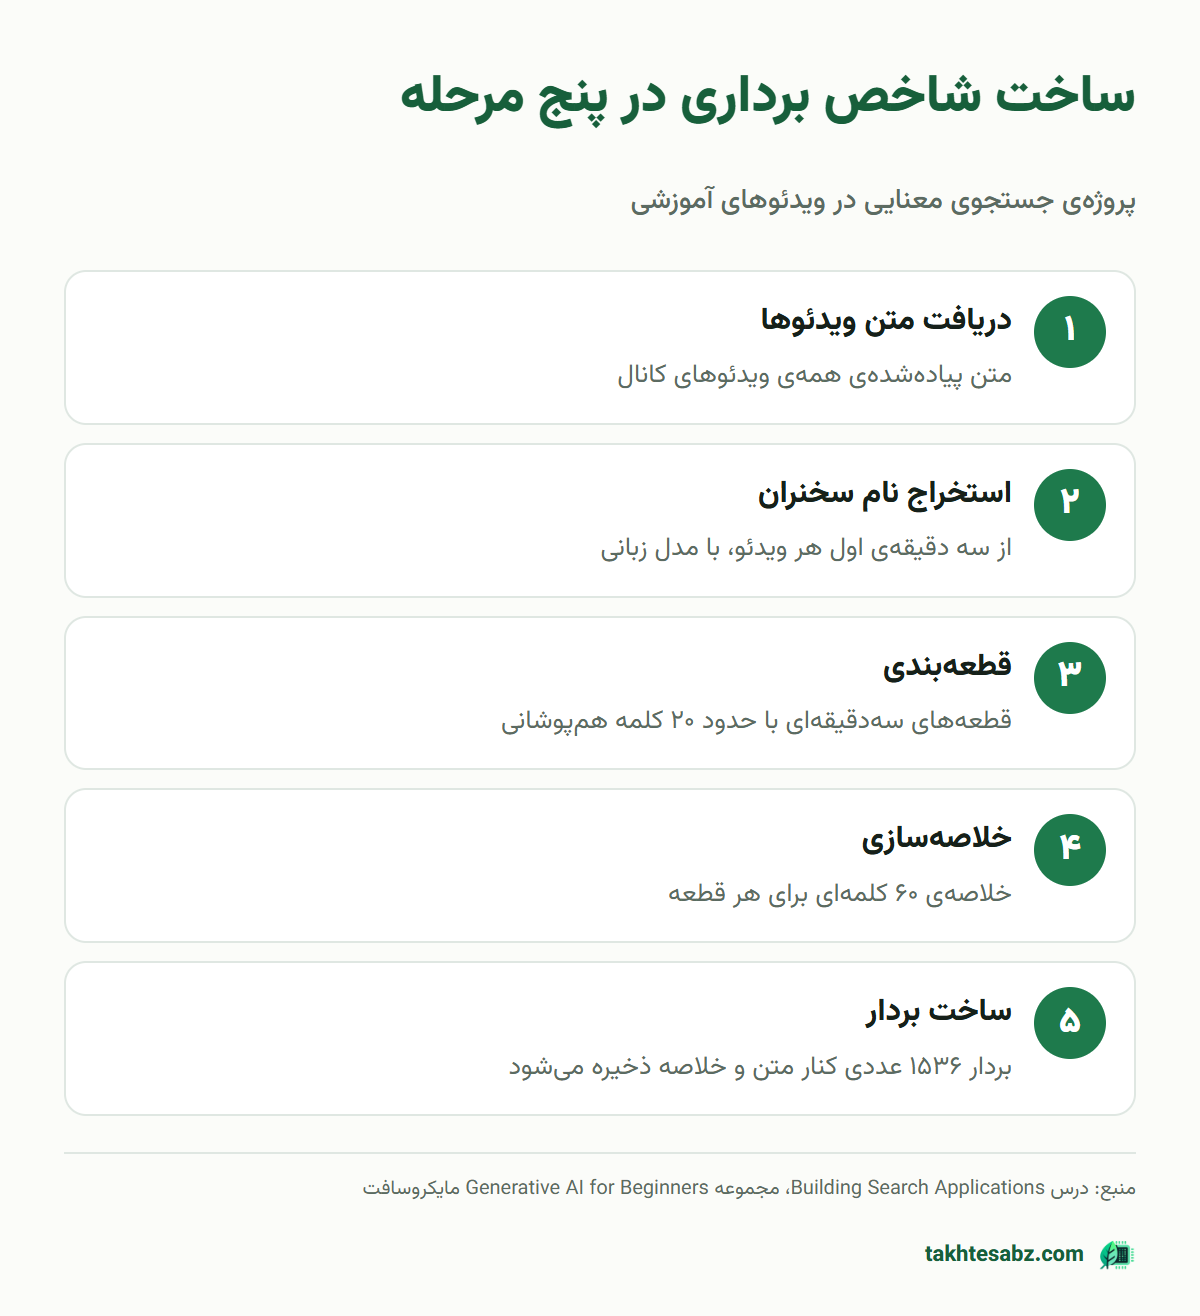
برای اینکه بتوانیم در مجموعهای از متنها جستجو کنیم، اول باید برای همهی آنها بردار بسازیم و ذخیرهشان کنیم. به این مجموعه «شاخص برداری» یا Embedding Index میگویند. شاخص برداری شبیه برگهدان یک کتابخانه است؛ بهجای گشتن همهی قفسهها، کارتها را میگردید و مستقیم به کتاب میرسید. در پروژهی ویدئوها این شاخص در پنج مرحله ساخته شد.
از متن ویدئو تا بردار معنایی
ابتدا متن پیادهشدهی همهی ویدئوها دانلود شد. بعد با کمک مدل زبانی، نام سخنران از سه دقیقهی اول هر ویدئو استخراج شد. این اطلاعات بعداً در نتیجهی جستجو نمایش داده میشود.
مرحلهی سوم تقسیم متن به قطعههای سهدقیقهای بود. هر قطعه حدود بیست کلمه با قطعهی بعدی همپوشانی دارد تا جملهای وسط کار بریده نشود و زمینه حفظ شود. در مرحلهی چهارم هر قطعه در شصت کلمه خلاصه شد. در پایان، متن هر قطعه به API مخصوص Embedding رفت و بردار ۱۵۳۶عددیاش کنار متن و خلاصه ذخیره شد.
قطعهبندی؛ تصمیمی که کیفیت را میسازد
اندازهی قطعهها روی کیفیت جستجو اثر مستقیم دارد. قطعهبندی (Chunking) مثل بریدن یک کتاب آشپزی به کارتهای دستور پخت است؛ هر کارت باید یک غذای کامل باشد، نه نصف دو غذا. قطعهی خیلی بزرگ چند موضوع را قاطی میکند و بردارش معنای روشنی ندارد. از طرف دیگر، قطعهی خیلی کوچک هم زمینهی کافی ندارد و نتیجه را تکهتکه میکند.
برای مقالهها و مستندات، قطعهبندی بر اساس پاراگراف یا زیرعنوان معمولاً بهتر از تقسیم بر اساس تعداد کلمه است. همپوشانی کوتاه میان قطعهها هم، مثل همان بیست کلمه در پروژهی ویدئوها، کمک میکند جملههای مرزی گم نشوند.
پایگاه داده برداری
در درسنامه، شاخص برای سادگی در یک فایل JSON ذخیره و با Pandas خوانده شد. این روش برای یادگیری و دادهی کم کاملاً کافی است. در محیط واقعی و با دادهی زیاد، بردارها را در پایگاه دادهی برداری نگه میدارند.
گزینههای رایج Azure AI Search، Redis، Pinecone و Weaviate هستند. این پایگاهها برای پیدا کردن سریع نزدیکترین بردارها در میان میلیونها رکورد بهینه شدهاند.
متن پرسش کاربر قبل از جستجو معمولاً از یک چتبات میآید. اگر ساختار حلقهی گفتوگو را ندیدهاید، قسمت قبل را بخوانید.
بیشتر بخوانید: ساخت چتبات هوش مصنوعی با پایتون؛ از طراحی تا سنجش کیفیت
شباهت کسینوسی؛ چطور نزدیکترین پاسخ پیدا میشود؟
حالا که شاخص داریم، باید بتوانیم برای هر پرسش نزدیکترین قطعهها را پیدا کنیم. این کار با معیاری به نام شباهت کسینوسی انجام میشود که به آن جستجوی نزدیکترین همسایه هم میگویند.
منطق ریاضی به زبان ساده
شباهت کسینوسی (Cosine Similarity) کسینوس زاویهی میان دو بردار را در فضای چندبعدی اندازه میگیرد. اگر دو بردار همجهت باشند، عدد به یک نزدیک است. هرچه جهتشان متفاوتتر شود، عدد کوچکتر میشود.
دو نفر را تصور کنید که در یک میدان به سمت مقصدی اشاره میکنند. یکی دستش را کامل دراز کرده و دیگری فقط انگشتش را بالا آورده است. طول اشاره فرق دارد، اما اگر هر دو به یک سمت اشاره کنند، مقصدشان یکی است. شباهت کسینوسی هم فقط «جهت» را میسنجد.
مزیت این معیار این است که به «اندازه»ی متن حساس نیست. یک مقالهی بلند و یک پاراگراف کوتاه دربارهی یک موضوع، ممکن است از نظر فاصلهی معمولی دور باشند. اما زاویهی کوچکی دارند و شباهت کسینوسی بالایی نشان میدهند.
یک موتور جستجوی معنایی در چند خط
روند کار ساده است. پرسش کاربر را به بردار تبدیل کنید، شباهتش را با همهی بردارهای شاخص حساب کنید و نتیجهها را به ترتیب شباهت مرتب کنید. کد زیر همین روند را روی چند جملهی نمونه اجرا میکند. پیش از اجرا pip install openai numpy را بزنید و کلید را در OPENAI_API_KEY بگذارید:
import numpy as np
from openai import OpenAI
client = OpenAI()
docs = ["آموزش نصب پایتون در ویندوز", "راهنمای کاهش هزینهی سرور", "مقدمهای بر یادگیری ماشین"]
def embed(texts):
result = client.embeddings.create(model="text-embedding-3-small", input=texts)
return np.array([item.embedding for item in result.data])
index = embed(docs)
query = embed(["چطور python را روی کامپیوترم راه بیندازم؟"])[0]
scores = index @ query / (np.linalg.norm(index, axis=1) * np.linalg.norm(query))
for i in scores.argsort()[::-1]:
print(f"{scores[i]:.3f} {docs[i]}")در این مثال انتظار داریم سند اول بالاترین امتیاز را بگیرد؛ با اینکه پرسش حتی کلمهی «نصب» را ندارد. به نظر شما سند دوم یا سوم کدام امتیاز بالاتری میگیرد؟ کد را اجرا کنید و حدستان را بسنجید. در پروژهی واقعی، شاخص را یک بار میسازید و ذخیره میکنید و فقط پرسش را در هر جستجو به بردار تبدیل میکنید.
نکتههای جستجوی معنایی برای متن فارسی
متن فارسی چند چالش خاص دارد که روی کیفیت جستجو اثر میگذارد. مهمترینش یکدستنبودن نوشتار است. یک کلمه ممکن است با «ی» و «ک» عربی یا فارسی، با نیمفاصله یا فاصله نوشته شود.
بنابراین قبل از ساخت بردار، متن را یکدست کنید. تابع سادهی زیر حروف عربی را به فارسی تبدیل میکند و فاصلههای اضافه را حذف میکند. برای یکدستسازی کاملتر، مثل اصلاح نیمفاصلهها، کتابخانهی فارسی hazm ابزار آماده دارد:
import re

def normalize_fa(text):
    text = text.replace("ي", "ی").replace("ك", "ک")
    return re.sub(r"\s+", " ", text).strip()

print(normalize_fa("آموزش  پايتون  و يادگيري ماشين"))  # آموزش پایتون و یادگیری ماشین
همچنین از مدل Embedding چندزبانه استفاده کنید و کیفیت نتیجه را با چند پرسش واقعی فارسی بسنجید. جدول زیر خلاصهی تصمیمهای اصلی را نشان میدهد.
| تصمیم | گزینهی پیشنهادی | دلیل |
|---|---|---|
| یکدستسازی متن | تبدیل ی و ک عربی، اصلاح نیمفاصله | بردار یکسان برای کلمهی یکسان |
| اندازهی قطعه | یک پاراگراف یا یک زیرعنوان | معنای روشن و زمینهی کافی |
| همپوشانی | یک یا دو جمله | جلوگیری از بریدن جملههای مرزی |
| محل ذخیره | JSON برای شروع، پایگاه برداری برای مقیاس بالا | سادگی در آغاز، سرعت در ادامه |
تمرین عملی؛ جستجو در فهرست دورهها
برای پروژهی مشترک مجموعه، کد بالا را روی فهرست دورههای آموزشی اجرا کنید. بهجای سه جملهی نمونه، توضیح ده دوره را در فهرست docs بگذارید. بعد این پرسشها را امتحان کنید:
- «برای شروع برنامهنویسی چه دورهای خوب است؟»
- «میخواهم دادهها را نمودار کنم.»
- «دورهای برای ساخت سایت دارید؟»
بررسی کنید آیا دورهی درست در صدر نتایج قرار میگیرد. اگر نه، توضیح دورهها را کاملتر کنید یا قطعهبندی را تغییر دهید و دوباره بسنجید.
سخن پایانی
جستجوی معنایی فاصلهی میان «آنچه کاربر تایپ میکند» و «آنچه واقعاً میخواهد» را کم میکند. به طور خلاصه، Embedding معنا را به عدد تبدیل میکند و شاخص برداری این عددها را نگه میدارد. سپس شباهت کسینوسی نزدیکترین پاسخ را پیدا میکند. با یک فایل JSON و چند خط پایتون میتوانید همین امروز اولین نمونه را بسازید.
در قسمت ششم همین جستجو را به مدل زبانی وصل میکنیم تا دستیار از روی اسناد شما پاسخ بدهد؛ روشی که به آن RAG میگویند.
این آموزش بر پایهی درس Building Search Applications از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
برای مطالعه بیشتر
برای دنبال کردن عمیقتر این بحث، منابع زیر را به ترتیب از ساده به تخصصی بخوانید.
- ساخت چتبات هوش مصنوعی با پایتون: قسمت چهارم همین مجموعه؛ حلقهی گفتوگویی که پرسش کاربر را به جستجو میرساند؛ برای مبتدی تا متوسط.
- Building Search Applications (انگلیسی): درس اصلی مایکروسافت با نوتبوک کامل جستجو در ویدئوها؛ برای مبتدی.
- Embeddings در مستندات OpenAI (انگلیسی): مدلهای Embedding، ابعاد بردار و کاربردهای جستجو و دستهبندی؛ برای متوسط.
- Cosine similarity در ویکیپدیا (انگلیسی): فرمول و ویژگیهای ریاضی شباهت کسینوسی؛ برای متوسط.
- Sentence Transformers (انگلیسی): کتابخانهی متنباز ساخت Embedding روی سیستم خودتان، با مدلهای چندزبانه؛ برای متوسط تا پیشرفته.
پرسشهای پرتکرار
فرق جستجوی معنایی با جستجوی کلمهای چیست؟
جستجوی کلمهای دنبال همان کلمههایی میگردد که کاربر تایپ کرده است. جستجوی معنایی منظور پرسش را به بردار عددی تبدیل میکند و متنهایی را برمیگرداند که از نظر معنا نزدیکاند، حتی اگر کلمهی مشترکی نداشته باشند.
Embedding به زبان ساده چیست؟
فهرستی از صدها یا هزاران عدد که معنای یک متن را نشان میدهد. متنهایی که معنای نزدیکی دارند، بردارهای نزدیکی دارند؛ به همین دلیل میتوان شباهت معنایی را با محاسبهی ریاضی سنجید.
آیا جستجوی معنایی برای متن فارسی کار میکند؟
بله، به شرطی که از مدل Embedding چندزبانه استفاده کنید. پیش از ساخت بردار، متن فارسی را یکدست کنید؛ مثلاً ی و ک عربی را به فارسی تبدیل کنید و نیمفاصلهها را اصلاح کنید.
برای ذخیرهی بردارها حتماً پایگاه داده برداری لازم است؟
برای چند هزار قطعه متن، یک فایل JSON یا یک جدول معمولی کافی است. وقتی حجم داده بالا میرود و سرعت اهمیت پیدا میکند، پایگاه داده برداری مثل Pinecone، Weaviate یا Redis انتخاب بهتری است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.