
مدل زبانی کوچک پاسخی به یک پرسش ساده است: آیا برای هر کاری به بزرگترین مدل موجود نیاز داریم؟ برای دستهبندی یک پیام پشتیبانی یا استخراج چند فیلد از یک فرم، معمولاً نه. مدل کوچک میتواند سریعتر، ارزانتر و حتی روی کامپیوتر خود شما کار کند.
در این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز، مدلهای زبانی کوچک را میشناسیم و با خانوادهی Phi مایکروسافت بهعنوان نمونه آشنا میشویم. بعد روشهای اجرای آنها را مرور میکنیم و در پایان آزمونی طراحی میکنیم که نشان دهد مدل کوچک برای کار ما کافی است یا نه. شرطش ساده است: وظیفهی روشن و ارزیابی واقعی.
مدل زبانی کوچک چیست؟
مدل زبانی کوچک (SLM) نسخهی کوچکشدهی مدل زبانی بزرگ است. همان اصول و تکنیکهای معماری را به کار میبرد، اما به محاسبات بسیار کمتری نیاز دارد. این مدلها برای تولید متن شبیه انسان طراحی شدهاند و کارهایی مثل تولید و تکمیل متن، ترجمه و خلاصهسازی را انجام میدهند.
البته این فشردگی بیهزینه نیست. مدل کوچک در عمق فهم و گسترهی دانش از مدل بزرگ عقبتر است. اما برای بسیاری از کارهای مشخص، همین توانایی کافی است و مزیتهای سرعت و هزینه تعیینکننده میشوند.
مدل کوچک چطور ساخته میشود؟
فرایند ساخت مدل کوچک شبیه مدل بزرگ است. دادهی متنی زیادی از منابع مختلف جمعآوری میشود. داده پاکسازی و مرتب میشود. مدل با الگوریتمهای یادگیری ماشین آموزش میبیند و در پایان برای کارهای خاص تنظیم دقیق میشود.
دلیل اصلی رشد این مدلها، نیاز به اجرای هوش مصنوعی در محیطهایی با منابع محدود است؛ مثل تلفن همراه، دستگاههای لبهی شبکه و سرورهای ارزان. جایی که مدل بزرگ یا اصلاً اجرا نمیشود یا هزینهاش توجیه ندارد.
تفاوت مدل زبانی کوچک و بزرگ
مدلهای کوچک و بزرگ بر پایهی اصول مشترک یادگیری ماشین ساخته شدهاند و روشهای مشابهی در معماری، آموزش و ارزیابی دارند. اما در چند جنبهی کلیدی تفاوت چشمگیری دارند.
اندازه، فهم و محاسبات
تفاوت اصلی در مقیاس است. مدلهای بزرگ صدها میلیارد پارامتر یا بیشتر دارند، در حالی که مدلهای کوچکی مثل Mistral 7B حدود هفت میلیارد پارامتر دارند. این تفاوت اندازه روی همهچیز اثر میگذارد.
مدلهای کوچک معمولاً برای حوزههای خاص بهینه میشوند. در همان حوزه عالیاند، اما فهم گستردهی میانحوزهای ندارند. آموزش و استقرار مدل بزرگ هم به خوشههای عظیم GPU نیاز دارد؛ در حالی که مدل کوچک روی یک کارت گرافیک معمولی یا حتی پردازندهی لپتاپ اجرا میشود.
سوگیری و سرعت استنتاج
سوگیری در مدلهای بزرگ مشکل شناختهشدهای است، چون بیشتر روی دادهی خام اینترنت آموزش میبینند. مدلهای کوچک که روی دادهی محدودتر و خاصتر آموزش دیدهاند، ممکن است سوگیری کمتری داشته باشند؛ هرچند هیچ مدلی کاملاً از آن خالی نیست.
اندازهی کوچکتر مزیت بزرگی در سرعت استنتاج هم دارد. مدل کوچک روی سختافزار محلی و بدون پردازش موازی گسترده، خروجی تولید میکند. جدول زیر تفاوتها را خلاصه میکند.
| جنبه | مدل زبانی بزرگ | مدل زبانی کوچک |
|---|---|---|
| تعداد پارامتر | صدها میلیارد یا بیشتر | چند میلیارد |
| گسترهی فهم | وسیع و میانحوزهای | متمرکز بر حوزههای مشخص |
| سختافزار لازم | خوشهی GPU یا سرویس ابری | لپتاپ، تلفن یا یک GPU |
| سرعت پاسخ | کندتر و وابسته به شبکه | سریع و قابل اجرای محلی |
| هزینهی هر درخواست | بالاتر | بسیار پایینتر |
| مناسب برای | استدلال پیچیده و کارهای باز | کارهای محدود و تکراری |
خانوادهی Phi؛ نمونهای از مدلهای کوچک
مایکروسافت خانوادهای از مدلهای کوچک به نام Phi منتشر کرده که نمونهی خوبی برای آشنایی با این دسته است. نسلهای Phi-3 و Phi-3.5 سه شاخه دارند: مدلهای متنی، مدلهای بینایی و مدل ترکیب خبرگان.
مدلهای متنی Phi
Phi-3-mini با ۳٫۸ میلیارد پارامتر برای تولید متن، چت و استخراج اطلاعات ساخته شده است. Phi-3-small با هفت میلیارد و Phi-3-medium با چهارده میلیارد پارامتر همین مسیر را ادامه میدهند و در آزمونهای منتشرشده با مدلهایی چند برابر بزرگتر رقابت میکنند.
Phi-3.5-mini نسخهی ارتقایافتهی Phi-3-mini است. تعداد پارامترها تغییر نکرده، اما پشتیبانی چندزبانهاش به بیش از بیست زبان رسیده است. برای کار با فارسی، همیشه مدل را با دادهی خودتان آزمایش کنید؛ کیفیت پشتیبانی زبان در مدلهای کوچک بسیار متفاوت است.
بینایی و ترکیب خبرگان
Phi-3-vision با ۴٫۲ میلیارد پارامتر به مدل «چشم» میدهد. در استدلال تصویری، خواندن متن از تصویر و فهم جدول و نمودار خوب عمل میکند. Phi-3.5-vision پشتیبانی از چند تصویر و ورودی چندفریمی را هم اضافه کرده است.
Phi-3.5-MoE از معماری ترکیب خبرگان (Mixture of Experts) استفاده میکند. این مدل شانزده ماژول خبره دارد، اما در هر لحظه فقط حدود ۶٫۶ میلیارد پارامتر فعال است. نتیجه کیفیتی نزدیک به مدلهای بزرگتر با هزینهی محاسباتی کمتر است.
روشهای اجرای مدل زبانی کوچک
مزیت بزرگ مدلهای کوچک، انعطاف در محل اجراست. میتوانید آنها را از طریق سرویس ابری صدا بزنید یا کاملاً روی سختافزار خودتان اجرا کنید.
اجرا در فضای ابری
سادهترین راه، فهرست مدلهای Microsoft Foundry است. مدل Phi را از فهرست انتخاب میکنید و با SDK استاندارد صدایش میزنید. NVIDIA NIM هم گزینهی دیگری است که مدلها را با موتورهای بهینهشدهی NVIDIA، مقیاسپذیری خودکار روی Kubernetes و رابطهای استاندارد ارائه میدهد.
اجرای ابری وقتی مناسب است که نمیخواهید سختافزار مدیریت کنید، اما هزینهی کمتر و سرعت بیشتر مدل کوچک را میخواهید.
اجرای محلی با Ollama و Foundry Local
Ollama سادهترین راه اجرای مدل روی کامپیوتر خودتان است. پس از نصب، یک دستور کافی است:
ollama run phi3.5Ollama یک رابط سازگار با OpenAI هم روی کامپیوتر شما باز میکند. پس همان کدی که با سرویسهای ابری نوشتهاید، با تغییر آدرس به مدل محلی وصل میشود.
Foundry Local مایکروسافت هم مدلهایی مثل Phi را کاملاً آفلاین و بدون اشتراک ابری روی سختافزار شما اجرا میکند. در ویندوز با winget install Microsoft.FoundryLocal نصب میشود و با foundry model run phi-3.5-mini مدل را اجرا میکند.
Transformers و ONNX Runtime
کتابخانهی Transformers در Hugging Face رایجترین راه کار با مدلهای وزنباز است. هزاران مدل آموزشدیده دارد و از PyTorch، TensorFlow و JAX پشتیبانی میکند. فقط برای سرعت مناسب معمولاً به GPU نیاز دارد، بهخصوص برای مدلهای بینایی.
ONNX Runtime GenAI گزینهی دیگری است که مدلها را روی ویندوز، لینوکس، مک، اندروید و iOS با بهینهسازی برای سختافزارهای مختلف اجرا میکند. برای اجرا روی دستگاههای کاربر و برنامههای موبایل گزینهی مناسبی است.
آزمون عملی؛ دستهبندی پیامهای پشتیبانی
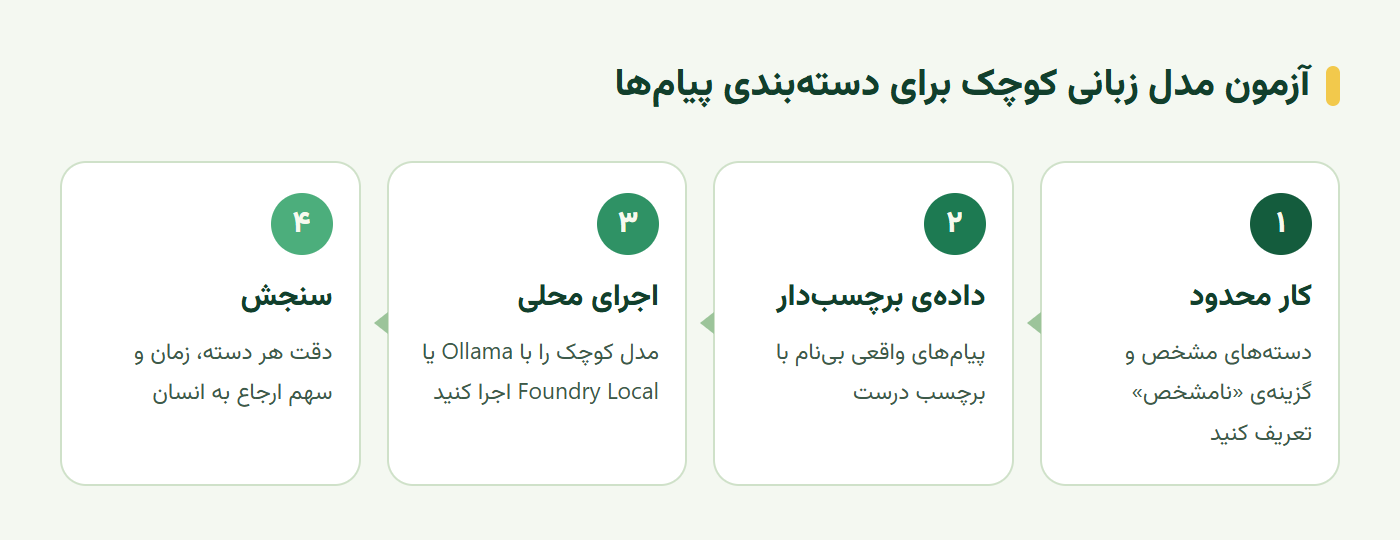
حالا مهمترین پرسش را جواب میدهیم: آیا مدل کوچک برای کار ما کافی است؟ سناریو این است: پیامهای پشتیبانی یک مجموعهی آموزشی باید به سه دستهی ثبتنام، دسترسی و محتوای دوره تقسیم شوند. نمودار زیر چهار قدم آزمون را نشان میدهد.
کد دستهبندی با مدل محلی
کد زیر یک پیام را با مدل کوچکی که با Ollama اجرا شده دستهبندی میکند. به دستهی «نامشخص» دقت کنید؛ مهمترین بخش طراحی است:
from openai import OpenAI
client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")
LABELS = ["ثبتنام", "دسترسی", "محتوای دوره", "نامشخص"]
def classify(message: str) -> str:
prompt = (
f"پیام زیر را فقط در یکی از این دستهها قرار بده: {'، '.join(LABELS)}. "
"اگر مطمئن نیستی، بنویس «نامشخص». فقط نام دسته را بنویس.\n\n"
f"پیام: {message}"
)
reply = client.chat.completions.create(model="phi3.5", messages=[{"role": "user", "content": prompt}])
label = reply.choices[0].message.content.strip()
return label if label in LABELS else "نامشخص"خط آخر هم یک محافظ ساده است. اگر مدل چیزی خارج از فهرست برگرداند، پیام بهجای برچسب اشتباه، «نامشخص» میشود و به انسان ارجاع میگیرد.
ورودی و معیار پذیرش
ورودی آزمون پیامهای واقعی کاربران است که نام و اطلاعات شخصیشان حذف شده و برچسب درست دارند. یک نمونهی عادی و یک نمونهی مبهم، مثلاً «سلام، مشکل دارم»، هم بگذارید.
سه معیار را بسنجید: دقت هر دسته بهطور جداگانه، زمان اجرا و سهم پیامهایی که به انسان ارجاع میشوند. دقت کلی کافی نیست؛ ممکن است مدل دستهی ثبتنام را عالی و دستهی دسترسی را ضعیف تشخیص دهد.
نمونهی شکست؛ برچسب تحمیلی
شکستی که باید عمداً دنبالش بگردید این است: مدل بهجای اعلام تردید، یکی از برچسبها را به پیام مبهم تحمیل کند. پیامی مثل «کار نمیکند» ممکن است به هر سه دسته مربوط باشد. مدلی که با اطمینان آن را «دسترسی» بنامد، کاربر را به مسیر اشتباه میفرستد.
مدلهای کوچک به این خطا حساسترند. به همین دلیل گزینهی «نامشخص» و محافظ خروجی ضروریاند. اگر سهم ارجاع به انسان خیلی بالا شد، یعنی مدل برای این کار کافی نیست یا به چند مثال بیشتر در پرامپت نیاز دارد.
تمرین عملی؛ نقشهی وظایف مدل کوچک
خروجی این تمرین نقشهای است که نشان میدهد مدل کوچک برای کدام وظایف کافی است:
- پنج وظیفهی تکراری دستیارتان را فهرست کنید؛ مثل دستهبندی، استخراج فیلد یا خلاصهی کوتاه.
- هر وظیفه را با یک مدل کوچک محلی و یک مدل بزرگ ابری روی بیست نمونهی واقعی اجرا کنید.
- برای هر وظیفه دقت، زمان و هزینه را ثبت کنید و بنویسید مدل کوچک کافی است یا نه.
مشخص کنید کدام بخش را واقعاً اجرا کردهاید و کدام هنوز فرض است. معمولاً نتیجه ترکیبی است؛ مدل کوچک برای کارهای ساده و مدل بزرگ برای استدلال پیچیده.
سخن پایانی
مدل زبانی کوچک برای هر کاری مناسب نیست، اما برای بسیاری از کارهای محدود و تکراری، گزینهای سریع، ارزان و قابل اجرای محلی است. خانوادهی Phi نشان میدهد مدلهای چند میلیارد پارامتری در حوزههای مشخص با مدلهای بسیار بزرگتر رقابت میکنند. کلید موفقیت همان است که در کل این مجموعه تکرار کردهایم: وظیفه را روشن تعریف کنید، گزینهی تردید بگذارید و با دادهی واقعی خودتان بسنجید.
در قسمت بعد انتخاب مدل وزنباز را بررسی میکنیم؛ از مجوز استفاده تا توان اجرا و سازگاری با ابزارها.
این آموزش بر پایهی درس Introduction to Small Language Models از مجموعهی آزاد Generative AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
مدل زبانی کوچک چیست؟
نسخهای کوچکتر از مدلهای زبانی بزرگ با چند میلیارد پارامتر که همان اصول معماری را دارد اما به محاسبات بسیار کمتری نیاز دارد و میتواند روی لپتاپ، تلفن همراه یا سرور ارزان اجرا شود.
مدل زبانی کوچک برای چه کارهایی مناسب است؟
کارهای محدود و مشخص مثل دستهبندی پیام، استخراج فیلد، خلاصهسازی کوتاه و پاسخ در یک حوزهی خاص؛ بهخصوص وقتی زمان پاسخ کم، هزینهی پایین یا پردازش روی دستگاه خود کاربر اهمیت دارد.
چطور یک مدل کوچک را روی کامپیوتر خودم اجرا کنم؟
سادهترین راه Ollama است؛ پس از نصب، دستور ollama run phi3.5 مدل را دانلود و اجرا میکند. Foundry Local مایکروسافت و ONNX Runtime GenAI هم گزینههای دیگرند.
آیا مدل کوچک زبان فارسی را خوب میفهمد؟
پشتیبانی چندزبانه در مدلهای کوچک محدودتر است و از مدلی به مدل دیگر فرق دارد. پیش از انتخاب، مدل را حتماً با پیامهای واقعی فارسی کاربران خودتان آزمایش کنید.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.