
چرخه عمر علم داده جواب این سؤال است: یک پروژهی داده از کجا شروع میشود و کی تمام میشود؟ بسیاری از پروژهها با یک فایل داده و یک ایدهی مبهم شروع میشوند. چند هفته بعد، مدلی ساخته شده که هیچکس نمیداند با آن چه کند. چرخهی عمر جلوی این اتفاق را میگیرد.
در قسمتهای قبل با علم داده، انواع داده، آمار و انصاف آشنا شدیم. حالا همه را در یک چارچوب کنار هم میگذاریم. در این قسمت پنج مرحلهی چرخهی عمر را با سؤالهای کلیدی هرکدام مرور میکنیم. بعد دو چارچوب مشهور TDSP و CRISP-DM را مقایسه میکنیم و در پایان پروفایل داده را با pandas تمرین میکنیم.
چرخه عمر علم داده چیست؟
علم داده یک فرایند است، نه یک ابزار. این فرایند را میشود به پنج مرحله تقسیم کرد؛ جمعآوری، پردازش، تحلیل، ارتباط و نگهداری. این مراحل خطی نیستند. در هر مرحله ممکن است چیزی کشف کنید که شما را به مرحلهی قبل برگرداند.
به همین دلیل به آن چرخه میگویند. مثلاً در تحلیل متوجه میشوید داده برای یک گروه کافی نیست. پس به جمعآوری برمیگردید. یا در ارتباط با مدیر معلوم میشود سؤال اولیه درست تعریف نشده بود. پس هدف را بازتعریف میکنید.
پنج مرحله در یک نگاه
هر مرحله هدف و خروجی مشخصی دارد:
- جمعآوری: تعریف هدف پروژه و به دست آوردن دادهی لازم.
- پردازش: پاکسازی، کشف الگو و مدلسازی.
- تحلیل: بررسی دقیق داده و آزمودن فرضیهها.
- ارتباط: رساندن نتیجه به تصمیمگیرندگان به زبان قابل فهم.
- نگهداری: ذخیره، امنیت و بهروزرسانی داده و مدل در طول زمان.
در ادامه، مهمترین مراحل را باز میکنیم. ارتباط نتیجه را در قسمت جداگانهای با جزئیات بیشتر میبینیم.
مرحله جمعآوری؛ هدف پیش از داده
اولین مرحله از همه مهمتر است، چون بقیهی مراحل به آن وابستهاند. این مرحله دو کار را در خود دارد؛ تعریف هدف پروژه و به دست آوردن داده. ترتیب این دو هم مهم است. اول هدف، بعد داده.
سؤالهایی دربارهی هدف پروژه
تعریف هدف به فهم عمیق مسئله نیاز دارد. اول باید افرادی را پیدا کنید که واقعاً این مشکل را دارند. بعد باید بفهمید ارزش و نیاز آنها چیست. سؤالهایی که در این مرحله باید پرسید:
- سابقه: آیا این مسئله قبلاً بررسی شده و چه نتیجهای داشته است؟
- وضوح: آیا هدف برای همهی افراد درگیر روشن است؟
- ابهام: کجای مسئله مبهم است و چطور میشود آن را کم کرد؟
- منابع: چقدر زمان، نیرو و توان محاسباتی در دسترس است؟
اگر پاسخ یکی از این سؤالها روشن نیست، هنوز برای جمعآوری داده زود است. پاسخها را مکتوب کنید و با ذینفعان تأیید بگیرید.
سؤالهایی دربارهی داده
بعد از روشن شدن هدف، نوبت داده است. داده ممکن است از قبل در سازمان باشد یا باید جمعآوری شود. در هر حالت، پیش از شروع کار این سؤالها را بپرسید؛ مالک داده کیست و آیا اجازهی استفاده داریم؟ نگرانی حریم خصوصی چیست؟ آیا داده برای این مسئله کافی است؟
سؤال آخر از همه ظریفتر است. اگر در داده چیز تازهای کشف کنید، آیا باید هدف را تغییر دهید؟ پاسخ گاهی مثبت است. اما این تغییر باید آگاهانه و با ذینفعان باشد. نباید بیصدا هدف را با نتیجه جور کنید.
مرحله پردازش و تحلیل؛ از داده خام به الگو
مرحلهی پردازش روی کشف الگو و مدلسازی تمرکز دارد. بعضی تکنیکهای این مرحله مثل پاکسازی و آمادهسازی داده را در قسمتهای قبل دیدیم. تکنیکهای مدلسازی مثل دستهبندی، خوشهبندی و رگرسیون را هم در ادامهی این مجموعه یکییکی میبینیم.
تحلیل اکتشافی؛ آشنایی با داده
تحلیل اکتشافی داده فرایند آشنایی با داده است. پیش از هر مدلسازی، باید بدانید داده چه شکلی دارد، کجا خالی است و چه چیز عجیبی در آن هست. این مرحله به سؤالهایی جواب میدهد که در جمعآوری پرسیده بودید؛ مثل کافی بودن داده و کیفیت آن.
پروفایلسازی داده ابزار اصلی این مرحله است. پروفایل خلاصهای آماری از هر ستون است؛ تعداد، میانگین، کمینه، بیشینه و تعداد مقادیر خالی. در pandas تابع describe() این خلاصه را در یک خط میدهد.
نمونهگیری و پرسوجو
بررسی همهی ردیفهای یک مجموعهدادهی بزرگ زمانبر است. اما نگاه کردن به چند نمونهی تصادفی چیزهایی نشان میدهد که آمار خلاصه پنهان میکند. مثلاً متنهایی که به زبان دیگری نوشته شدهاند یا تاریخهایی با قالب اشتباه.
پرسوجو هم برای آزمودن فرضیههای مشخص کاربرد دارد. برخلاف نمونهگیری، پرسوجو دقیقاً ردیفهایی را برمیگرداند که شرط شما را دارند. کد زیر هر سه ابزار را نشان میدهد:
import pandas as pd
df = pd.read_csv("support_tickets.csv", parse_dates=["created_at"])
print(df.describe(include="all").T) # پروفایل همهی ستونها
print(df.isna().mean().sort_values()) # نسبت مقادیر خالی هر ستون
print(df.sample(5, random_state=1)) # پنج ردیف تصادفی برای نگاه چشمی
print(df.query("topic == 'payment' and response_hours > 48").shape)بیشتر بخوانید: پیش از مدلسازی، ارزیابی تفکیکی را در سوگیری در هوش مصنوعی ببینید تا میانگین خوب، ضعف یک گروه را پنهان نکند.
مرحله نگهداری؛ کاری که هیچوقت تمام نمیشود
در نمودار چرخهی عمر، نگهداری بین جمعآوری و پردازش قرار دارد. نگهداری یک فرایند مداوم برای مدیریت، ذخیره و ایمنسازی داده در طول پروژه است. در تمام عمر پروژه باید به آن توجه کرد.
ذخیرهسازی؛ محل و دمای داده
محل ذخیرهی داده روی هزینه و سرعت دسترسی اثر مستقیم دارد. این تصمیم معمولاً فقط با دانشمند داده گرفته نمیشود، اما او باید پیامدهایش را بداند. داده میتواند روی سرور خود سازمان، ابر عمومی یا ابر خصوصی باشد. هرکدام از نظر هزینه، کنترل و مقررات تفاوت دارد.
مفهوم مهم دیگر دمای داده است. دادهی گرم مرتب و سریع استفاده میشود و روی ذخیرهسازی سریعتر و گرانتر میماند. دادهی سرد بهندرت لازم است و میشود آن را ارزان بایگانی کرد. مثلاً لاگ پرسشهای سال گذشتهی دستیار احتمالاً دادهی سرد است، اما برای آموزش دوبارهی مدل ارزشمند است.
امنیت و مدیریت دسترسی
هدف اصلی ایمنسازی داده این است که کنترل کامل روی داده جمعشده و نحوهی استفاده از آن داشته باشیم. چند کار پایهای در هر پروژه لازم است. همهی داده رمزگذاری شود. به کاربران گفته شود دادهشان چطور استفاده میشود.
دسترسی افرادی که پروژه را ترک کردهاند حذف شود. فقط افراد مشخصی اجازهی تغییر داده را داشته باشند. این کارها سادهاند، اما در بسیاری از نشتهای داده دقیقاً همینها رعایت نشده بود.
TDSP و CRISP-DM؛ دو چارچوب رایج
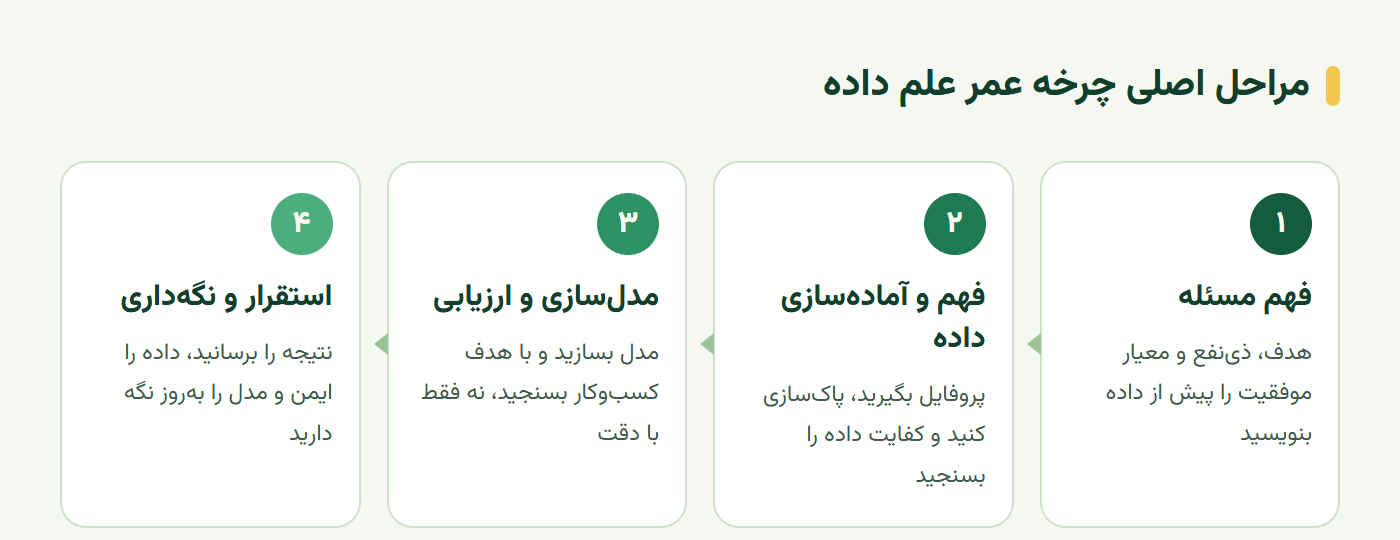
چرخهی عمر علم داده نسخههای مختلفی دارد. نام و تعداد مراحل ممکن است فرق کند، اما فرایند اصلی یکی است. دو چارچوب مشهور TDSP از مایکروسافت و CRISP-DM بهعنوان استاندارد صنعتیاند. نمودار زیر مراحل اصلی چرخه را نشان میدهد.
CRISP-DM؛ شش مرحله با رفتوبرگشت
CRISP-DM شش مرحله دارد؛ فهم کسبوکار، فهم داده، آمادهسازی داده، مدلسازی، ارزیابی و استقرار. ویژگی مهمش پیکانهای برگشتی بین مراحل است. مثلاً از مدلسازی به آمادهسازی داده برمیگردید، یا از ارزیابی به فهم کسبوکار.
نکتهی کلیدی CRISP-DM این است که ارزیابی را با هدف کسبوکار انجام میدهد، نه فقط با معیار فنی. مدلی با دقت ۹۵ درصد که مشکل واقعی کاربر را حل نکند، در این چارچوب مردود است. این نگاه دقیقاً همان چیزی است که از قسمت اول تأکید کردیم.
TDSP؛ مراحل بهعلاوهی نقشها
TDSP مراحل مشابهی دارد؛ فهم کسبوکار، دریافت و فهم داده، مدلسازی، استقرار و پذیرش مشتری. تفاوت اصلیاش در تعریف نقشها و وظایف تیمی است. مشخص میکند چه کسی مسئول چه کاری است و چه مستنداتی باید تولید شود.
برای تیمهای کوچک، CRISP-DM معمولاً کافی و سادهتر است. برای سازمانهای بزرگ با چند نقش مجزا، ساختار TDSP کمک میکند کار بین افراد گم نشود. مهم این است که یک چارچوب را انتخاب کنید و به آن پایبند بمانید.
تمرین عملی؛ کارت چرخه عمر پروژه
برای پروژهای که از قسمت اول طراحی کردهاید، یک کارت یکصفحهای با این بخشها بنویسید:
- هدف و ذینفع: چه کسی این مشکل را دارد و موفقیت برای او چه شکلی است؟
- داده و مالکیت: داده از کجا میآید، مالکش کیست و چه محدودیت حریم خصوصی دارد؟
- پروفایل داده: خروجی
describe()و نسبت مقادیر خالی را ضمیمه کنید. - ذخیرهسازی: کدام داده گرم و کدام سرد است؟
- دسترسی: چه کسی داده را میخواند و چه کسی تغییر میدهد؟
- نقطهی برگشت: در چه شرایطی به مرحلهی قبل برمیگردید؟
این کارت را در مخزن پروژه نگه دارید و با هر تغییر مهم بهروزش کنید.
سخن پایانی
چرخه عمر علم داده پنج مرحلهی جمعآوری، پردازش، تحلیل، ارتباط و نگهداری دارد. این مراحل چرخهاند، نه خط مستقیم. هدف پیش از داده تعریف میشود و نگهداری هیچوقت تمام نمیشود.
چارچوبهایی مثل CRISP-DM و TDSP همین مسیر را با جزئیات بیشتری مستند کردهاند. انتخاب بین آنها کمتر مهم است. مهم این است که پروژهی شما مسیر مشخصی داشته باشد و نتیجهاش به تصمیمی قابل دفاع برسد.
این آموزش بر پایهی درسهای Introduction to the Data Science Lifecycle و Analyzing از مجموعهی آزاد Data Science for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
چرخه عمر علم داده چیست؟
چرخه عمر علم داده مجموعهای از مراحل تکرارشونده است که یک پروژهی داده از تعریف مسئله تا استفاده و نگهداری نتیجه طی میکند. رایجترین تقسیمبندی پنج مرحله دارد؛ جمعآوری، پردازش، تحلیل، ارتباط و نگهداری.
CRISP-DM چیست؟
CRISP-DM یک استاندارد صنعتی برای پروژههای دادهکاوی است که شش مرحله دارد؛ فهم کسبوکار، فهم داده، آمادهسازی داده، مدلسازی، ارزیابی و استقرار. ویژگی مهمش این است که بین مراحل رفتوبرگشت دارد و ارزیابی را به هدف کسبوکار گره میزند.
تفاوت TDSP و CRISP-DM چیست؟
هر دو همان مراحل اصلی را دارند. CRISP-DM قدیمیتر و مستقل از ابزار است و روی مراحل تمرکز دارد. TDSP را مایکروسافت ارائه کرده و علاوه بر مراحل، نقشها، وظایف، ساختار مخزن و مستندات تیمی را هم تعریف میکند.
داده سرد و داده گرم چه فرقی دارند؟
داده گرم دادهای است که مرتب و سریع به آن نیاز دارید و روی ذخیرهسازی سریعتر و گرانتر نگه داشته میشود. داده سرد بهندرت استفاده میشود و روی ذخیرهسازی ارزانتر بایگانی میشود. انتخاب درست بین این دو هزینه را بسیار کم میکند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.