
آمار و احتمال دو شاخهی مرتبط از ریاضیاتاند که بدون آنها نمیشود دربارهی داده حرف دقیقی زد. میشود بدون ریاضیات عمیق با داده کار کرد، اما دانستن مفاهیم پایه جلوی بسیاری از نتیجهگیریهای اشتباه را میگیرد. مثلاً این جمله را در نظر بگیرید: «مدل جدید دو درصد دقیقتر است.» آیا این تفاوت واقعی است یا فقط شانس؟
در قسمت قبل دیدیم شبکهی عصبی با وزنهای تصادفی شروع میکند و با خطا یاد میگیرد. در این قسمت ابزارهایی را یاد میگیریم که برای فهم داده و گزارش درست نتیجه لازماند. از احتمال شروع میکنیم و به بازهی اطمینان میرسیم که در ارزیابی مدل کاربرد مستقیم دارد.
احتمال و متغیر تصادفی
احتمال عددی بین صفر و یک است که نشان میدهد یک رویداد چقدر محتمل است. در سادهترین حالت، احتمال برابر تعداد حالتهای مطلوب تقسیم بر تعداد کل حالتهاست، به شرط اینکه همهی حالتها همشانس باشند. مثلاً احتمال آمدن عدد زوج در تاس برابر سه تقسیم بر شش، یعنی نیم است.
وقتی دربارهی رویدادها حرف میزنیم، از متغیر تصادفی استفاده میکنیم. مثلاً متغیر تصادفی X عدد تاس را نشان میدهد و مقداری بین یک تا شش میگیرد. به مجموعهی این مقادیر فضای نمونه میگویند.
متغیر گسسته و پیوسته
متغیر تاس گسسته است، چون مقادیرش جدا از هم و قابل شمارشاند. اما متغیرهایی هم هستند که هر مقداری در یک بازه میگیرند؛ مثل زمان رسیدن اتوبوس. به اینها متغیر پیوسته میگویند.
در متغیر پیوسته، احتمال هر مقدار دقیق عملاً صفر است. احتمال اینکه اتوبوس دقیقاً ساعت ۱۰:۰۰:۰۰٫۰۰۰ برسد صفر است، اما اتوبوس بالاخره در لحظهای میرسد. پس برای متغیر پیوسته دربارهی احتمال قرار گرفتن در یک بازه حرف میزنیم؛ مثلاً بین ۱۰:۰۰ و ۱۰:۰۵.
توزیع احتمال؛ یکنواخت و نرمال
توزیع احتمال نشان میدهد احتمال بین مقادیر مختلف چطور پخش شده است. سادهترین توزیع، توزیع یکنواخت است. در این توزیع همهی مقادیر همشانساند؛ مثل تاس سالم که هر وجه احتمال یکششم دارد.
مهمترین توزیع در عمل اما توزیع نرمال است. در این توزیع بیشتر مقادیر حول میانگین جمع میشوند و هرچه دورتر شویم، کمتر میشوند. شکلش شبیه زنگوله است. قد و وزن انسانها، خطای اندازهگیری و بسیاری از پدیدههای طبیعی تقریباً از این توزیع پیروی میکنند.
خلاصه کردن داده؛ میانگین، واریانس و انحراف معیار
وقتی صدها یا هزاران عدد داریم، نمیتوانیم همه را یکییکی نگاه کنیم. به چند عدد خلاصه نیاز داریم که تصویر کلی داده را بدهند. دو پرسش اصلی این است: مقدار معمول کجاست و داده چقدر پراکنده است؟
میانگین و امید ریاضی
میانگین حسابی حاصل جمع همهی مقادیر تقسیم بر تعدادشان است. اگر نمونهها را از یک توزیع بگیریم و تعدادشان زیاد شود، میانگین به عددی به نام امید ریاضی نزدیک میشود. امید ریاضی مقدار میانگین در بلندمدت است.
برای مثال، امید ریاضی تاس سالم ۳٫۵ است. هیچوقت ۳٫۵ نمیآید، اما اگر هزار بار تاس بیندازید، میانگین نتیجهها به ۳٫۵ نزدیک میشود. این همان چیزی است که قانون اعداد بزرگ میگوید.
واریانس و انحراف معیار
میانگین بهتنهایی کافی نیست. دو کلاس با میانگین نمرهی ۱۵ میتوانند کاملاً متفاوت باشند. در یکی همه نزدیک ۱۵ گرفتهاند و در دیگری نیمی ۲۰ و نیمی ۱۰. واریانس همین پراکندگی را میسنجد.
واریانس میانگین مربع فاصلهی هر مقدار از میانگین است. چون واحدش مربع واحد داده است، معمولاً جذر آن یعنی انحراف معیار را گزارش میکنیم. در توزیع نرمال، حدود ۶۸ درصد داده در فاصلهی یک انحراف معیار از میانگین و حدود ۹۵ درصد در فاصلهی دو انحراف معیار قرار دارد.
بیشتر بخوانید: نقش نرخ یادگیری و وزنهای تصادفی اولیه را در شبکه عصبی چیست؟ با مثال پایتون توضیح دادهایم.
میانه، چارک و داده پرت
گاهی میانگین تصویر درستی از مقدار معمول نمیدهد. وقتی چند مقدار خیلی بزرگ یا کوچک داریم، میانگین به سمت آنها کشیده میشود. حقوق کارمندان یک شرکت کوچک را در نظر بگیرید که مدیرعاملش صد برابر بقیه حقوق میگیرد. میانگین حقوق چیزی دربارهی کارمند معمولی نمیگوید.
میانه، چارکها و مد
میانه مقداری است که نیمی از داده کمتر و نیمی بیشتر از آن است. میانه به دادهی پرت حساس نیست و برای دادهی نامتقارن معیار بهتری است. برای درک بهتر توزیع، از چارکها هم استفاده میکنیم:
- چارک اول (Q1): مقداری که ۲۵ درصد داده کمتر از آن است.
- میانه (Q2): مقداری که ۵۰ درصد داده کمتر از آن است.
- چارک سوم (Q3): مقداری که ۷۵ درصد داده کمتر از آن است.
- مد: پرتکرارترین مقدار که برای دادهی دستهای مثل رنگ یا شهر کاربرد دارد.
فاصلهی چارک سوم و اول را دامنهی میانچارکی یا IQR میگویند. این عدد پراکندگی نیمهی میانی داده را نشان میدهد.
جعبهنمودار و شناسایی داده پرت
جعبهنمودار میانه و چارکها را در یک تصویر نشان میدهد. جعبه از Q1 تا Q3 کشیده میشود و خطی میانه را نشان میدهد. مقادیری که بیرون از بازهی Q1 منهای ۱٫۵ برابر IQR تا Q3 بهعلاوهی ۱٫۵ برابر IQR باشند، دادهی پرت حساب میشوند.
این قاعده برای پاکسازی داده بسیار کاربردی است. اما هر دادهی پرتی خطا نیست. گاهی یک مقدار پرت مهمترین اطلاعات داده است؛ مثل یک تراکنش مشکوک. پیش از حذف، همیشه بررسی کنید چرا آن مقدار پرت است.
داده واقعی؛ از هیستوگرام تا توزیع نرمال
دادهی واقعی معمولاً حاصل آزمایش تصادفی به معنای دقیق نیست. مثلاً وزن بازیکنان یک لیگ بیسبال را در نظر بگیرید. با این حال، فرض میکنیم هر نقطهی داده نمونهای از یک توزیع احتمال است. این فرض به ما اجازه میدهد ابزارهای آمار را روی دادهی واقعی به کار ببریم.
هیستوگرام و شکل توزیع
برای دیدن شکل توزیع، هیستوگرام رسم میکنیم. محور افقی بازههای مقدار و محور عمودی تعداد نمونهها در هر بازه است. در دادهی وزن بازیکنان، بیشتر مقادیر حول یک عدد جمع شدهاند و هرچه دورتر شویم، کمتر میشوند.
این همان شکل زنگولهای توزیع نرمال است. اگر وزن افراد دیگری را بگیریم، میانگین و انحراف معیار فرق میکند، اما شکل احتمالاً همان میماند. به همین دلیل با دانستن میانگین و انحراف معیار، میتوانیم دادهی مصنوعی شبیه دادهی واقعی بسازیم:
import numpy as np

weights = np.array([180, 215, 210, 210, 188, 176, 209, 200, 231, 180,
                    188, 180, 185, 160, 180, 185, 197, 189, 185, 219])
print("mean:", weights.mean(), "median:", np.median(weights), "std:", weights.std(ddof=1).round(2))

q1, q3 = np.percentile(weights, [25, 75])
iqr = q3 - q1
print("outliers:", weights[(weights < q1 - 1.5 * iqr) | (weights > q3 + 1.5 * iqr)])

samples = np.random.default_rng(0).normal(weights.mean(), weights.std(ddof=1), 1000)
توزیع نرمال در یادگیری ماشین
توزیع نرمال فقط برای توصیف داده نیست. وزنهای اولیهی شبکهی عصبی معمولاً از توزیع نرمال یا نزدیک به آن انتخاب میشوند. بسیاری از مدلها هم فرض میکنند خطای پیشبینی توزیع نرمال دارد.
به همین دلیل پیش از آموزش مدل، هیستوگرام ویژگیها را نگاه کنید. اگر ویژگیای خیلی نامتقارن است، مثلاً درآمد یا تعداد بازدید، تبدیل لگاریتمی معمولاً آن را به توزیع نرمال نزدیکتر میکند. این کار آموزش را پایدارتر میکند.
بازه اطمینان؛ گزارش صادقانه نتیجه
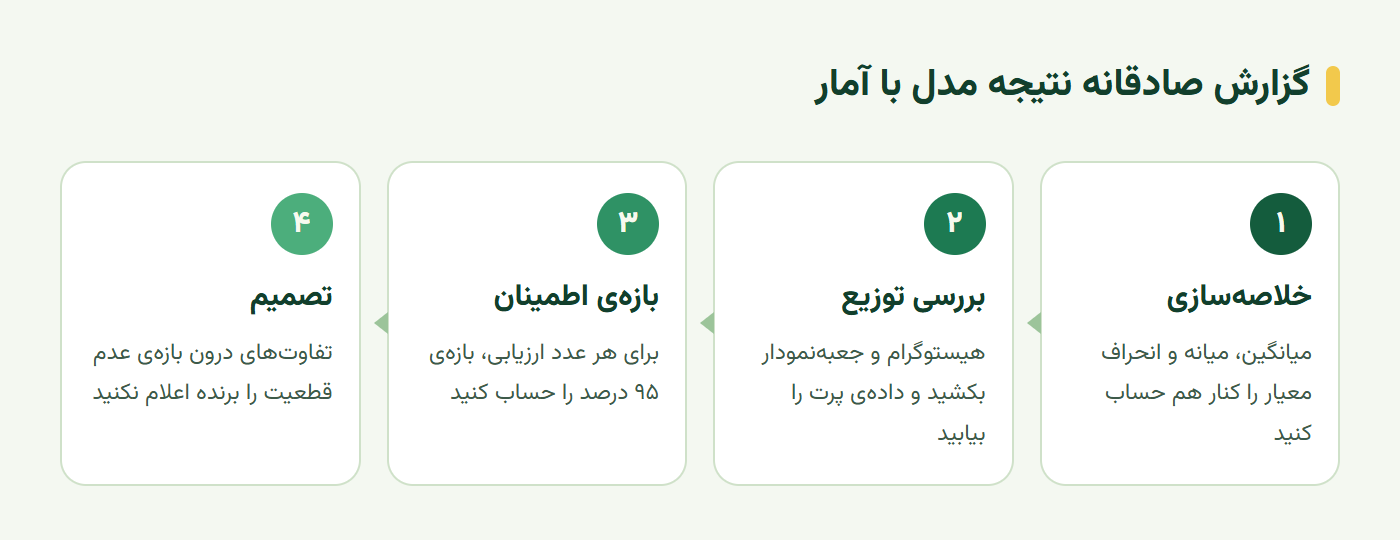
فرض کنید میخواهیم میانگین واقعی وزن همهی بازیکنان را بدانیم، اما فقط یک نمونه داریم. میانگین نمونه یک تخمین است. اگر نمونهی دیگری بگیریم، عدد کمی فرق میکند. بازهی اطمینان این عدم قطعیت را صادقانه نشان میدهد. نمودار زیر چهار قدم گزارش یک نتیجه با بازهی اطمینان را نشان میدهد.
بازه اطمینان چیست؟
بازهی اطمینان محدودهای است که با احتمال مشخصی، مقدار واقعی جمعیت را در بر میگیرد. به این احتمال سطح اطمینان میگویند. در دادهی وزن بازیکنان، بازهی اطمینان میانگین در سطح ۸۵ درصد حدود ۰٫۹۴± و در سطح ۹۵ درصد حدود ۱٫۲۸± است.
دقت کنید؛ هرچه اطمینان بیشتری بخواهیم، بازه پهنتر میشود. برای نمونههای کوچک، بازه با توزیع t استیودنت حساب میشود. نام این توزیع از نام مستعار ویلیام سیلی گاست آمده است. او در کارخانهی آبجوسازی گینس کار میکرد و مقالهاش را با نام «Student» منتشر کرد.
کاربرد مستقیم در ارزیابی مدل
حالا به سؤال اول مقاله برگردیم. فرض کنید دقت مدل روی ۲۰۰ نمونهی آزمون ۸۵ درصد است. با تقریب نرمال، خطای استاندارد برابر جذر حاصل ضرب ۰٫۸۵ در ۰٫۱۵ تقسیم بر ۲۰۰ است که حدود ۲٫۵ درصد میشود. پس بازهی ۹۵ درصد تقریباً از ۸۰ تا ۹۰ درصد است.
اگر مدل دوم روی همان داده ۸۷ درصد بگیرد، تفاوت داخل بازهی عدم قطعیت است. نمیتوانید با اطمینان بگویید مدل دوم بهتر است. برای ادعای قویتر، یا نمونهی آزمون بیشتر لازم است یا آزمونی که دو مدل را روی نمونههای یکسان مقایسه کند.
تمرین عملی؛ گزارش آماری یک ستون داده
یک ستون عددی از دادهی پروژهی خودتان انتخاب کنید؛ مثلاً زمان پاسخ پشتیبانی یا نمرهی آزمون. این موارد را حساب و گزارش کنید:
- مقدار معمول: میانگین و میانه را کنار هم بنویسید و فاصلهشان را تفسیر کنید.
- پراکندگی: انحراف معیار و IQR را حساب کنید.
- دادهی پرت: مقادیر پرت را با قاعدهی IQR پیدا کنید و علت هرکدام را بررسی کنید.
- شکل توزیع: هیستوگرام رسم کنید و بگویید تقریباً نرمال است یا نامتقارن.
- بازهی اطمینان: برای میانگین، بازهی ۹۵ درصد را حساب کنید.
اگر میانگین و میانه فاصلهی زیادی دارند، داده نامتقارن است. در گزارش به مدیر، میانه را جلوتر بیاورید.
سخن پایانی
آمار و احتمال ابزار دیدن داده به شکل درست است. احتمال و متغیر تصادفی زبان توصیف عدم قطعیتاند. میانگین، میانه، واریانس و چارکها داده را خلاصه میکنند و توزیع نرمال شکل رایج بسیاری از دادههای واقعی است.
مهمترین درس این قسمت برای سازندهی هوش مصنوعی بازهی اطمینان است. هر عدد ارزیابی را با عدم قطعیتش گزارش کنید. تفاوت کوچک دو مدل روی دادهی کم معمولاً چیزی جز شانس نیست.
این آموزش بر پایهی درس A Brief Introduction to Statistics and Probability از مجموعهی آزاد Data Science for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
چرا برای هوش مصنوعی به آمار و احتمال نیاز داریم؟
چون داده همیشه نمونهای از یک جمعیت بزرگتر است و نتیجهی مدل هم عدم قطعیت دارد. آمار کمک میکند داده را خلاصه کنیم، دادهی پرت را بشناسیم، مدلها را منصفانه مقایسه کنیم و بفهمیم تفاوت دو نتیجه واقعی است یا تصادفی.
تفاوت میانگین و میانه چیست؟
میانگین حاصل جمع مقادیر تقسیم بر تعداد است و به دادهی پرت حساس است. میانه مقداری است که نیمی از داده کمتر و نیمی بیشتر از آن است. وقتی داده چند مقدار خیلی بزرگ یا کوچک دارد، میانه تصویر واقعیتری از مقدار معمول میدهد.
توزیع نرمال چیست؟
توزیع نرمال یا زنگولهای توزیعی است که بیشتر مقادیر حول میانگین جمع شدهاند و هرچه دورتر شویم، تعدادشان متقارن کم میشود. قد و وزن انسانها و خطای اندازهگیری معمولاً تقریباً از این توزیع پیروی میکنند و با میانگین و انحراف معیار توصیف میشود.
بازه اطمینان چیست؟
بازه اطمینان محدودهای است که با احتمال مشخص، مثلاً ۹۵ درصد، مقدار واقعی جمعیت را در بر میگیرد. مثلاً به جای اینکه بگوییم دقت مدل ۸۵ درصد است، میگوییم با ۹۵ درصد اطمینان بین ۸۱ و ۸۹ درصد است. هرچه نمونه بیشتر باشد، بازه باریکتر میشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.