
داده ساختاریافته، نیمهساختاریافته و بدون ساختار سه شکل اصلی دادهاند که هر پروژهی هوش مصنوعی با آنها سروکار دارد. شناختن این سه شکل فقط یک بحث نظری نیست. نوع داده تعیین میکند کجا ذخیره شود، چطور پاکسازی شود و با چه روشی به ورودی مدل تبدیل شود.
در قسمت قبل مراحل یادگیری ماشین را دیدیم و فهمیدیم مرحلهی داده مهمترین مرحله است. حالا دقیقتر به خود داده نگاه میکنیم. اول انواع داده را از چند زاویه میشناسیم. بعد منابع داده را مرور میکنیم و در پایان میبینیم هر نوع داده چطور به شکل قابل فهم برای مدل درمیآید.
داده چیست و چطور توصیفش میکنیم؟
داده مجموعهای از واقعیتها، مشاهدهها و اندازهگیریهاست که برای کشف و تصمیمگیری آگاهانه استفاده میشود. یک نقطهی داده یک واحد منفرد در مجموعهداده است. مجموعهداده هم مجموعهای از نقطههای داده است که قالب و ساختار متفاوتی دارد.
داده را میشود از چند زاویه توصیف کرد. یک زاویه وضعیت پردازش است؛ یعنی داده خام است یا پردازششده. زاویهی دیگر جنس مقدار است؛ یعنی عددی است یا دستهای. زاویهی سوم هم ساختار است که مهمترین تقسیمبندی برای هوش مصنوعی به شمار میرود.
داده خام و داده پردازششده
دادهی خام همان شکلی است که از منبع آمده و هنوز تحلیل یا مرتب نشده است. مثلاً فایل لاگ سرور یا خروجی مستقیم یک فرم، دادهی خاماند. برای فهمیدن دادهی خام، باید آن را مرتب کنیم تا انسان و فناوری بتوانند تحلیلش کنند.
ساختار مجموعهداده توضیح میدهد داده چطور سازماندهی شده است. این ساختار میتواند ساختاریافته، نیمهساختاریافته یا بدون ساختار باشد. نوع ساختار به منبع داده بستگی دارد، اما در نهایت در یکی از همین سه دسته جا میگیرد.
داده کمی و داده کیفی
دادهی کمی مشاهدهی عددی است که میشود آن را اندازه گرفت و با آن محاسبه کرد. قیمت، جمعیت، دما و تعداد بازدید نمونههای دادهی کمیاند. این داده برای تحلیل آماری و بسیاری از مدلها مستقیم قابل استفاده است.
دادهی کیفی یا دستهای را نمیشود مثل عدد اندازه گرفت. رنگ، شهر، نوع اشتراک و نظر کاربر دربارهی یک محصول از این جنساند. گاهی دادهی کیفی شکل عدد دارد اما عدد نیست؛ مثل کد پستی یا شمارهی دانشجویی. میانگین کد پستی معنایی ندارد، پس باید آن را دستهای در نظر گرفت.
سه نوع داده از نظر ساختار
مهمترین تقسیمبندی برای پروژهی هوش مصنوعی، تقسیم بر اساس ساختار است. هر نوع مزایا و محدودیتهای خودش را دارد. جدول زیر این سه نوع را کنار هم میگذارد.
| ویژگی | ساختاریافته | نیمهساختاریافته | بدون ساختار |
|---|---|---|---|
| شکل | ردیف و ستون ثابت | برچسب و سلسلهمراتب | بدون قالب ثابت |
| نمونه | جدول اکسل، پایگاه داده رابطهای | JSON، HTML، XML | متن، صدا، ویدئو |
| جستجو | بسیار آسان با SQL | متوسط | سخت بدون پردازش |
| انعطاف | کم | زیاد | کامل |
| آمادهسازی برای مدل | کم | متوسط | زیاد |
داده ساختاریافته؛ جدولهای مرتب
دادهی ساختاریافته در ردیف و ستون مرتب شده و هر ردیف همان ستونها را دارد. هر ستون مقداری از یک نوع مشخص را نشان میدهد و نامی دارد که توضیح میدهد چه چیزی در آن است. هر ردیف هم مقادیر واقعی را دارد.
مزیت بزرگ دادهی ساختاریافته این است که میشود آن را به دادهی ساختاریافتهی دیگر وصل کرد. مثلاً جدول دانشجویان با جدول ثبتنامها از طریق شمارهی دانشجویی مرتبط میشود. اما چون ساختار ثابت است، تغییرش سخت است. افزودن یک ستون تازه ممکن است کل سیستم را درگیر کند.
داده نیمهساختاریافته؛ انعطاف با کمی نظم
دادهی نیمهساختاریافته ترکیبی از دو نوع دیگر است. معمولاً در ردیف و ستون جا نمیگیرد، اما برچسب و سلسلهمراتب دارد. JSON، HTML و XML نمونههای رایجاند. هر رکورد میتواند فیلدهای متفاوتی داشته باشد.
این انعطاف برای دادهای که شکلش در طول زمان تغییر میکند مناسب است. مثلاً پیامهای یک دستیار گفتوگو گاهی فقط متن دارند و گاهی پیوست، دکمه یا منبع. تعریف یک ستون برای هر حالت ممکن سخت است، اما JSON همهی حالتها را راحت نگه میدارد.
داده بدون ساختار؛ بیشترین حجم، سختترین تحلیل
دادهی بدون ساختار قالب یا قاعدهی مشخصی ندارد. فایل متنی، پیام کوتاه، صدای ضبطشده و ویدئو همه بدون ساختارند. بیشتر دادهی جهان از همین نوع است و بیشترین ارزش پنهان را هم دارد.
اما تحلیل این داده بدون پردازش ممکن نیست. نمیتوانید مستقیم میانگین یک ویدئو را حساب کنید. پیش از هر تحلیلی باید ویژگیهایی از آن بیرون بکشید. هوش مصنوعی دقیقاً در همین نقطه بیشترین کمک را میکند.
بیشتر بخوانید: اگر مراحل پروژهی یادگیری ماشین و مفهوم ویژگی و هدف را ندیدهاید، یادگیری ماشین چیست؟ را بخوانید.
منابع داده؛ داده از کجا میآید؟
منبع داده جایی است که داده در آن تولید شده یا نگهداری میشود. دادهای که کاربران یک سیستم تولید میکنند، دادهی اولیه نام دارد. دادهای که از منبعی برای کاربرد عمومی جمع شده، دادهی ثانویه است.
پایگاه داده، فایل و API
پایگاه داده رایجترین منبع است. یک سیستم مدیریت پایگاه داده آن را نگه میدارد و کاربران با دستورهایی به نام پرسوجو داده را بیرون میکشند. فایلها هم منبع مهمیاند؛ از فایل صوتی و تصویری تا فایلهای CSV و اکسل.
اینترنت منبع دیگری است. وبسایتها و APIها داده را در دسترس میگذارند و ابزارهای وباسکرپینگ داده را از صفحهها بیرون میکشند. هر منبعی که استفاده میکنید، شرایط استفاده و مجوز داده را پیش از جمعآوری بخوانید.
صفحه گسترده؛ سادهترین نقطه شروع
صفحهی گسترده مثل اکسل محبوبترین ابزار ذخیره و بررسی داده است، چون راهاندازیاش آسان است. هر فایل یک دفترچهکار است که چند برگه دارد. هر برگه از سلولهایی ساخته شده که در ردیف و ستون مرتب شدهاند.
قدرت اصلی صفحهی گسترده فرمول است. مثلاً در یک برگهی موجودی انبار، ارزش هر کالا از ضرب تعداد در قیمت واحد به دست میآید. با یک فرمول دیگر هم ارزش کل موجودی حساب میشود. برای پروژههای کوچک، صفحهی گسترده اغلب کافی است. اما وقتی حجم داده بالا میرود یا چند نفر همزمان کار میکنند، باید سراغ پایگاه داده رفت.
تبدیل هر نوع داده به ورودی مدل هوش مصنوعی
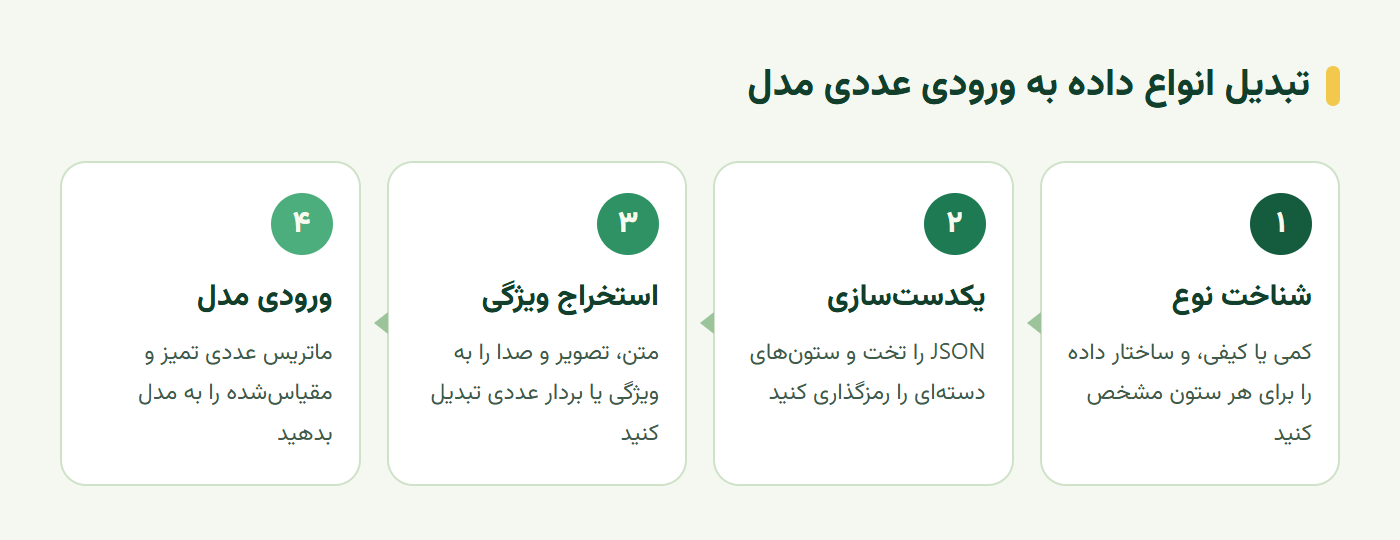
مدلهای یادگیری ماشین فقط با عدد کار میکنند. پس هر نوع داده باید پیش از آموزش به شکل عددی درآید. روش این تبدیل برای هر نوع داده متفاوت است. نمودار زیر مسیر کلی این تبدیل را نشان میدهد.
داده ساختاریافته؛ رمزگذاری و مقیاسبندی
ستونهای عددی معمولاً فقط به مقیاسبندی نیاز دارند تا بازهی همهی آنها نزدیک به هم باشد. ستونهای دستهای باید رمزگذاری شوند. رایجترین روش رمزگذاری یکداغ است؛ یعنی برای هر دسته یک ستون صفر و یک ساخته میشود.
کد زیر یک نمونهی ساده با کتابخانهی pandas است. ستون «شهر» دستهای است و به ستونهای صفر و یک تبدیل میشود:
import pandas as pd

df = pd.DataFrame({
    "city": ["Tehran", "Shiraz", "Tehran"],
    "age": [24, 31, 28],
    "paid": [1, 0, 1],
})
X = pd.get_dummies(df[["city", "age"]], columns=["city"])
print(X)
داده نیمهساختاریافته و بدون ساختار
دادهی نیمهساختاریافته را معمولاً اول تخت میکنیم؛ یعنی فیلدهای تودرتوی JSON را به ستون تبدیل میکنیم. تابع pd.json_normalize در pandas همین کار را انجام میدهد. فیلدهایی که در بعضی رکوردها نیستند، مقدار خالی میگیرند و باید تصمیم بگیرید با آنها چه کنید.
دادهی بدون ساختار مسیر طولانیتری دارد. متن به توکن و سپس به بردار عددی تبدیل میشود. تصویر به آرایهای از شدت رنگ پیکسلها تبدیل میشود. صدا هم به طیف فرکانسی درمیآید. در قسمتهای بعدی این مجموعه، هرکدام از این تبدیلها را جداگانه و دقیق میبینیم.
تمرین عملی؛ برچسبگذاری مجموعهدادهها
سه تا پنج مجموعهداده از Kaggle یا دادهی پروژهی خودتان انتخاب کنید. برای هرکدام این موارد را بنویسید:
- کمی یا کیفی: هر ستون مهم عددی است یا دستهای؟
- نوع ساختار: کل مجموعه ساختاریافته، نیمهساختاریافته یا بدون ساختار است؟
- منبع: داده اولیه است یا ثانویه، و مجوز استفادهاش چیست؟
- مسیر تبدیل: برای رسیدن به ورودی عددی مدل چه کاری لازم است؟
در دستیار آموزشی که از قسمت اول ساختیم، دستکم یک منبع از هر سه نوع پیدا میشود. فهرست دورهها ساختاریافته است، پیامهای گفتوگو نیمهساختاریافتهاند و متن جزوهها بدون ساختار.
سخن پایانی
داده را میشود از سه زاویه توصیف کرد؛ خام یا پردازششده، کمی یا کیفی، و ساختاریافته، نیمهساختاریافته یا بدون ساختار. تقسیم آخر برای هوش مصنوعی از همه مهمتر است، چون مسیر ذخیره و آمادهسازی را تعیین میکند.
دادهی ساختاریافته آمادهترین است و دادهی بدون ساختار بیشترین ارزش پنهان را دارد. کار سازندهی دستیار این است که هر سه را بشناسد و بداند هرکدام را چطور به عدد تبدیل کند. در قسمت بعد، میبینیم شبکهی عصبی با همین عددها چه میکند.
این آموزش بر پایهی درسهای Defining Data و Non-Relational Data از مجموعهی آزاد Data Science for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
داده ساختاریافته چیست؟
دادهای است که در ردیف و ستون مرتب شده و هر ردیف همان ستونها را دارد؛ مثل جدول اکسل، پایگاه داده رابطهای یا صورتحساب بانکی. این داده بهراحتی جستجو و تحلیل میشود، اما تغییر ساختارش سخت است.
تفاوت داده ساختاریافته و بدون ساختار چیست؟
داده ساختاریافته طرح ثابتی از ستونها دارد و مستقیم قابل تحلیل آماری است. داده بدون ساختار مثل متن، صدا و ویدئو قالب ثابتی ندارد و پیش از تحلیل باید با روشهایی مثل استخراج ویژگی یا بردارسازی به شکل عددی تبدیل شود.
داده نیمهساختاریافته چه مثالی دارد؟
JSON، HTML و XML نمونههای رایجاند. این دادهها برچسب و سلسلهمراتب دارند، اما هر رکورد میتواند فیلدهای متفاوتی داشته باشد. پیامهای یک API یا خروجی یک فرم پویا معمولاً از این نوعاند.
داده کمی و کیفی چه فرقی دارند؟
داده کمی عددی و قابل اندازهگیری است؛ مثل قیمت، سن یا تعداد. داده کیفی یا دستهای ویژگی یا گروه را نشان میدهد؛ مثل رنگ، شهر یا نوع اشتراک. روش تحلیل و پیشپردازش این دو برای مدل متفاوت است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.