
علم داده چیست و چرا پیش از هوش مصنوعی باید آن را بشناسیم؟ چون هر دستیار هوشمند در نهایت روی داده ساخته میشود. اگر نفهمیم داده از کجا میآید، چطور ذخیره میشود و چه تصمیمی قرار است از آن بیرون بیاید، بهترین مدل هم نتیجهی قابل اعتمادی نمیدهد.
در قسمت اول دیدیم که ساخت دستیار از مسئله شروع میشود. در این قسمت یک قدم جلوتر میرویم. اول با تعریف علم داده و حوزههای نزدیک به آن آشنا میشویم. بعد مسیر داده را مرور میکنیم و در پایان یاد میگیریم مسئله را طوری بنویسیم که خروجی و معیار پذیرش آن روشن باشد.
داده چیست و چرا مهمتر از همیشه شده است؟
در زندگی روزمره همیشه با داده سروکار داریم. متنی که الان میخوانید داده است. فهرست شمارههای گوشیتان و ساعتی که روی صفحه میبینید هم دادهاند. ما بهطور طبیعی با داده کار میکنیم؛ پولمان را میشماریم یا برای دوستمان پیام مینویسیم.
با آمدن کامپیوتر، داده اهمیت تازهای پیدا کرد. کار اصلی کامپیوتر محاسبه است، اما بدون داده چیزی برای محاسبه ندارد. با اینترنت هم نقش کامپیوتر بیشتر به مدیریت داده تغییر کرد.
کمی فکر کنید؛ آخرین باری که با کامپیوتر یک محاسبهی واقعی انجام دادید کی بود؟ بیشتر وقتها در حال ساختن، ذخیره کردن، فرستادن یا جستجوی داده هستیم. ایمیل، جستجو در وب و پیامرسان همه از همین جنساند.
علم داده چیست؟ تعریف دقیق و پنج نکته کلیدی
بر اساس تعریف ویکیپدیا، علم داده حوزهای علمی است که با روشهای علمی از دادههای ساختاریافته و بدون ساختار دانش و بینش بیرون میکشد. سپس این بینش را در حوزههای کاربردی مختلف به کار میگیرد. این تعریف کوتاه چند نکتهی مهم در خود دارد.
پنج جزء اصلی تعریف علم داده
اگر تعریف را باز کنیم، به پنج جزء میرسیم:
- استخراج دانش: هدف اصلی فهمیدن داده، پیدا کردن رابطههای پنهان و ساختن مدل است.
- روش علمی: علم داده بر احتمال و آمار تکیه دارد و حدس زدن جای آزمودن را نمیگیرد.
- بینش عملی: دانش بهدستآمده باید به تصمیمی در دنیای واقعی تبدیل شود.
- انواع داده: باید بتوانیم هم با جدول مرتب و هم با متن و تصویر کار کنیم.
- حوزهی کاربرد: دانشمند داده باید کمی از مالی، پزشکی یا بازاریابی سر دربیاورد.
نکتهی آخر معمولاً نادیده گرفته میشود. تحلیلگری که نداند یک عدد در کسبوکار چه معنایی دارد، ممکن است نتیجهای درست اما بیفایده بگیرد. به همین دلیل گفتوگو با کارشناس حوزه بخشی از کار علم داده است.
آیا علم داده همان آمار است؟
وقتی اصطلاح علم داده مطرح شد، بعضیها گفتند این فقط نام تازهای برای آمار است. امروز روشن است که این حوزه گستردهتر است. آمار پایهی ریاضی را فراهم میکند، اما علم داده جمعآوری، ذخیره و پردازش داده با کامپیوتر را هم در بر میگیرد.
جیم گری، دانشمند علوم کامپیوتر، علم داده را پارادایم چهارم علم میدانست. سه پارادایم قبلی علم تجربی مبتنی بر مشاهده، علم نظری مبتنی بر دانش موجود و علم محاسباتی مبتنی بر شبیهسازی بودند. پارادایم چهارم، علم مبتنی بر داده است؛ یعنی کشف رابطهها و الگوها در حجم زیاد داده.
بیشتر بخوانید: اگر هنوز تفاوت هوش مصنوعی نمادین و شبکه عصبی برایتان روشن نیست، قسمت اول یعنی هوش مصنوعی چیست؟ را بخوانید.
حوزههای مرتبط با علم داده
داده همهجا هست، پس علم داده هم با رشتههای زیادی در ارتباط است. شناختن این حوزهها کمک میکند بدانید برای هر بخش از پروژه به چه مهارتی نیاز دارید. جدول زیر مهمترین آنها را خلاصه میکند.
| حوزه | پرسش اصلی | نمونه در دستیار آموزشی |
|---|---|---|
| پایگاه داده | داده را چطور ذخیره کنیم تا سریع پیدا شود؟ | جدول دورهها و ثبتنامها |
| کلانداده | حجم عظیم داده را چطور پردازش کنیم؟ | لاگ میلیونها پرسش کاربران |
| یادگیری ماشین | چطور از داده مدل پیشبینی بسازیم؟ | پیشبینی احتمال انصراف دانشجو |
| هوش مصنوعی | چطور دادهی بدون ساختار را بفهمیم؟ | فهم پرسش متنی کاربر |
| بصریسازی | چطور داده را برای انسان قابل فهم کنیم؟ | نمودار پرتکرارترین پرسشها |
یادگیری ماشین و هوش مصنوعی در دل علم داده
یکی از راههای فهم داده، ساختن مدلی است که نتیجهی مطلوب را پیشبینی کند. به ساختن مدل از روی داده یادگیری ماشین میگویند. هوش مصنوعی هم بخشی از همین مسیر است که مدلهای پیچیدهتری برای تقلید فرایند فکر انسان میسازد.
یک کاربرد مهم هوش مصنوعی در علم داده، تبدیل دادهی بدون ساختار به دادهی ساختاریافته است. مثلاً از هزار پیام کاربر، موضوع و احساس هر پیام را استخراج میکنیم. حالا یک جدول مرتب داریم که میشود با آمار تحلیلش کرد.
بصریسازی و پایگاه داده؛ دو ستون فراموششده
حجم زیاد داده برای انسان قابل فهم نیست. یک نمودار درست گاهی بیش از یک مدل پیچیده به تصمیمگیری کمک میکند. به همین دلیل بصریسازی، اینفوگرافیک و تعامل انسان و کامپیوتر هم به علم داده نزدیکاند.
از آن طرف، نحوهی ذخیرهی داده روی سرعت و امکان تحلیل اثر مستقیم دارد. پایگاه دادهی رابطهای، پایگاه دادهی NoSQL و دریاچهی داده هرکدام برای نوعی از داده مناسباند. در قسمتهای بعدی این مجموعه به هرکدام جداگانه میپردازیم.
داده را از کجا بیاوریم؟
منابع داده بیشمارند، اما بیشترشان در سه دسته جا میگیرند. دادهی ساختاریافته شکل جدول دارد، دادهی نیمهساختاریافته نوعی ساختار متغیر دارد و دادهی بدون ساختار مجموعهای از فایلهاست. برای هر دسته چند منبع رایج وجود دارد.
منابع دادهی ساختاریافته
حسگرهای اینترنت اشیا یکی از منابع مهماند. مثلاً ساختمانی که حسگر دما دارد، میتواند گرمایش را خودکار تنظیم کند و هزینه را پایین بیاورد. نظرسنجی بعد از خرید هم دادهی ساختاریافتهی ارزشمندی میدهد.
تحلیل رفتار کاربر در سایت منبع دیگری است. این داده نشان میدهد کاربر تا کجای سایت پیش میرود و معمولاً کجا آن را ترک میکند. برای یک آموزشگاه آنلاین، همین داده میگوید کدام صفحهی ثبتنام کاربران را فراری میدهد.
منابع دادهی بدون ساختار و نیمهساختاریافته
متن منبع غنی بینش است. از متن میشود احساس کلی، کلمههای کلیدی و معنا را استخراج کرد. تصویر و ویدئو هم کاربرد دارند؛ مثلاً ویدئوی دوربین خیابان برای تخمین ترافیک استفاده میشود. لاگ سرور وب هم نشان میدهد کدام صفحهها بیشتر و طولانیتر دیده میشوند.
گراف شبکههای اجتماعی نمونهی خوبی از دادهی نیمهساختاریافته است. این گراف دربارهی رابطهی افراد و مسیر پخش اطلاعات چیزهای زیادی میگوید. حتی از عکسهای یک مهمانی میشود گرافی ساخت که نشان دهد چه کسانی بیشتر با هم عکس گرفتهاند.
پنج مرحله مسیر داده در پروژه هوش مصنوعی
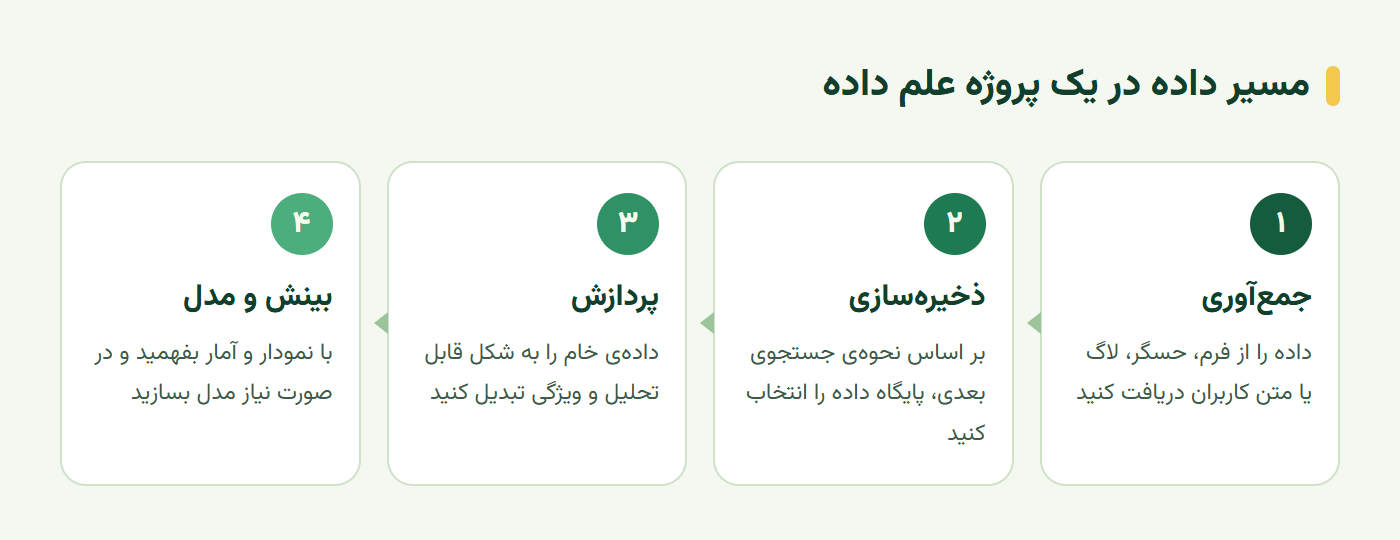
علم داده روی یک مسیر مشخص کار میکند. داده جمعآوری میشود، ذخیره میشود، پردازش میشود و به بینش یا مدل میرسد. البته همهی پروژهها همهی مراحل را ندارند و بعضی مراحل چند بار تکرار میشوند. نمودار زیر چهار مرحلهی اصلی این مسیر را نشان میدهد.
جمعآوری و ذخیرهسازی داده
در بسیاری از پروژهها جمعآوری ساده است؛ داده از یک برنامهی وب مستقیم وارد پایگاه داده میشود. اما گاهی به روش خاصی نیاز داریم. دادهی حسگرها میتواند آنقدر زیاد باشد که لازم است ابتدا در یک صف یا بافر جمع شود و بعد پردازش شود.
برای ذخیرهسازی، اول بپرسید بعداً چطور میخواهید داده را جستجو کنید. پایگاه دادهی رابطهای با زبان SQL برای جدولهای مرتب مناسب است. پایگاه داده NoSQL انعطاف بیشتری برای سندهای JSON دارد، اما قابلیتهای جستجوی SQL را ندارد. دریاچهی داده هم برای حجم عظیم دادهی خام به کار میرود.
پردازش، بصریسازی و آموزش مدل
پردازش جذابترین بخش مسیر است. در این مرحله داده از شکل اولیه به شکلی درمیآید که برای نمودار یا آموزش مدل قابل استفاده باشد. برای متن و تصویر، معمولاً باید با روشهای هوش مصنوعی ویژگی استخراج کنیم تا داده ساختاریافته شود.
بعد از پردازش، نوبت بصریسازی و بینش انسانی است. دانشمند داده معمولاً باید با داده «بازی کند» و آن را بارها از زاویههای مختلف ببیند. در پایان، اگر هدف پیشبینی باشد، مدل یادگیری ماشین آموزش داده میشود تا روی دادهی تازه پیشبینی کند.
تعریف مسئله؛ خروجی و معیار پذیرش را بنویسید
حالا مهمترین درس این قسمت را روی یک مثال پیاده میکنیم. فرض کنید یک آموزشگاه میخواهد دستیاری برای پشتیبانی بسازد. پیش از جمعآوری حتی یک ردیف داده، باید سه چیز روشن باشد.
سه پرسشی که پیش از شروع باید پاسخ دهید
اول، تصمیم نهایی چیست؟ «دستیار پشتیبانی» تصمیم نیست. «پاسخ به پرسشهای پیشنیاز دوره بدون ارجاع به کارشناس» یک تصمیم مشخص است. دوم، دادهی لازم برای این تصمیم کجاست؟ اگر فهرست پیشنیازها جایی ثبت نشده، اول باید آن را بسازید.
سوم، معیار پذیرش چیست؟ مثلاً «از بیست پرسش واقعی، دستکم هجده پاسخ درست و وفادار به سرفصل دوره». این عدد را پیش از ساخت سیستم بنویسید. اگر بعد از دیدن نتیجه معیار را تعیین کنید، ناخودآگاه آن را با نتیجه جور میکنید.
نمونهی مرزی را فراموش نکنید
یک پرسش عادی مسیر اصلی را آزمایش میکند. اما یک پرسش مرزی نشان میدهد سیستم هنگام کمبود اطلاعات چه رفتاری دارد. مثلاً پرسش دربارهی دورهای که هنوز سرفصل ندارد.
پاسخ درست در این حالت «اطلاعاتی در دسترس نیست» است، نه یک پاسخ ساختگی. این نمونه را از روز اول کنار نمونههای عادی نگه دارید. در قسمتهای بعدی، همین نمونهها پایهی ارزیابی مدل میشوند.
تمرین عملی؛ برگهی تعریف مسئله
برای ایدهای که در قسمت اول انتخاب کردید، یک برگهی یکصفحهای با این بخشها بنویسید:
- تصمیم نهایی: در یک جمله بنویسید سیستم دقیقاً چه تصمیمی میگیرد یا چه پاسخی میدهد.
- منبع داده: برای هر بخش از پاسخ، فایل یا سیستمی را که داده از آن میآید نام ببرید.
- نوع داده: مشخص کنید داده ساختاریافته، نیمهساختاریافته یا بدون ساختار است.
- معیار پذیرش: یک عدد مشخص برای موفقیت، پیش از هر آزمایشی، ثبت کنید.
- نمونهی مرزی: دستکم یک ورودی که پاسخش در داده نیست طراحی کنید.
این برگه را نگه دارید. در قسمت بعد تصمیم میگیریم هر بخش از این مسئله با قاعده حل میشود یا با یادگیری ماشین.
سخن پایانی
علم داده یعنی بیرون کشیدن بینش عملی از داده با روش علمی. آمار پایهی آن است، اما جمعآوری، ذخیره، پردازش و بصریسازی هم جزئی از آناند. یادگیری ماشین و هوش مصنوعی ابزارهای قدرتمندی در این مسیرند، نه جایگزین آن.
درس عملی این قسمت هم روشن است. پیش از آنکه سراغ داده یا مدل بروید، تصمیم نهایی، منبع داده و معیار پذیرش را بنویسید. مسئلهای که خوب تعریف شده باشد، نیمی از راه را رفته است.
این آموزش بر پایهی درس Defining Data Science از مجموعهی آزاد Data Science for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
علم داده چیست به زبان ساده؟
علم داده حوزهای است که با روشهای علمی مثل آمار و احتمال، از داده دانش و بینش بیرون میکشد و آن بینش را برای تصمیمگیری در دنیای واقعی به کار میبرد. داده میتواند جدول مرتب، متن، تصویر یا لاگ سرور باشد.
تفاوت علم داده و آمار چیست؟
آمار پایهی ریاضی تحلیل داده را فراهم میکند. علم داده علاوه بر آمار، جمعآوری، ذخیره، پردازش و بصریسازی داده با کامپیوتر و بهکارگیری نتیجه در یک حوزهی مشخص مثل پزشکی یا بازاریابی را هم در بر میگیرد.
تفاوت علم داده و یادگیری ماشین چیست؟
یادگیری ماشین یکی از ابزارهای علم داده است و به ساختن مدلی از روی داده میپردازد که بتواند پیشبینی کند. علم داده گستردهتر است و بسیاری از پروژههایش اصلاً به آموزش مدل نیاز ندارند؛ گاهی یک نمودار درست یا یک آزمون آماری برای تصمیمگیری کافی است.
مراحل یک پروژه علم داده کدام است؟
پنج مرحلهی اصلی جمعآوری داده، ذخیرهسازی، پردازش، بصریسازی و در صورت نیاز آموزش مدل پیشبینی است. بعضی مراحل ممکن است حذف یا چند بار تکرار شوند، اما تعریف دقیق مسئله باید پیش از همه انجام شود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.