
سیستم خبره چیست و چرا باید دربارهی فناوریای از دهههای گذشته بدانیم؟ چون بخش بزرگی از منطق دستیارهای امروزی هنوز با قاعده نوشته میشود. تصمیمهایی مثل «اگر کاربر وارد نشده، به صفحهی ورود بفرست» یا «اگر پرداخت ناموفق بود، دوباره تلاش نکن» نیازی به یادگیری ماشین ندارند.
در قسمت قبل مسئله را دقیق تعریف کردیم. حالا باید تصمیم بگیریم هر بخش آن با قاعده حل میشود یا با یادگیری. برای این تصمیم، ابتدا هوش مصنوعی نمادین را میشناسیم. یعنی میبینیم دانش چطور در کامپیوتر نمایش داده میشود و یک سیستم خبره چطور با آن استدلال میکند.
دانش چیست؟ از داده تا حکمت
در روزهای اول هوش مصنوعی، رویکرد بالا به پایین محبوب بود. ایده این بود که دانش را از متخصص بگیریم، به شکلی قابل خواندن برای ماشین درآوریم و بعد مسئله را خودکار حل کنیم. این رویکرد بر دو ایدهی اصلی تکیه داشت: بازنمایی دانش و استدلال.
اما پیش از بازنمایی باید بدانیم دانش با داده و اطلاعات چه فرقی دارد. میگوییم کتابها دانش دارند، چون با خواندنشان متخصص میشویم. اما در واقع کتاب فقط داده دارد. دانش چیزی است که پس از یادگیری در ذهن ما شکل میگیرد و به مدل ذهنی ما از جهان اضافه میشود.
هرم DIKW به زبان ساده
هرم DIKW رابطهی این مفاهیم را در چهار سطح نشان میدهد:
- داده: چیزی است که روی رسانهی فیزیکی ثبت شده؛ مثل متن نوشتهشده یا کلمهی گفتهشده. داده مستقل از انسان وجود دارد.
- اطلاعات: تفسیری است که ذهن ما از داده میسازد. وقتی کلمهی «کامپیوتر» را میشنویم، برداشتی از آن داریم.
- دانش: اطلاعاتی است که در مدل ذهنی ما جا افتاده؛ مثلاً میدانیم کامپیوتر چطور کار میکند و چه هزینهای دارد.
- حکمت: دانش دربارهی دانش است؛ یعنی بدانیم کی و چطور از دانش استفاده کنیم.
پس مسئلهی بازنمایی دانش این است: دانش را چطور به شکل داده در کامپیوتر بنویسیم که خودکار قابل استفاده باشد؟ این یک طیف است. در یک سر، الگوریتم قرار دارد که کامپیوتر راحت اجرایش میکند اما انعطاف ندارد. در سر دیگر، متن طبیعی قرار دارد که بیشترین قدرت بیان را دارد اما برای استدلال خودکار مناسب نیست.
روشهای بازنمایی دانش در کامپیوتر
روشهای بازنمایی دانش در چهار دستهی اصلی جا میگیرند. هر دسته برای نوعی از دانش مناسبتر است. شناختن آنها کمک میکند در پروژهی خودتان شکل درست ذخیرهی دانش را انتخاب کنید.
شبکه معنایی و سهتاییها
ما در ذهن شبکهای از مفاهیم مرتبط داریم. همین شبکه را میشود به شکل گراف در کامپیوتر ساخت که به آن شبکهی معنایی میگویند. چون گراف را میتوان به شکل فهرستی از گرهها و یالها نوشت، شبکهی معنایی را با سهتاییهای «شیء، ویژگی، مقدار» نمایش میدهیم.
| شیء | ویژگی | مقدار |
|---|---|---|
| Python | نوع | زبان با نوعدهی پویا |
| Python | سازنده | گیدو ون روسوم |
| Python | نحو بلوک | تورفتگی |
همین ایده امروز در گرافهای دانش و پایگاههای گرافی زنده است. وقتی دستیار شما باید بداند «دورهی الف پیشنیاز دورهی ب است»، یک سهتایی ساده کافی است.
قابها و بازنمایی سلسلهمراتبی
ما اغلب اشیا را در سلسلهمراتب میبینیم. میدانیم قناری پرنده است و همهی پرندهها بال دارند. پس لازم نیست برای هر قناری جدا بنویسیم که بال دارد. بازنمایی قاب هر شیء یا دسته را به شکل یک قاب با چند خانه یا اسلات نشان میدهد.
هر اسلات میتواند مقدار، مقدار پیشفرض یا محدودهی مجاز داشته باشد. مثلاً قاب «برنامهی پایتون» اسلات «سبک نامگذاری» با مقدار پیشفرض snake_case دارد. این ایده بعدها به برنامهنویسی شیءگرا و کلاسها راه پیدا کرد.
قاعدههای تولید و منطق
بازنمایی رویهای دانش را به شکل کارهایی مینویسد که در شرایط خاص انجام میشوند. رایجترین شکلش قاعدهی «اگر-آنگاه» است. مثلاً پزشک قاعدهای دارد که میگوید اگر بیمار تب بالا دارد یا CRP خونش بالاست، آنگاه احتمالاً التهاب دارد.
منطق هم از زمان ارسطو راهی برای بازنمایی دانش بوده است. منطق کامل برای محاسبه بیش از حد غنی است. به همین دلیل زیرمجموعههایی از آن مثل قاعدههای Horn در زبان Prolog استفاده میشوند. منطق توصیفی هم در وب معنایی برای استدلال دربارهی سلسلهمراتب مفاهیم به کار میرود.
بیشتر بخوانید: پیش از ادامه، اگر مسیر داده و تعریف مسئله را ندیدهاید، قسمت دوم یعنی علم داده چیست؟ را بخوانید.
سیستم خبره چیست و چطور کار میکند؟
سیستم خبره یکی از اولین موفقیتهای هوش مصنوعی نمادین بود. این سیستم برای کار در یک حوزهی محدود، مثل تشخیص پزشکی، طراحی شده و بر پایهی دانشی کار میکند که از یک یا چند متخصص گرفته شده است. ساختارش از حافظهی کوتاهمدت و بلندمدت انسان الهام گرفته است.
سه جزء اصلی سیستم خبره
هر سیستم خبره سه بخش دارد. حافظهی مسئله یا حافظهی کاری، دانش مربوط به مسئلهی فعلی را نگه میدارد؛ مثل دما و فشار خون بیمار. پایگاه دانش، قاعدههای بلندمدت حوزه را دارد که از متخصص گرفته شده و از یک مشاوره به مشاورهی بعد تغییر نمیکند.
جزء سوم موتور استنتاج است. موتور استنتاج کل فرایند را هماهنگ میکند. تصمیم میگیرد کدام قاعده در هر لحظه اجرا شود و در صورت نیاز از کاربر سؤال میپرسد. مزیت بزرگ این ساختار جدا بودن دانش از استدلال است. پس متخصص میتواند قاعدهها را عوض کند، بدون اینکه کد موتور را بفهمد.
یک مثال؛ تشخیص گوشتخوار بودن حیوان
فرض کنید سیستمی میخواهد حیوان را بر اساس ویژگیهایش شناسایی کند. یکی از قاعدههایش این است:
IF the animal eats meat
OR (the animal has sharp teeth
    AND the animal has claws
    AND the animal has forward-looking eyes)
THEN the animal is a carnivore
هر شرط این قاعده در واقع یک سهتایی «شیء، ویژگی، مقدار» است. حافظهی کاری مجموعهای از همین سهتاییها برای حیوان فعلی است. موتور استنتاج دنبال قاعدههایی میگردد که شرطشان برقرار است و نتیجهشان را به حافظهی کاری اضافه میکند.
استنتاج پیشرو و استنتاج بازگشتی
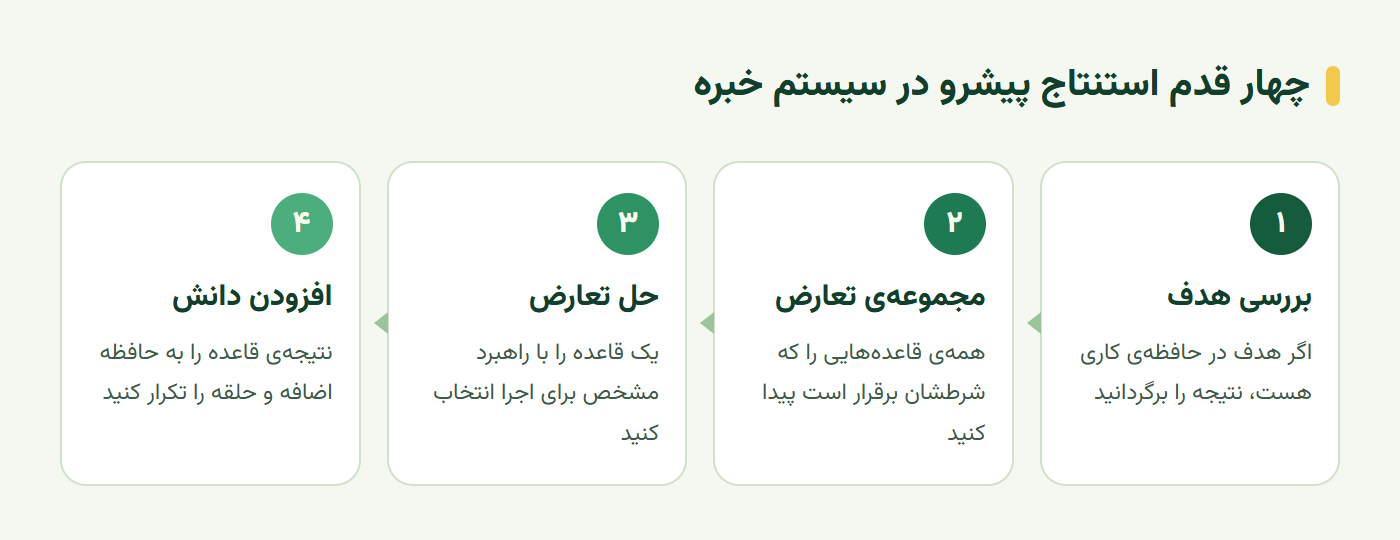
موتور استنتاج دو راه اصلی برای رسیدن به نتیجه دارد. انتخاب بین این دو به این بستگی دارد که داده را از اول دارید یا باید در طول کار بپرسید. نمودار زیر چهار قدم استنتاج پیشرو را نشان میدهد.
استنتاج پیشرو؛ از داده به نتیجه
استنتاج پیشرو با دادههای موجود در حافظهی کاری شروع میکند. اگر هدف در حافظه باشد، کار تمام است. در غیر این صورت، همهی قاعدههایی را پیدا میکند که شرطشان برقرار است. به این مجموعه، مجموعهی تعارض میگویند.
بعد یکی از قاعدهها را انتخاب میکند. راهبرد انتخاب میتواند اولین قاعده، یک قاعدهی تصادفی یا قاعدهی خاصتر با شرطهای بیشتر باشد. نتیجهی قاعده به حافظه اضافه میشود و حلقه تکرار میشود. این کد پایتون ساده همین ایده را نشان میدهد:
rules = [
({"eats_meat"}, "carnivore"),
({"sharp_teeth", "claws", "forward_eyes"}, "carnivore"),
({"carnivore", "tawny", "dark_spots"}, "cheetah"),
]
def forward_chain(facts, goal):
facts = set(facts)
while goal not in facts:
fired = [c for cond, c in rules if cond <= facts and c not in facts]
if not fired:
return None # هیچ قاعدهای قابل اجرا نیست
facts.add(fired[0])
return goal
print(forward_chain({"sharp_teeth", "claws", "forward_eyes", "tawny", "dark_spots"}, "cheetah"))استنتاج بازگشتی؛ از هدف به سؤال
گاهی از ابتدا همهی داده را نداریم. پزشک همهی آزمایشها را از اول درخواست نمیکند. فقط وقتی تصمیمی به آن نیاز دارد، آزمایش را میخواهد. استنتاج بازگشتی همین رفتار را مدل میکند و با هدف شروع میکند.
موتور همهی قاعدههایی را پیدا میکند که میتوانند هدف را ثابت کنند. یکی را بهعنوان فرضیه انتخاب میکند و شرطهایش را هدفهای تازه قرار میدهد. اگر برای یک شرط قاعدهای نبود، از کاربر میپرسد. اگر اثبات شکست خورد، سراغ قاعدهی بعدی میرود.
در عمل، استنتاج پیشرو برای وقتی مناسب است که داده ارزان و از قبل موجود است. استنتاج بازگشتی برای وقتی مناسب است که پرسیدن هزینه دارد؛ مثل فرمهای تشخیص یا پشتیبانی مرحلهبهمرحله.
قاعده یا یادگیری ماشین؛ کدام برای مسئله شما؟
سیستمهای خبره در دهههای گذشته با یک مشکل بزرگ روبهرو شدند. استخراج دانش از متخصص سخت و پرهزینه بود و نگهداری هزاران قاعده عملاً غیرممکن میشد. اما این به معنی کنار گذاشتن قاعده نیست. بیشتر سیستمهای امروزی ترکیبیاند.
نشانههایی که قاعده کافی است
اگر منطق تصمیم را میتوانید در چند جملهی روشن بنویسید، قاعده احتمالاً بهترین انتخاب است. قاعده سریع، ارزان و کاملاً قابل توضیح است. وقتی یک تصمیم باید در دادگاه یا جلسهی مدیریت توضیح داده شود، این ویژگی حیاتی است.
مثلاً در دستیار آموزشگاه، «اگر دانشجو دورهی مقدماتی را نگذرانده، ثبتنام در دورهی پیشرفته مجاز نیست» یک قاعدهی کامل است. آموزش مدل برای این تصمیم نهتنها لازم نیست، بلکه خطا هم اضافه میکند.
نشانههایی که به یادگیری نیاز دارید
وقتی الگو را نمیشود صریح نوشت، سراغ یادگیری ماشین بروید. تشخیص موضوع یک پیام آزاد کاربر یا فهمیدن اینکه عکس ارسالی گواهینامه است یا نه، از این جنساند. در این موارد نمونهی برچسبخورده از قاعده ارزشمندتر است.
راه میانه هم وجود دارد. مدل ورودی آزاد را به دادهی ساختاریافته تبدیل میکند و قاعده روی آن تصمیم میگیرد. مثلاً مدل تشخیص میدهد کاربر دربارهی «ثبتنام» میپرسد، و قاعده بررسی میکند پیشنیاز را گذرانده یا نه.
تمرین عملی؛ جدول قاعده یا یادگیری
برگهی تعریف مسئلهی قسمت قبل را بردارید و برای هر تصمیم این جدول را پر کنید:
- شرح تصمیم: تصمیم را در یک جمله بنویسید؛ مثلاً «مجاز بودن ثبتنام در دوره».
- قاعدهی صریح: اگر میتوانید، قاعده را به شکل «اگر-آنگاه» بنویسید.
- انتخاب نهایی: قاعده، یادگیری ماشین یا ترکیب هر دو را انتخاب کنید و دلیلش را بنویسید.
- نمونهی شکست: یک ورودی بنویسید که قاعدهی شما در آن اشتباه میکند.
اگر برای بیشتر تصمیمها قاعده نوشتید، خبر خوبی است. پروژه سادهتر و ارزانتر از چیزی است که فکر میکردید.
سخن پایانی
سیستم خبره نشان داد که میشود دانش متخصص را به قاعده تبدیل کرد و با موتور استنتاج به نتیجه رسید. شبکهی معنایی، قاب، قاعدهی تولید و منطق چهار راه اصلی بازنمایی این دانشاند. استنتاج پیشرو از داده به نتیجه میرود و استنتاج بازگشتی از هدف به سؤال.
درس مهم برای سازندهی دستیار این است که یادگیری ماشین پاسخ همهی مسئلهها نیست. هر جا قاعدهی روشن دارید، از آن استفاده کنید. یادگیری ماشین را برای جایی نگه دارید که الگو را نمیشود نوشت.
این آموزش بر پایهی درس Knowledge Representation and Expert Systems از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
سیستم خبره چیست؟
سیستم خبره برنامهای است که در یک حوزهی محدود مثل یک متخصص تصمیم میگیرد. دانش متخصص را به شکل قاعدههای «اگر-آنگاه» در پایگاه دانش نگه میدارد و یک موتور استنتاج این قاعدهها را روی دادهی مسئله اجرا میکند تا به نتیجه برسد.
اجزای اصلی سیستم خبره کداماند؟
سه جزء اصلی دارد؛ حافظهی مسئله یا حافظهی کاری که واقعیتهای مسئلهی فعلی را نگه میدارد، پایگاه دانش که قاعدههای بلندمدت حوزه را دارد، و موتور استنتاج که تصمیم میگیرد کدام قاعده کی اجرا شود.
تفاوت استنتاج پیشرو و بازگشتی چیست؟
استنتاج پیشرو از دادههای موجود شروع میکند و قاعدهها را اجرا میکند تا به هدف برسد. استنتاج بازگشتی از هدف شروع میکند و فقط سؤالهایی را میپرسد که برای اثبات آن هدف لازم است؛ مثل پزشکی که فقط آزمایشهای لازم را درخواست میکند.
کی از قاعده استفاده کنیم و کی از یادگیری ماشین؟
وقتی قاعدهها روشن، کمتعداد و پایدارند و توضیحپذیری مهم است، قاعده بهتر است. وقتی الگو را نمیتوان صریح نوشت اما نمونهی برچسبخوردهی کافی دارید، مثل تشخیص تصویر یا دستهبندی متن آزاد، یادگیری ماشین مناسبتر است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.