
یادگیری ماشین چیست و چه فرقی با برنامهنویسی معمولی دارد؟ در برنامهنویسی معمولی، قاعده را مینویسیم و کامپیوتر اجرایش میکند. در یادگیری ماشین، نمونهها را میدهیم و کامپیوتر خودش قاعده را پیدا میکند. نتیجهی این فرایند مدلی است که میتواند برای ورودی تازه پیشبینی کند.
در قسمت قبل دیدیم کجا قاعده کافی است. حالا سراغ جایی میرویم که قاعده جواب نمیدهد. در این قسمت هفت مرحلهی یک پروژهی یادگیری نظارتشده را از انتخاب سؤال تا پیشبینی مرور میکنیم. در پایان هم یک مثال کوتاه پایتون میبینیم که همهی این مراحل را کنار هم نشان میدهد.
یادگیری ماشین چیست و چرا جریان کارش متفاوت است؟
ساخت، استفاده و نگهداری مدل یادگیری ماشین با بیشتر کارهای توسعهی نرمافزار فرق دارد. در نرمافزار معمولی، اگر کد درست باشد، خروجی هم درست است. اما در یادگیری ماشین، کیفیت نتیجه به داده بستگی دارد و داده همیشه ناقص است.
به همین دلیل، پروژهی یادگیری ماشین چرخهای از آزمایش است. داده را آماده میکنید، مدل را آموزش میدهید، نتیجه را میسنجید و دوباره برمیگردید. کسی که این چرخه را بفهمد، از اشتباههای رایج مثل ارزیابی روی دادهی آموزشی دور میماند.
یادگیری نظارتشده در یک نگاه
یادگیری ماشین چند شاخه دارد. در یادگیری نظارتشده، هر نمونهی آموزشی یک پاسخ درست یا برچسب دارد. مثلاً هزار پیام پشتیبانی داریم که کارشناس برای هرکدام موضوعی مثل «ثبتنام» یا «پرداخت» مشخص کرده است.
مدل رابطهی متن پیام و موضوع را یاد میگیرد. بعد برای پیام تازهای که برچسب ندارد، موضوع را پیشبینی میکند. شاخههای دیگر مثل یادگیری بدون نظارت و یادگیری تقویتی را در قسمتهای بعدی این مجموعه میبینیم.
هفت مرحله پروژه یادگیری نظارتشده
در نگاه کلی، هر پروژهی یادگیری ماشین از چند مرحلهی تکرارشونده تشکیل میشود. این مراحل همیشه خطی نیستند و معمولاً چند بار بین آنها رفتوبرگشت دارید. فهرست زیر خلاصهی این مسیر است:
- انتخاب سؤال: سؤالی که با قاعدهی ساده جواب نمیگیرد.
- جمعآوری و آمادهسازی داده: کیفیت و مقدار داده سقف موفقیت را تعیین میکند.
- انتخاب روش آموزش: بسته به سؤال و نوع داده، الگوریتم مناسب را برمیگزینید.
- آموزش مدل: مدل با دادهی آموزشی الگو را یاد میگیرد.
- ارزیابی مدل: عملکرد را روی دادهی دیدهنشده میسنجید.
- تنظیم پارامترها: با تغییر ابرپارامترها فرایند را تکرار میکنید.
- پیشبینی: مدل را روی ورودی کاملاً تازه به کار میبرید.
در ادامه، مهمترین مراحل را باز میکنیم. تمرکز روی جاهایی است که بیشترین خطا در آنها رخ میدهد.
مرحله اول؛ چه سؤالی از داده بپرسیم؟
کامپیوتر در پیدا کردن الگوهای پنهان داده بسیار تواناست. این توانایی برای سؤالهایی ارزش دارد که نمیشود با قاعدهی شرطی جوابشان را داد. بیشتر این سؤالها حول پیشبینی میچرخند.
سؤال خوب پیشبینیپذیر و قابل سنجش است
مثلاً اگر بخواهیم نرخ مرگومیر را بر اساس سن پیشبینی کنیم، یک قاعدهی آماری ساده کافی است. اما وقتی دهها متغیر از سابقهی سلامت وارد میشود، مدل یادگیری ماشین کارآمدتر است. نمونهی شادتر، پیشبینی آبوهوای ماه آینده بر اساس دادهی عرض جغرافیایی، دما و الگوهای گذشته است.
سؤال خوب دو ویژگی دارد. اول، پاسخش را میشود از دادهی موجود بیرون کشید. دوم، درستی پاسخ را میشود سنجید. «کدام پیام پشتیبانی فوری است؟» سؤال خوبی است، به شرط اینکه تعریف «فوری» روشن باشد.
سؤال را به ویژگی و هدف تبدیل کنید
ویژگی خصوصیت قابل اندازهگیری داده است. در بیشتر مجموعهدادهها، ویژگیها همان عنوان ستونها هستند؛ مثل تاریخ، اندازه یا رنگ. در کد معمولاً ویژگیها را با X نشان میدهند.
هدف چیزی است که میخواهید پیشبینی کنید و معمولاً با y نشان داده میشود. هدف پاسخ سؤال شماست. اگر سؤال «کدام پیام فوری است» باشد، ویژگیها متن پیام و زمان ارسالاند و هدف برچسب «فوری» یا «عادی» است.
مرحله دوم؛ داده را آماده و تقسیم کنید
برای پاسخ مطمئن به سؤال، به مقدار کافی از دادهی درست نیاز دارید. این مرحله معمولاً بیشترین زمان پروژه را میگیرد. همینجا هم بیشترین خطاهای پنهان ساخته میشود.
جمعآوری، آمادهسازی و انتخاب ویژگی
داده را با دقت جمعآوری کنید و از منبع و سوگیریهای احتمالی آن آگاه باشید. اگر داده از چند منبع آمده، باید یکپارچه و نرمال شود. گاهی میشود با روشهایی مثل تبدیل رشته به عدد، کیفیت داده را بالا برد.
انتخاب ویژگی هم مهم است. با انتخاب ویژگی، زیرمجموعهای از متغیرهای موجود را نگه میدارید. با استخراج ویژگی، از متغیرهای اصلی ویژگیهای تازه میسازید. هر دو برای این است که مدل با ویژگیهای مفید و کمتعداد سریعتر و دقیقتر یاد بگیرد. نمودار هم کمک میکند همبستگی یا عدم توازن داده را پیش از آموزش ببینید.
تقسیم داده به آموزش، اعتبارسنجی و آزمون
پیش از آموزش، داده را به دو یا سه بخش تقسیم کنید. همهی بخشها باید نمایندهی کل داده باشند:
- مجموعهی آموزش: بخش اصلی داده که مدل با آن یاد میگیرد.
- مجموعهی اعتبارسنجی: بخش کوچکی برای تنظیم ابرپارامترها و مقایسهی نسخهها.
- مجموعهی آزمون: بخشی که تا آخر کار دستنخورده میماند و عملکرد نهایی را میسنجد.
قانون طلایی ساده است. مدل نباید پیش از ارزیابی نهایی حتی یک بار مجموعهی آزمون را ببیند. اگر بر اساس نتیجهی آزمون مدل را تغییر دهید، آن مجموعه دیگر مستقل نیست.
بیشتر بخوانید: اگر هنوز مطمئن نیستید مسئلهی شما به یادگیری ماشین نیاز دارد یا قاعده کافی است، سیستم خبره چیست؟ را بخوانید.
مراحل سوم تا ششم؛ آموزش، ارزیابی و تنظیم مدل
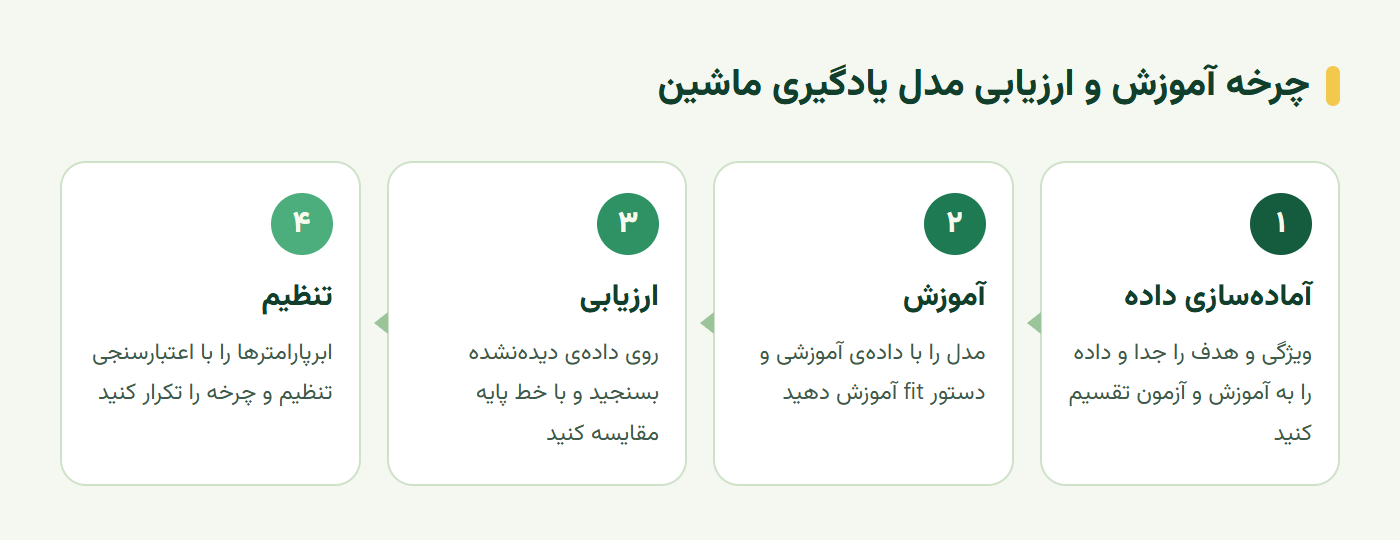
حالا داده آماده است و میتوانیم مدل بسازیم. هدف ساختن نمایشی آماری از داده است که الگوی آن را یاد بگیرد و برای نمونهی تازه پیشبینی کند. نمودار زیر چهار قدم اصلی این بخش را نشان میدهد.
انتخاب روش و آموزش مدل
بسته به سؤال و نوع داده، روش آموزش را انتخاب میکنید. مستندات scikit-learn روشهای زیادی را معرفی میکند. تجربه نشان میدهد معمولاً باید چند روش را امتحان کنید. پیشبینی اینکه کدام بهتر است، پیش از آزمایش سخت است.
در بیشتر کتابخانهها، آموزش با دستوری مثل model.fit(X, y) انجام میشود. ویژگیها و هدف را به مدل میدهید و مدل وزنهای داخلیاش را تنظیم میکند. این وزنها تعیین میکنند کدام ویژگی در پیشبینی اهمیت بیشتری دارد.
ارزیابی و خطر بیشبرازش
پس از آموزش، مدل را روی دادهی آزمون میسنجید. معیارهای ارزیابی مثل دقت، خطای میانگین یا امتیاز F1 نشان میدهند مدل چقدر خوب کار میکند. نتیجه را همیشه با یک خط پایهی ساده مقایسه کنید؛ مثلاً مدلی که همیشه پرتکرارترین برچسب را برمیگرداند.
دو مشکل رایج کیفیت مدل را پایین میآورند. در بیشبرازش، مدل دادهی آموزش را با نویز و استثناهایش حفظ کرده و روی دادهی تازه ضعیف است. در کمبرازش، مدل حتی الگوی اصلی دادهی آموزش را هم یاد نگرفته است. فاصلهی زیاد بین دقت آموزش و آزمون نشانهی بیشبرازش است.
تنظیم ابرپارامترها
ابرپارامترها تنظیماتیاند که رفتار الگوریتم آموزش را کنترل میکنند؛ مثل عمق درخت تصمیم یا تعداد همسایهها. مدل آنها را خودش یاد نمیگیرد و باید شما انتخابشان کنید.
روش درست این است که ابرپارامترها را با مجموعهی اعتبارسنجی تنظیم کنید. وقتی بهترین تنظیم را پیدا کردید، فقط یک بار روی مجموعهی آزمون ارزیابی کنید. این عدد نهایی همان چیزی است که در گزارش مینویسید.
مرحله هفتم؛ پیشبینی و یک مثال کامل
پیشبینی لحظهای است که مدل با دادهی کاملاً تازه روبهرو میشود. در محیط واقعی، این یعنی کاربر ورودی میدهد و مدل پاسخ برمیگرداند. کد زیر همهی مراحل را روی مجموعهدادهی آمادهی گل زنبق نشان میدهد.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.dummy import DummyClassifier

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

baseline = DummyClassifier(strategy="most_frequent").fit(X_train, y_train)
model = DecisionTreeClassifier(max_depth=3, random_state=42).fit(X_train, y_train)

print("baseline:", baseline.score(X_test, y_test))
print("train:", model.score(X_train, y_train), "test:", model.score(X_test, y_test))
print("prediction:", model.predict([[5.1, 3.5, 1.4, 0.2]]))
کد بالا چه چیزی را نشان میدهد؟
سه نکته در این کد هست. اول، stratify=y نسبت کلاسها را در آموزش و آزمون یکسان نگه میدارد. دوم، random_state تقسیم را قابل تکرار میکند؛ پس اجرای بعدی همان نتیجه را میدهد. سوم، مدل پایهی DummyClassifier نشان میدهد مدل اصلی واقعاً چقدر بهتر است.
مقایسهی دقت آموزش و آزمون هم نشانهی بیشبرازش را نشان میدهد. اگر max_depth را حذف کنید، دقت آموزش احتمالاً به صد درصد میرسد. اما دقت آزمون لزوماً بهتر نمیشود. این آزمایش کوچک را خودتان اجرا کنید و نتیجه را ثبت کنید.
تمرین عملی؛ نقشهی پروژه یادگیری ماشین
برای یکی از تصمیمهایی که در قسمت قبل «یادگیری» علامت زدید، این برگه را پر کنید:
- سؤال: در یک جمله بنویسید مدل دقیقاً چه چیزی را پیشبینی میکند.
- ویژگیها و هدف: ستونهای
Xو ستونyرا نام ببرید. - تقسیم داده: درصد آموزش، اعتبارسنجی و آزمون را مشخص کنید.
- خط پایه: سادهترین پیشبینی ممکن را بنویسید و عددش را حدس بزنید.
- نشانهی شکست: بنویسید چه فاصلهای بین دقت آموزش و آزمون را بیشبرازش میدانید.
این برگه نقشهی راه چند قسمت بعدی است. هر قسمت یکی از این خانهها را دقیقتر میکند.
سخن پایانی
یادگیری ماشین یعنی پیدا کردن الگو از نمونه، به جای نوشتن قاعده. یادگیری نظارتشده با نمونههای برچسبخورده کار میکند و مسیرش هفت مرحله دارد؛ از انتخاب سؤال تا پیشبینی. مهمترین این مراحل هم معمولاً مرحلهی داده است، نه انتخاب الگوریتم.
اگر فقط یک نکته از این قسمت به خاطر بسپارید، این باشد: مدل را روی دادهای بسنجید که ندیده است و همیشه با یک خط پایهی ساده مقایسه کنید. همین دو عادت جلوی بیشتر نتیجههای گمراهکننده را میگیرد.
این آموزش بر پایهی درس Techniques of Machine Learning از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
یادگیری ماشین چیست به زبان ساده؟
یادگیری ماشین روشی است که در آن به جای نوشتن قاعده، به کامپیوتر نمونه نشان میدهیم تا الگو را خودش پیدا کند. نتیجهی این یادگیری یک مدل است که میتواند برای ورودی تازه پیشبینی کند.
یادگیری نظارتشده چیست؟
در یادگیری نظارتشده هر نمونهی آموزشی یک پاسخ درست یا برچسب دارد؛ مثلاً ایمیل همراه با برچسب «اسپم» یا «عادی». مدل رابطهی ویژگیها و برچسب را یاد میگیرد تا برای نمونهی تازه برچسب را پیشبینی کند.
بیشبرازش چیست؟
بیشبرازش یعنی مدل دادهی آموزشی را بیش از حد دقیق حفظ کرده، حتی نویز و استثناهایش را. چنین مدلی روی دادهی آموزش عالی است اما روی دادهی تازه ضعیف عمل میکند. کمبرازش برعکس است؛ مدل حتی الگوی اصلی دادهی آموزش را هم یاد نگرفته است.
چرا داده را به آموزش و آزمون تقسیم میکنیم؟
چون مدل باید روی دادهای سنجیده شود که هنگام آموزش ندیده است. اگر با همان دادهی آموزشی ارزیابی کنیم، نتیجه بیش از حد خوشبینانه میشود. مجموعهی اعتبارسنجی هم برای تنظیم ابرپارامترها کنار گذاشته میشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.