
سوگیری در هوش مصنوعی معمولاً در میانگینها پنهان میشود. مدلی که دقت کلیاش ۹۰ درصد است، ممکن است برای گروه کوچکی از کاربران فقط ۶۰ درصد درست کار کند. تا وقتی نتیجه را به تفکیک گروه نبینید، این ضعف دیده نمیشود. آن گروه هم هرگز به محصول اعتماد نمیکند.
در قسمت قبل یاد گرفتیم هر عدد ارزیابی را با عدم قطعیتش گزارش کنیم. حالا یک قدم جلوتر میرویم و میپرسیم این عدد برای چه کسی است. در این قسمت انواع آسیب ناعادلانه و اصول هوش مصنوعی مسئولانه را مرور میکنیم. بعد با یک مثال پایتون، ارزیابی تفکیکی را قدمبهقدم انجام میدهیم.
سوگیری در هوش مصنوعی از کجا میآید؟
یادگیری ماشین امروز روی تصمیمهای مهمی اثر میگذارد؛ از تشخیص پزشکی تا کشف تقلب و اعطای وام. این مدلها از دادهی تاریخی یاد میگیرند. اگر داده گروهی از افراد را کم داشته باشد یا تبعیض گذشته را در خود داشته باشد، مدل هم همان را تکرار میکند.
تصور کنید دادهی آموزشی یک دستیار صوتی بیشتر از گویندگان تهرانی جمع شده است. مدل لهجهی تهرانی را خوب میفهمد، اما در لهجههای دیگر خطای بیشتری دارد. هیچکس عمداً این سوگیری را نساخته است. اما نتیجه برای کاربر شیرازی یا تبریزی همان است؛ محصولی که او را نمیفهمد.
سه منبع اصلی سوگیری
اولین منبع، دادهی نامتوازن است. وقتی یک گروه در داده کم است، مدل الگوی آن گروه را خوب یاد نمیگیرد. دومین منبع، برچسبگذاری است. اگر برچسبها از تصمیمهای مغرضانهی گذشته آمده باشند، مدل همان سوگیری را یاد میگیرد.
منبع سوم تعریف مسئله است. گاهی خود هدف پیشبینی ناعادلانه انتخاب میشود. مثلاً اگر «هزینهی درمان گذشته» جانشین «نیاز درمانی» شود، گروههایی که دسترسی کمتری به درمان داشتهاند، کمنیازتر دیده میشوند. هر سه منبع را باید پیش از آموزش بررسی کرد.
پنج نوع آسیب ناعادلانه
بیعدالتی در هوش مصنوعی یعنی اثر منفی یا آسیب بر گروهی از افراد؛ مثلاً گروههایی که با سن، جنسیت، زبان یا معلولیت تعریف میشوند. این آسیبها چند شکل رایج دارند. جدول زیر آنها را با مثال نشان میدهد.
| نوع آسیب | توضیح | مثال |
|---|---|---|
| تخصیص | منابع یا فرصتها ناعادلانه تقسیم میشوند | رد بیشتر درخواست وام یک گروه |
| کیفیت خدمات | سیستم برای یک گروه ضعیفتر کار میکند | تشخیص گفتار ضعیف برای یک لهجه |
| برچسب ناعادلانه | برچسب نادرست یا توهینآمیز به افراد | برچسبگذاری غلط تصویر افراد با پوست تیره |
| نمایش کمتر یا بیشتر | گروهی در نتیجهها دیده نمیشود | نشان ندادن زنان در جستجوی یک شغل |
| کلیشهسازی | نسبت دادن ویژگی پیشفرض به یک گروه | ترجمهی «او پرستار است» به ضمیر مؤنث |
کیفیت خدمات؛ رایجترین آسیب در دستیارها
برای سازندهی دستیار، آسیب کیفیت خدمات رایجترین مشکل است. نمونهی مشهورش دستگاه صابونریز خودکاری بود که دست افراد با پوست تیره را تشخیص نمیداد. حسگر آن فقط با نمونههای محدودی آزمون شده بود.
در دستیار آموزشی ما، این آسیب میتواند به شکل پاسخ ضعیفتر به پرسشهایی با غلط املایی باشد. یا پرسشهایی که با کلمات محاورهای نوشته شدهاند. کاربرانی که رسمی نمینویسند، بیآنکه کسی بفهمد، خدمات بدتری میگیرند.
کلیشهسازی در ترجمه و تولید متن
کلیشهسازی در مدلهای زبانی بسیار دیده میشود. ترکی، مثل فارسی، ضمیر جنسیتی ندارد. وقتی جملهی «او پرستار است و او پزشک است» از ترکی به انگلیسی ترجمه میشد، سیستم پرستار را زن و پزشک را مرد فرض میکرد.
این رفتار از الگوی دادهی آموزشی آمده است، نه از قاعدهای که کسی نوشته باشد. در فارسی هم وقتی از مدل میخواهید برای «یک مهندس» داستان بنویسد، به جنسیت فرضی شخصیت دقت کنید. آزمون چنین مواردی باید بخشی از مجموعهی ارزیابی شما باشد.
بیشتر بخوانید: برای گزارش درست هر عدد ارزیابی با بازهی اطمینان، آمار و احتمال برای هوش مصنوعی را بخوانید.
شش اصل هوش مصنوعی مسئولانه
مایکروسافت و بسیاری از سازمانهای دیگر شش اصل برای هوش مصنوعی مسئولانه تعریف کردهاند. انصاف فقط یکی از آنهاست، اما بقیه هم به آن گره خوردهاند. این اصول چارچوبی برای پرسیدن سؤالهای درست پیش از استقرار مدلاند.
انصاف، اطمینان و فراگیری
انصاف یعنی سیستم با همهی گروههای مشابه به یک شکل رفتار کند. قابلیت اطمینان و ایمنی یعنی سیستم در شرایط عادی و غیرعادی رفتار قابل پیشبینی داشته باشد. باید بدانیم مدل در موقعیتهای مرزی و دادهی پرت چه میکند.
فراگیری یعنی سیستم برای همه، از جمله افراد دارای معلولیت، قابل استفاده باشد. دستیاری که فقط با تایپ کار میکند، کاربر نابینا را کنار میگذارد. طراحی فراگیر از ابتدا ارزانتر از اصلاح بعدی است.
حریم خصوصی، شفافیت و پاسخگویی
حریم خصوصی و امنیت یعنی دادهی شخصی محافظت شود و بیاجازه استفاده نشود. مقرراتی مثل GDPR در اروپا این را الزامی کردهاند. در عین حال، تنشی واقعی وجود دارد؛ سیستم شخصیتر به دادهی شخصی بیشتری نیاز دارد.
شفافیت یعنی رفتار سیستم قابل فهم و توضیح باشد. پاسخگویی هم یعنی سازندگان سیستم مسئول نتیجهی آناند. «مدل اینطور تصمیم گرفت» پاسخ قابل قبولی برای کاربری که آسیب دیده نیست. کسی باید مسئولیت را بپذیرد و راه اعتراض وجود داشته باشد.
ارزیابی تفکیکی؛ سنجش دقت برای هر گروه
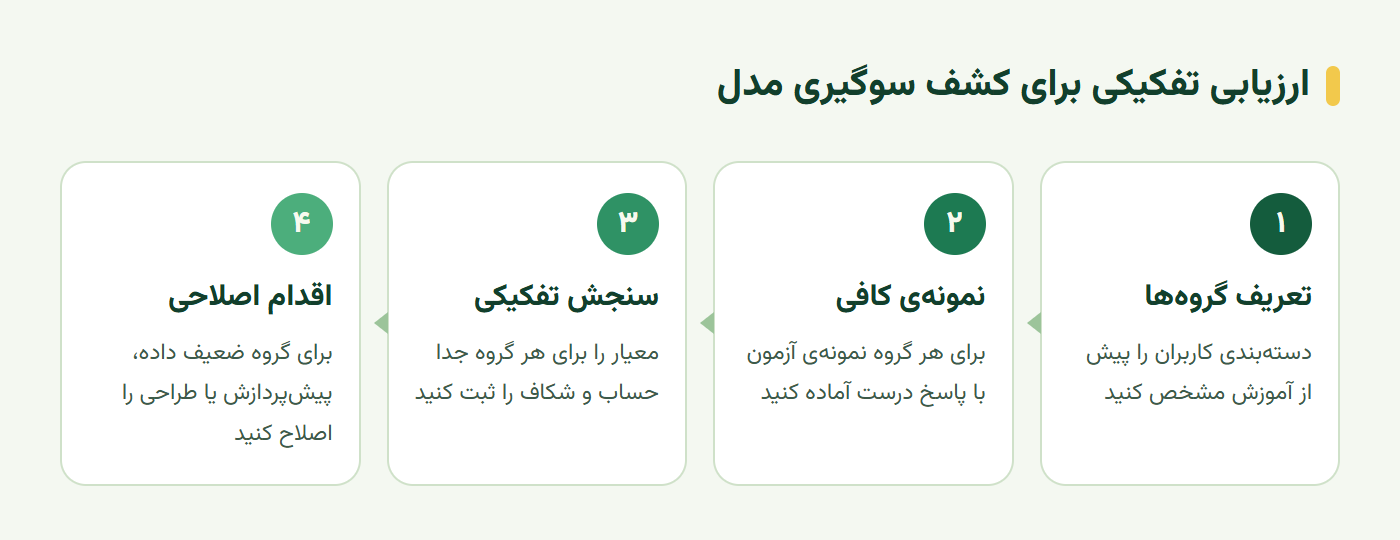
حالا به بخش عملی میرسیم. سادهترین و مؤثرترین ابزار کشف سوگیری، ارزیابی تفکیکی است. به جای یک عدد کلی، معیار ارزیابی را برای هر گروه جداگانه حساب میکنیم. نمودار زیر چهار قدم این کار را نشان میدهد.
یک مثال پایتون با pandas
فرض کنید دستیار آموزشی ما موضوع پرسش کاربران را تشخیص میدهد. برای هر نمونهی آزمون، برچسب درست، پیشبینی مدل و نوع نگارش پرسش را داریم. کد زیر دقت را به تفکیک گروه حساب میکند:
import pandas as pd

df = pd.DataFrame({
    "group": ["formal"] * 6 + ["informal"] * 4,
    "label": ["pay", "reg", "reg", "pay", "cert", "reg", "pay", "reg", "cert", "pay"],
    "pred":  ["pay", "reg", "reg", "pay", "cert", "reg", "reg", "reg", "pay", "reg"],
})
df["correct"] = df["label"] == df["pred"]

print("overall:", df["correct"].mean())
report = df.groupby("group")["correct"].agg(accuracy="mean", n="size")
print(report)
print("gap:", report["accuracy"].max() - report["accuracy"].min())
در این دادهی ساختگی، دقت کلی ۷۰ درصد است. اما دقت پرسشهای رسمی ۱۰۰ درصد و محاورهای فقط ۲۵ درصد است. عدد کلی این شکاف بزرگ را کاملاً پنهان کرده بود.
تفسیر نتیجه و حجم نمونه
به ستون n دقت کنید. گروه محاورهای فقط چهار نمونه دارد. همانطور که در قسمت قبل دیدیم، بازهی اطمینان با چهار نمونه بسیار پهن است. پس نتیجهی قطعی نمیگیرید، اما هشدار جدی میگیرید.
قدم درست بعدی جمعآوری نمونهی بیشتر از گروه ضعیف است. هم برای ارزیابی دقیقتر و هم برای آموزش. برای پروژههای جدیتر، کتابخانهی Fairlearn معیارهای انصاف را آماده دارد و نمودار مقایسهی گروهها را هم میسازد.
ارزیابی تأثیر پیش از آموزش مدل
بهترین زمان برای پیدا کردن سوگیری، پیش از آموزش مدل است. ارزیابی تأثیر سندی است که هدف سیستم، نحوهی استفاده، محل استقرار و افراد متأثر از آن را مشخص میکند. این سند برای بازبینان و ذینفعان مفید است.
چهار بخش ارزیابی تأثیر
یک ارزیابی تأثیر ساده چهار بخش دارد:
- اثر منفی بر افراد: محدودیتها، استفادههای نادرست احتمالی و گروههایی که ممکن است آسیب ببینند.
- نیازهای داده: سیستم کجا و چطور از داده استفاده میکند و چه مقرراتی باید رعایت شود.
- خلاصهی آسیبها: فهرست آسیبهای احتمالی که در طول چرخهی عمر مدل بازبینی میشود.
- هدف هر اصل: برای هرکدام از شش اصل، هدف مشخص و شکافهای موجود.
این سند یکباره نوشته نمیشود. با هر نسخهی تازهی مدل و هر گروه تازهی کاربران، باید دوباره بازبینی شود.
گروهها را از روز اول تعریف کنید
یک اشتباه رایج این است که ستونهای جنسیت، سن یا منطقه را برای «منصف بودن» حذف کنیم. اما ویژگیهای دیگری مثل نام یا محله میتوانند جانشین همان اطلاعات شوند. بهعلاوه، بدون این ستونها نمیتوانید ارزیابی تفکیکی انجام دهید.
راه بهتر این است که گروهها را از ابتدا تعریف کنید و ستونشان را برای ارزیابی نگه دارید. حتی اگر در آموزش استفاده نشود. البته این داده را با رعایت حریم خصوصی و با رضایت کاربر جمع کنید.
تمرین عملی؛ جدول ارزیابی تفکیکی
برای مدل یا دستیاری که در قسمتهای قبل طراحی کردید، این تمرین را انجام دهید:
- گروهها: دستکم دو دستهبندی از کاربران تعریف کنید؛ مثلاً نوع نگارش و دستگاه.
- نمونهی آزمون: برای هر گروه دستکم بیست نمونه با پاسخ درست آماده کنید.
- معیار: دقت یا معیار اصلی را برای هر گروه جداگانه حساب کنید.
- شکاف: بیشترین اختلاف بین گروهها را بنویسید و آستانهی قابل قبول را پیش از اجرا تعیین کنید.
- اقدام: برای گروه ضعیف یک راهحل مشخص بنویسید؛ دادهی بیشتر، پیشپردازش یا تغییر طراحی.
این جدول را در هر نسخهی تازه دوباره پر کنید. بهتر شدن میانگین به قیمت بدتر شدن یک گروه، پیشرفت نیست.
سخن پایانی
سوگیری در هوش مصنوعی معمولاً عمدی نیست. از دادهی نامتوازن، برچسبگذاری مغرضانه یا تعریف نادرست مسئله میآید. آسیبش هم میتواند تخصیص ناعادلانه، خدمات ضعیفتر، برچسب نادرست، نمایش ناکافی یا کلیشهسازی باشد.
راه عملی مقابله با آن ساده است. گروهها را از ابتدا تعریف کنید، معیار را به تفکیک هر گروه بسنجید و ارزیابی تأثیر را با هر نسخه بهروز کنید. مدلی که فقط در میانگین خوب است، هنوز آمادهی استقرار نیست.
این آموزش بر پایهی درس Fairness in Machine Learning از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
سوگیری در هوش مصنوعی چیست؟
سوگیری یعنی مدل برای یک گروه از افراد بهطور سیستماتیک نتیجهی بدتر یا متفاوتی میدهد؛ مثلاً تشخیص گفتار برای یک لهجه دقت کمتری دارد. سوگیری معمولاً از دادهی آموزشی نامتوازن، برچسبگذاری ناعادلانه یا تعریف نادرست مسئله میآید.
چطور سوگیری مدل را اندازه بگیریم؟
به جای یک عدد کلی، معیار ارزیابی را برای هر گروه جداگانه حساب کنید. اگر دقت کلی ۹۰ درصد است اما برای یک گروه ۷۰ درصد، مدل برای آن گروه کیفیت خدمات ضعیفی دارد. کتابخانههایی مثل Fairlearn این کار را سادهتر میکنند.
شش اصل هوش مصنوعی مسئولانه کداماند؟
انصاف، قابلیت اطمینان و ایمنی، فراگیری، حریم خصوصی و امنیت، شفافیت و پاسخگویی. این اصول چارچوبی برای طراحی، آزمون و استقرار سیستمهایی است که با همه عادلانه رفتار کنند و قابل اعتماد باشند.
آیا حذف ستون جنسیت یا سن سوگیری را از بین میبرد؟
معمولاً نه. ویژگیهای دیگری مثل محله، نام یا سابقهی خرید میتوانند جانشین همان اطلاعات شوند. بهعلاوه بدون آن ستونها نمیتوانید ارزیابی تفکیکی انجام دهید. بهتر است ستون گروه را برای ارزیابی نگه دارید، حتی اگر در آموزش استفاده نشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.