
شبکه عصبی چیست و چرا تقریباً همهی موفقیتهای امروز هوش مصنوعی به آن برمیگردد؟ پاسخ در یک ایدهی ساده است: مدلی بسازیم که اشتباه کند، اندازهی اشتباهش را بسنجیم و وزنهایش را کمی اصلاح کنیم. اگر این کار را هزاران بار تکرار کنیم، مدل الگو را یاد میگیرد.
در قسمت اول دیدیم رویکرد پایین به بالا ساختار مغز را مدل میکند. حالا سراغ ریاضیات همین رویکرد میرویم. از سادهترین شبکه یعنی پرسپترون شروع میکنیم و قدمبهقدم به شبکهی چندلایه و پسانتشار خطا میرسیم. نگران فرمولها نباشید؛ هر فرمول را با یک مثال عددی توضیح میدهیم.
پرسپترون؛ اولین شبکه عصبی تاریخ
در سال ۱۹۵۷، فرانک روزنبلات در آزمایشگاه هوانوردی کرنل ماشینی به نام پرسپترون ساخت. این ماشین سختافزاری بود و میتوانست تصویرهای سادهای مثل مثلث، مربع و دایره را از هم تشخیص دهد. تصویر ورودی با آرایهای از ۲۰ در ۲۰ سلول نوری ثبت میشد.
پس شبکه ۴۰۰ ورودی و یک خروجی دودویی داشت. وزنها با پتانسیومترهایی تنظیم میشدند که در طول آموزش با موتور الکتریکی میچرخیدند. روزنامهی نیویورک تایمز آن زمان نوشت این دستگاه روزی راه میرود، حرف میزند و از وجود خودش آگاه میشود. این پیشبینی خیلی زود بود، اما ایدهی اصلی تا امروز زنده مانده است.
مدل ریاضی پرسپترون
فرض کنید هر نمونه N ویژگی دارد. پس ورودی برداری به طول N است که آن را x مینامیم. پرسپترون یک مدل دستهبندی دودویی است؛ یعنی بین دو کلاس تصمیم میگیرد. خروجی را برای یک کلاس ۱ و برای کلاس دیگر ۱- در نظر میگیریم.
پرسپترون هر ویژگی را در یک وزن ضرب میکند و همه را با هم جمع میکند. اگر حاصل مثبت بود، خروجی ۱ است و اگر منفی بود، ۱-. به زبان ریاضی، خروجی برابر است با f(w·x) که در آن f تابع پله است. مثلاً اگر وزنها ۰٫۵ و ۱- و ورودی ۲ و ۰٫۵ باشد، حاصل ۰٫۵ است و خروجی ۱ میشود.
پرسپترون چطور یاد میگیرد؟
برای آموزش پرسپترون، باید وزنهایی پیدا کنیم که بیشترین نمونهها را درست دستهبندی کنند. قاعدهی یادگیری ساده است. نمونهای را برمیداریم که اشتباه دستهبندی شده است. اگر نمونه مثبت بوده، ورودی را به وزنها اضافه میکنیم. اگر منفی بوده، ورودی را از وزنها کم میکنیم.
این کار وزنها را کمی به سمت پاسخ درست میبرد. با تکرار روی نمونههای زیاد، خط جداکنندهی دو کلاس جا میافتد. محدودیت مهم پرسپترون همینجاست. فقط کلاسهایی را جدا میکند که با یک خط راست قابل تفکیکاند.
تابع خطا؛ مدل چقدر اشتباه میکند؟
برای بهبود هر مدل، اول باید اشتباهش را با یک عدد بسنجیم. به این عدد خطا یا زیان میگوییم. هدف آموزش کمینه کردن همین عدد است. انتخاب تابع خطا به نوع مسئله بستگی دارد.
خطا در رگرسیون و دستهبندی
فرض کنید دادهی آموزشی X با برچسبهای Y داریم و مدل f پیشبینی میکند. در مسئلهی رگرسیون که عدد پیشبینی میکنیم، خطای مطلق یا خطای مربعی رایج است. خطای مربعی مجموع مربع فاصلهی پیشبینی با پاسخ درست است. مثلاً اگر قیمت واقعی ۱۰ و پیشبینی ۱۳ باشد، خطای مربعی ۹ است.
در دستهبندی، سادهترین معیار خطای صفر و یک است که عملاً همان دقت مدل است. اما برای آموزش، خطای لجستیک یا آنتروپی متقاطع مناسبتر است. چون پیوسته است و میشود از آن مشتق گرفت. برای اینکه خروجی شبکه احتمال باشد، معمولاً از تابع softmax استفاده میکنیم.
پارامترها و هدف آموزش
در مدل خطی f(x) = wx + b، ماتریس w وزنها و بردار b بایاس است. به این دو، پارامترهای مدل میگوییم. با داشتن کل دادهی آموزشی، خطای کل تابعی از همین پارامترهاست.
پس هدف آموزش شبکهی عصبی را میشود در یک جمله گفت: پارامترها را طوری تغییر بده که خطای کل کم شود. سؤال این است که از کجا بدانیم هر پارامتر را به کدام سمت و چقدر تغییر دهیم. پاسخ این سؤال نزول گرادیان است.
بیشتر بخوانید: اگر هنوز مفهوم ویژگی، هدف و تقسیم داده به آموزش و آزمون برایتان روشن نیست، یادگیری ماشین چیست؟ را بخوانید.
نزول گرادیان؛ پایین رفتن از تپه خطا
تصور کنید در مه غلیظ روی یک تپه ایستادهاید و میخواهید به پایینترین نقطه برسید. جایی را نمیبینید، اما شیب زیر پایتان را حس میکنید. پس یک قدم در جهت سراشیبی برمیدارید و دوباره شیب را حس میکنید. نزول گرادیان دقیقاً همین کار را با تابع خطا میکند.
قاعدهی بهروزرسانی و نرخ یادگیری
گرادیان همان شیب تابع خطا نسبت به هر پارامتر است. الگوریتم اینطور کار میکند. اول پارامترها را با مقدار تصادفی شروع میکنیم. بعد در هر قدم، هر وزن را به اندازهی نرخ یادگیری ضرب در گرادیان، در جهت مخالف گرادیان تغییر میدهیم.
نرخ یادگیری که با η نشان داده میشود، اندازهی قدم است. اگر خیلی بزرگ باشد، از روی دره میپرید و خطا بالا و پایین میرود. اگر خیلی کوچک باشد، آموزش بسیار کند میشود. مثلاً اگر وزن ۲ باشد، گرادیان ۴ و نرخ یادگیری ۰٫۱، وزن تازه ۱٫۶ میشود.
نزول گرادیان تصادفی و مینیبچ
در نسخهی کامل، گرادیان روی کل داده حساب میشود. اما وقتی داده میلیونها نمونه دارد، این کار بسیار کند است. به همین دلیل در عمل از زیرمجموعههای کوچکی به نام مینیبچ استفاده میکنیم.
در هر قدم، گرادیان فقط روی چند ده نمونه حساب میشود. به این روش نزول گرادیان تصادفی میگویند. گرادیان هر مینیبچ کمی نویز دارد، اما جهت کلی درست است. این نویز حتی گاهی کمک میکند مدل از کمینههای محلی بد فرار کند.
شبکه چندلایه و پسانتشار خطا
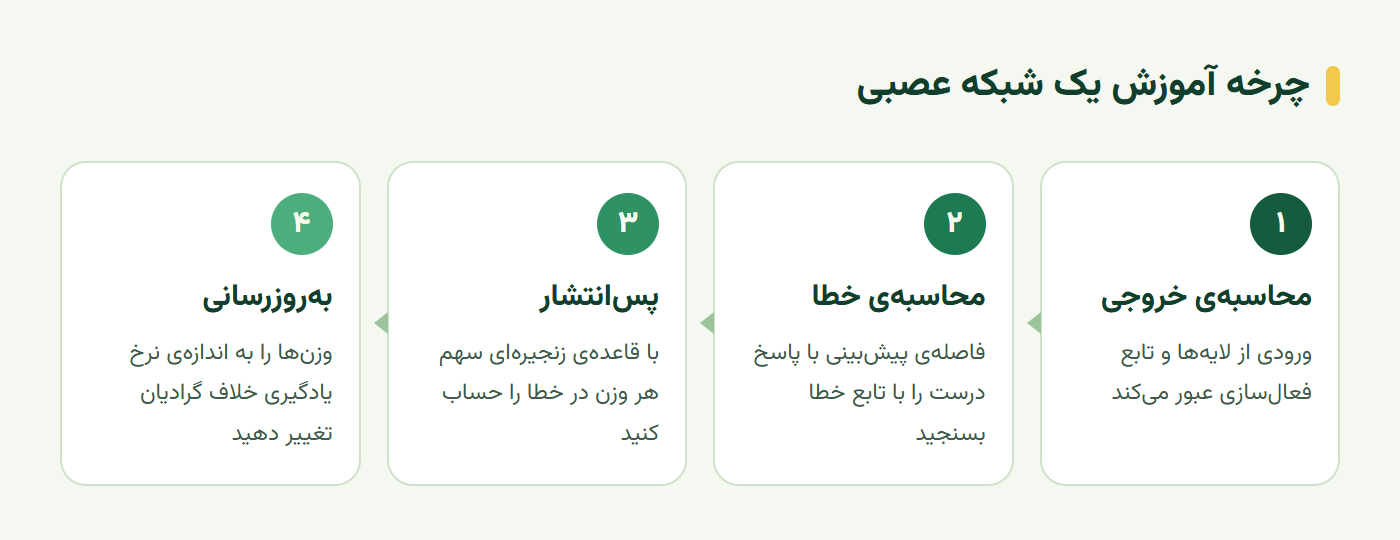
پرسپترون تکلایه فقط کلاسهای خطیتفکیکپذیر را جدا میکند. مسئلهی معروف XOR را در نظر بگیرید که هیچ خط راستی نمیتواند نقطههایش را جدا کند. برای حل چنین مسئلههایی، باید چند لایه را روی هم بگذاریم. نمودار زیر چرخهی آموزش یک شبکهی چندلایه را نشان میدهد.
چرا تابع فعالسازی غیرخطی لازم است؟
در شبکهی دولایه، ورودی اول از لایهی اول عبور میکند. حاصل از یک تابع فعالسازی غیرخطی مثل ReLU یا tanh میگذرد. بعد وارد لایهی دوم میشود و در پایان softmax احتمال کلاسها را میدهد.
تابع غیرخطی قلب ماجراست. اگر آن را حذف کنید، دو لایهی خطی پشت سر هم باز هم یک تابع خطیاند. در آن صورت شبکه هیچ قدرت بیشتری از پرسپترون ندارد. تابع غیرخطی به شبکه اجازه میدهد مرزهای خمیده و پیچیده بسازد.
پسانتشار با قاعدهی زنجیرهای
در شبکهی چندلایه، الگوریتم نزول گرادیان همان است. اما محاسبهی گرادیان سختتر میشود، چون وزن لایهی اول از مسیر طولانیتری روی خطا اثر میگذارد. راهحل، قاعدهی زنجیرهای مشتق است. مشتق خطا نسبت به هر وزن، حاصل ضرب مشتقهای مسیر از خطا تا آن وزن است.
نکتهی هوشمندانه اینجاست. بخش اول این حاصلضرب برای همهی وزنها یکسان است. پس محاسبه را از خطا شروع میکنیم و لایهبهلایه به عقب میرویم. به همین دلیل به این روش پسانتشار خطا میگویند. کتابخانههایی مثل PyTorch این کار را خودکار انجام میدهند، اما دانستن سازوکارش در عیبیابی بسیار کمک میکند.
ساخت پرسپترون با پایتون از صفر
حالا همهی این ایدهها را در کد کوچکی کنار هم میگذاریم. دادهی ساختگی دو کلاس دارد که با یک خط جدا میشوند. بایاس را هم بهصورت یک ورودی ثابت ۱ به هر نمونه اضافه کردهایم.
import numpy as np
rng = np.random.default_rng(0)
pos = rng.normal([2, 2], 0.5, size=(50, 2))
neg = rng.normal([-2, -2], 0.5, size=(50, 2))
X = np.vstack([pos, neg])
X = np.hstack([X, np.ones((100, 1))]) # ستون بایاس
t = np.array([1] * 50 + [-1] * 50)
w = np.zeros(3)
for epoch in range(20):
errors = 0
for xi, ti in zip(X, t):
if ti * (w @ xi) <= 0: # نمونه اشتباه دستهبندی شده
w += ti * xi # قاعدهی یادگیری پرسپترون
errors += 1
if errors == 0:
break
accuracy = np.mean(np.sign(X @ w) == t)
print("epochs:", epoch + 1, "weights:", w.round(2), "accuracy:", accuracy)از این کد چه یاد میگیریم؟
شرط ti * (w @ xi) <= 0 یعنی علامت پیشبینی با برچسب یکی نیست. در این حالت، ورودی با علامت برچسب به وزنها اضافه میشود. این همان قاعدهای است که بالاتر گفتیم؛ فقط برای مثبت و منفی در یک خط نوشته شده است.
حلقه وقتی تمام میشود که در یک دور کامل هیچ خطایی نباشد. روی این دادهی جداپذیر، معمولاً چند دور کافی است. حالا یک آزمایش انجام دهید: نقطههای دو کلاس را به هم نزدیک کنید تا همپوشانی داشته باشند. میبینید که حلقه هیچوقت به خطای صفر نمیرسد. این همان محدودیت پرسپترون است.
تمرین عملی؛ آزمایش با نرخ یادگیری
برای درک عمیقتر، این سه آزمایش را روی کد بالا یا نسخهی گرادیانی آن انجام دهید و نتیجه را یادداشت کنید:
- دادهی همپوشان: مرکز دو کلاس را به نقطههای نزدیکتر ببرید و تعداد خطاها را در هر دور ثبت کنید.
- دادهی XOR: چهار نقطهی XOR را بسازید و ببینید پرسپترون به چه دقتی میرسد.
- نرخ یادگیری: در نسخهی گرادیانی، نرخ یادگیری را ۰٫۰۰۱، ۰٫۱ و ۱۰ بگذارید و نمودار خطا را مقایسه کنید.
پیش از اجرای هر آزمایش، نتیجهای را که انتظار دارید بنویسید. بعد با نتیجهی واقعی مقایسه کنید. این عادت همان نگاه آزمایشی است که در قسمتهای قبل از آن حرف زدیم.
سخن پایانی
شبکهی عصبی از یک ایدهی ساده ساخته شده است؛ جمع وزندار ورودیها، یک تابع فعالسازی و اصلاح تدریجی وزنها. پرسپترون نقطهی شروع بود و فقط مرزهای خطی را یاد میگرفت. تابع خطا اشتباه را به عدد تبدیل میکند و نزول گرادیان آن عدد را قدمبهقدم کم میکند.
شبکهی چندلایه با تابع فعالسازی غیرخطی مرزهای پیچیده را هم یاد میگیرد و پسانتشار آموزش آن را ممکن میکند. هر مدل بزرگی که امروز میبینید، از مدلهای بینایی تا مدلهای زبانی، روی همین چند ایده ساخته شده است.
این آموزش بر پایهی درسهای Perceptron و Multi-Layered Perceptron از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
شبکه عصبی چیست به زبان ساده؟
شبکه عصبی مصنوعی مدلی است که از تعداد زیادی واحد ساده به نام نورون ساخته شده است. هر نورون ورودیهایش را با وزنهایی جمع میکند و از یک تابع فعالسازی عبور میدهد. شبکه با تنظیم تدریجی این وزنها بر اساس خطا، الگوی داده را یاد میگیرد.
پرسپترون چیست؟
پرسپترون سادهترین شبکه عصبی است که فرانک روزنبلات در سال ۱۹۵۷ ساخت. یک نورون دارد که جمع وزندار ورودیها را حساب میکند و اگر مثبت بود خروجی یک و در غیر این صورت منفی یک میدهد. فقط میتواند دو کلاسی را جدا کند که با یک خط راست تفکیکپذیرند.
نزول گرادیان چیست؟
روشی برای کم کردن خطای مدل است. شیب تابع خطا را نسبت به هر وزن حساب میکنیم و وزن را کمی در جهت مخالف شیب تغییر میدهیم. اندازهی این قدم را نرخ یادگیری تعیین میکند و این کار بارها تکرار میشود تا خطا کم شود.
پسانتشار خطا چیست؟
پسانتشار روشی برای محاسبهی کارآمد گرادیان در شبکهی چندلایه است. با قاعدهی زنجیرهای مشتق، خطا از لایهی خروجی به عقب و لایهبهلایه پخش میشود تا سهم هر وزن در خطا معلوم شود. بدون آن آموزش شبکههای عمیق عملاً ممکن نبود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.