
اخلاق داده امروز دیگر موضوعی فلسفی و دور از کد نیست. هر بار که فرمی طراحی میکنید، لاگی ذخیره میکنید یا مدلی را با پیامهای کاربران آموزش میدهید، یک تصمیم اخلاقی میگیرید. سؤال این است که این تصمیم را آگاهانه میگیرید یا نه.
همهی ما شهروندان دنیای دادهمحوریم. حجم دادهای که هر سال تولید میشود به صدها زتابایت رسیده است. این داده فرصت بزرگی برای ساختن محصولات هوشمند است، اما مسئولیت بزرگی هم میآورد. در قسمت قبل چرخهی عمر پروژهی داده را دیدیم. حالا میپرسیم در هر مرحلهی این چرخه، چه چیزی میتواند به کاربر آسیب بزند.
اخلاق داده چیست؟ چهار تعریف پایه
کلمهی اخلاق یا Ethics از واژهی یونانی ethikos به معنای منش و طبیعت اخلاقی آمده است. اخلاق دربارهی ارزشها و اصول مشترکی است که رفتار ما را در جامعه هدایت میکند. اخلاق بر قانون تکیه ندارد، بلکه بر هنجارهای پذیرفتهشده دربارهی درست و نادرست تکیه دارد.
از اخلاق تا فرهنگ اخلاقی
برای کار با داده، چهار مفهوم را باید از هم جدا کرد:
- اخلاق: ارزشها و اصول مشترکی که رفتار درست را تعریف میکنند.
- اخلاق داده: شاخهای تازه که مسائل اخلاقی داده، الگوریتم و شیوههای مرتبط را بررسی میکند.
- اخلاق کاربردی: بهکارگیری عملی ملاحظات اخلاقی در محصولات و فرایندهای واقعی.
- فرهنگ اخلاقی: نهادینه کردن اخلاق کاربردی در سازمان تا در همهی تیمها رعایت شود.
تفاوت سه مورد آخر مهم است. نوشتن یک بیانیهی اخلاقی آسان است. اما تا وقتی تیمها در کار روزمره آن را به کار نبرند، اثری ندارد. فرهنگ اخلاقی یعنی سؤالهای اخلاقی بخشی از بازبینی کد و طراحی محصول باشند.
اصول اخلاقی؛ نقطهی شروع هر راهبرد
هر راهبرد اخلاق داده با تعریف اصول شروع میشود. این اصول ارزشهاییاند که رفتار قابل قبول را توصیف میکنند. بسیاری از سازمانها اصول خود را منتشر کردهاند. نمونهاش اصول هوش مصنوعی مسئولانهی مایکروسافت است.
در این چارچوب، شفافیت و پاسخگویی پایهاند و بقیهی اصول روی آنها ساخته میشوند. انصاف، قابلیت اطمینان، حریم خصوصی و فراگیری چهار اصل دیگرند. این اصول را در قسمت سوگیری با جزئیات دیدیم. اینجا روی چالشهایی تمرکز میکنیم که مخصوص خود دادهاند.
ده چالش اخلاقی در کار با داده
وقتی اصول تعریف شد، قدم بعد این است که کارهای واقعی را با آنها بسنجیم. این کارها در دو گروه جا میگیرند. گروه اول جمعآوری داده است که معمولاً شامل دادهی شخصی افراد میشود. گروه دوم طراحی الگوریتم است؛ یعنی ساخت مجموعهداده و آموزش مدل.
مالکیت، رضایت و مالکیت معنوی
اولین سؤال مالکیت داده است. مالک داده کیست؛ کاربر یا سازمان؟ کاربر چه حقوقی دارد؛ دسترسی، حذف یا انتقال؟ این سؤالها باید پیش از جمعآوری پاسخ داشته باشند، نه بعد از اولین شکایت.
دومین سؤال رضایت آگاهانه است. کاربر باید با فهم کامل هدف، خطرها و جایگزینها اجازه دهد. سؤال سوم مالکیت معنوی است. آیا دادهای که کاربر فرستاده، مثلاً یک متن یا عکس، ارزش اقتصادی دارد؟ اگر بله، چه کسی مالک آن ارزش است؟
حریم خصوصی و حق فراموش شدن
حریم خصوصی داده یعنی از هویت کاربر در برابر افشا محافظت شود. آیا داده در برابر هک و نشت محافظت شده است؟ آیا فقط افراد مجاز به آن دسترسی دارند؟ آیا در انتشار داده، ناشناس بودن کاربر حفظ میشود؟ و مهمتر از همه، آیا میشود کاربر را از دادهی ناشناس دوباره شناسایی کرد؟
حق فراموش شدن یا حق حذف، لایهی دیگری از حفاظت است. کاربر میتواند از سازمان بخواهد دادهاش را حذف کند. سیستم باید این امکان را داشته باشد. پس گرفتن رضایت هم باید حذف خودکار را فعال کند. این کار در سیستمی که داده را در ده جای مختلف کپی کرده، بسیار سخت است.
سوگیری، کیفیت و انصاف الگوریتمی
سوگیری مجموعهداده یعنی زیرمجموعهای غیرنماینده از جمعیت انتخاب شده باشد. کیفیت داده هم میپرسد آیا ویژگیها معتبرند و داده برای شرایط مختلف کامل است. انصاف الگوریتمی هم بررسی میکند که آیا مدل بهطور سیستماتیک علیه یک گروه عمل میکند یا نه.
این سه چالش به هم گره خوردهاند. دادهی ناقص معمولاً به سوگیری میرسد و سوگیری به نتیجهی ناعادلانه. راه تشخیصش هم همان ارزیابی تفکیکی است که در قسمت هشتم دیدیم.
بیشتر بخوانید: روش سنجش دقت مدل به تفکیک گروه کاربران را با کد پایتون در سوگیری در هوش مصنوعی توضیح دادهایم.
گزارش نادرست و توهم انتخاب
دو چالش آخر به ارتباط با کاربر و تصمیمگیرنده مربوطاند. گزارش نادرست یعنی بینش داده را گمراهکننده نشان دهیم. مثلاً محور نمودار را طوری بچینیم که تغییر کوچک بزرگ دیده شود. یا فقط نتیجههایی را گزارش کنیم که فرضیهی ما را تأیید میکنند.
توهم انتخاب آزاد وقتی رخ میدهد که طراحی سیستم کاربر را به سمت گزینهی خاصی هل بدهد. کاربر فکر میکند خودش انتخاب کرده است. به این الگوها «الگوی تاریک» میگویند. مثلاً دکمهی «موافقم» بزرگ و سبز است و «مخالفم» کوچک و خاکستری. پرسش اخلاقی این است که آیا کاربر پیامد انتخابش را فهمید و آیا میتواند آن را برگرداند.
درسهایی از نمونههای واقعی
چالشهای اخلاقی وقتی ملموس میشوند که پیامدشان را در دنیای واقعی ببینیم. جدول زیر چند نمونهی مشهور را خلاصه میکند. هرکدام درسی برای سازندهی امروز دارد.
| چالش | نمونهی واقعی | درس اصلی |
|---|---|---|
| رضایت آگاهانه | مطالعهی سیفلیس توسکیگی (۱۹۳۲ تا ۱۹۷۲) | پنهان کردن هدف و خطر از شرکتکنندگان |
| حریم خصوصی | جایزهی دادهی نتفلیکس (۲۰۰۷) | دادهی ناشناس با دادهی عمومی دوباره شناسایی شد |
| سوگیری جمعآوری | اپلیکیشن Street Bump بوستون (۲۰۱۳) | محلههای کمدرآمد با گوشی کمتر، کمتر دیده شدند |
| انصاف الگوریتمی | پژوهش Gender Shades (۲۰۱۸) | دقت کمتر تشخیص جنسیت برای زنان با پوست تیره |
| گزارش نادرست | نمودارهای کووید ایالت جورجیا (۲۰۲۰) | ترتیب نادرست تاریخها روند را گمراهکننده نشان داد |
جایزهی نتفلیکس؛ ناشناس یعنی امن؟
در سال ۲۰۰۷، نتفلیکس برای بهبود سیستم پیشنهاد فیلم، ده میلیون رتبهبندی ناشناس را منتشر کرد. نام کاربران حذف شده بود. اما پژوهشگران نشان دادند با مقایسهی این رتبهبندیها با نقدهای عمومی سایت IMDb، میشود برخی کاربران را شناسایی کرد.
این رتبهبندیها چیزهایی دربارهی سلیقهی سیاسی و شخصی افراد فاش میکرد. درس این ماجرا برای سازندهی دستیار روشن است. پیامهای کاربران حتی بدون نام هم میتوانند هویتساز باشند. پیش از استفاده از لاگ گفتوگوها برای آموزش یا تحلیل، اطلاعات شناسایی را واقعاً حذف کنید.
Street Bump؛ سوگیری در خود ابزار جمعآوری
شهر بوستون اپلیکیشنی ساخت که با حسگر گوشی، چالههای خیابان را خودکار گزارش میکرد. ایده هوشمندانه بود. اما محلههای کمدرآمد که ساکنانشان گوشی هوشمند کمتری داشتند، کمتر گزارش میدادند.
در نتیجه خیابانهای همین محلهها کمتر تعمیر میشدند. هیچکس قصد تبعیض نداشت، اما ابزار جمعآوری خودش سوگیری داشت. همیشه بپرسید چه کسانی در دادهی شما حضور ندارند.
چکلیست اخلاق داده برای دستیار هوش مصنوعی
حالا این چالشها را به کارهای مشخص برای یک دستیار آموزشی تبدیل میکنیم. اصل راهنما در این بخش «حداقل دادهی لازم» است. یعنی فقط دادهای را جمع کنید که برای هدف مشخص واقعاً لازم است. نمودار زیر چهار قدم این رویکرد را نشان میدهد.
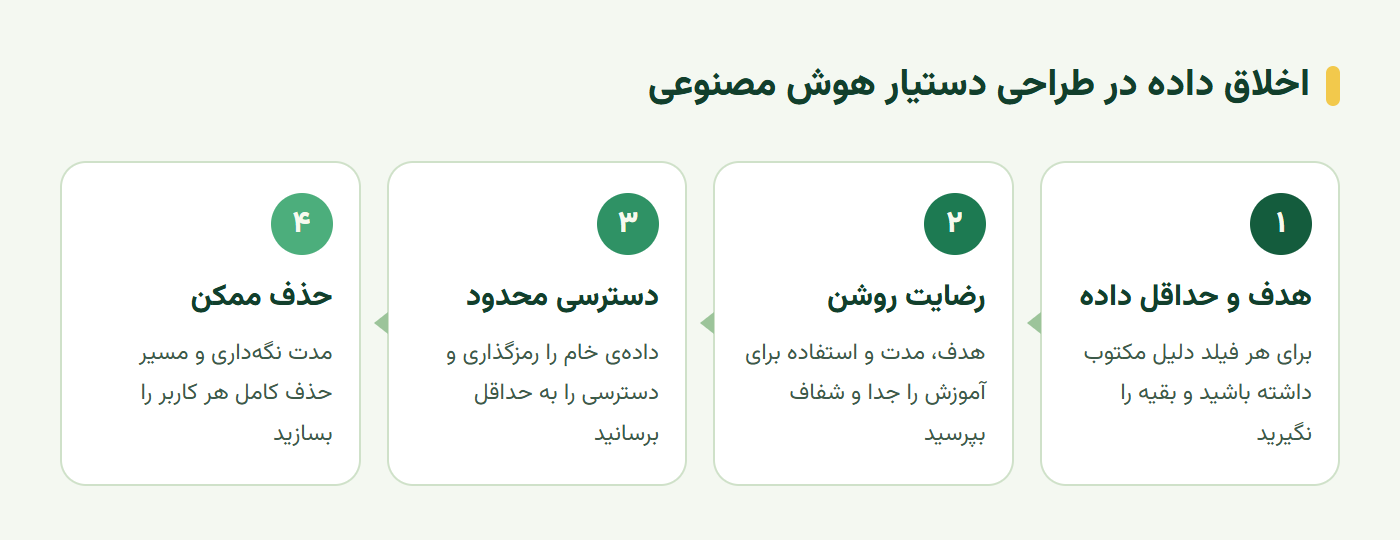
پیش از جمعآوری؛ هدف و حداقل داده
برای هر فیلدی که از کاربر میگیرید، یک دلیل مکتوب داشته باشید. اگر دستیار فقط به پرسش دربارهی دورهها پاسخ میدهد، به شمارهی ملی نیازی ندارد. دادهای که جمع نشود، نه نشت میکند و نه سوءاستفاده میشود.
متن رضایت را کوتاه و روشن بنویسید. بگویید چه دادهای ذخیره میشود، برای چه هدفی و تا کی. اگر قرار است پیامها برای بهبود مدل استفاده شوند، این را جداگانه بپرسید و پیشفرض را «خیر» بگذارید.
پس از جمعآوری؛ دسترسی، نگهداری و حذف
برای داده مدت نگهداری تعیین کنید. لاگ گفتوگوها لازم نیست برای همیشه بماند. پس از پایان مدت، حذف خودکار را فعال کنید. دسترسی به دادهی خام را هم به کمترین تعداد نفر محدود کنید.
در نهایت، یک مسیر روشن برای حذف دادهی هر کاربر بسازید. این مسیر باید همهی نسخهها را پوشش دهد؛ پایگاه دادهی اصلی، پشتیبانها، لاگها و مجموعهدادههای مشتقشده. اگر نمیدانید دادهی یک کاربر کجاها هست، هنوز نمیتوانید به درخواست حذفش پاسخ دهید.
تمرین عملی؛ نقشهی دادهی شخصی
برای دستیار یا پروژهی خودتان، یک جدول ساده بسازید که برای هر دادهی شخصی این ستونها را داشته باشد:
- فیلد: نام داده؛ مثلاً ایمیل، متن پرسش یا شمارهی تماس.
- دلیل: چرا این داده لازم است و بدون آن چه کاری ممکن نیست.
- رضایت: کاربر کجا و با چه متنی اجازه داده است.
- محل ذخیره: همهی جاهایی که این داده یا نسخهای از آن هست.
- مدت نگهداری: تا کی نگه داشته و چطور حذف میشود.
هر فیلدی که ستون «دلیل» آن خالی ماند، کاندیدای حذف است. این جدول را در کنار کارت چرخهی عمر پروژه نگه دارید.
سخن پایانی
اخلاق داده مجموعهای از تصمیمهای کوچک و روزمره است. از مالکیت و رضایت آگاهانه تا حریم خصوصی، حق فراموش شدن، کیفیت داده و گزارش صادقانه. نمونههای واقعی نشان میدهند بیشتر آسیبها عمدی نبودند. از بیتوجهی به همین سؤالهای ساده آمدند.
برای سازندهی دستیار، اصل حداقل دادهی لازم بهترین نقطهی شروع است. کمتر جمع کنید، روشنتر اجازه بگیرید و حذف را ممکن کنید. اعتماد کاربر سخت به دست میآید و با یک نشت داده از دست میرود.
این آموزش بر پایهی درس Introduction to Data Ethics از مجموعهی آزاد Data Science for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
اخلاق داده چیست؟
اخلاق داده شاخهای از اخلاق است که مسائل اخلاقی مربوط به داده، الگوریتمها و شیوههای کار با آنها را بررسی میکند. هدفش این است که جمعآوری، ذخیره و استفاده از داده با ارزشهایی مثل انصاف، شفافیت و احترام به حریم خصوصی هماهنگ باشد.
رضایت آگاهانه در جمعآوری داده یعنی چه؟
یعنی کاربر با فهم کامل از هدف جمعآوری، خطرهای احتمالی و گزینههای جایگزین، اجازهی استفاده از دادهاش را بدهد. تیک خوردن پیشفرض یک گزینه در متن طولانی قوانین، رضایت آگاهانه نیست.
حق فراموش شدن چیست؟
حق فراموش شدن یا حق حذف به کاربر اجازه میدهد از سازمان بخواهد دادهی شخصیاش را حذف کند. این حق در مقررات GDPR اروپا تعریف شده است. سیستمها باید طوری طراحی شوند که حذف دادهی یک کاربر عملاً ممکن باشد.
آیا داده ناشناسشده همیشه امن است؟
نه. در ماجرای جایزهی نتفلیکس، پژوهشگران با ترکیب رتبهبندیهای ناشناس با دادهی عمومی سایت IMDb توانستند برخی کاربران را شناسایی کنند. ناشناسسازی باید در برابر ترکیب با دادههای دیگر هم آزموده شود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.