
آموزش pandas نقطهی شروع تقریباً هر پروژهی داده و هوش مصنوعی در پایتون است. پایگاه داده برای ذخیره و پرسوجو عالی است. اما وقتی باید داده را پاکسازی کنید، ستون تازه بسازید یا آن را برای مدل آماده کنید، به ابزار انعطافپذیرتری نیاز دارید. pandas همین ابزار است.
پردازش داده را با هر زبانی میشود انجام داد. اما پایتون به دلیل سادگی و کتابخانههای غنی، انتخاب اول بیشتر دانشمندان داده است. R و Julia هم گزینههای خوبیاند. در این قسمت با مفاهیم اصلی pandas آشنا میشویم و در پایان یک تحلیل کوچک اما قابل تکرار میسازیم.
چرا pandas برای تحلیل داده؟
وقتی دادهی جدولی زیادی دارید و باید عملیات پیچیده روی آن انجام دهید، کار با حلقههای پایتون کند و پرخطاست. pandas داده را در ساختاری به نام DataFrame نگه میدارد که شبیه جدول پایگاه داده است. عملیات روی کل ستونها یکجا و بسیار سریع انجام میشود.
pandas معمولاً کنار چند کتابخانهی دیگر استفاده میشود. NumPy برای کار با آرایههای چندبعدی عددی است و pandas روی آن ساخته شده است. Matplotlib برای رسم نمودار است و SciPy توابع علمی و آماری اضافه دارد. بیشتر برنامههای تحلیل داده با این چند خط شروع میشوند:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
بهترین توصیه برای یادگیری pandas
pandas کتابخانهی بسیار بزرگی است و هیچکس همهی توابعش را حفظ نیست. وقتی نمیدانید یک کار را چطور انجام دهید، جستجو کنید. در بیشتر موارد کسی پیش از شما همان سؤال را در Stack Overflow پرسیده است.
به همین دلیل در این قسمت به جای مرور همهی توابع، روی مفاهیم اصلی تمرکز میکنیم. اگر Series، DataFrame، فیلتر و گروهبندی را خوب بفهمید، پیدا کردن بقیهی توابع آسان است.
Series؛ ستونی از داده با شاخص
Series دنبالهای از مقادیر است؛ شبیه فهرست یا آرایهی NumPy. تفاوت اصلی این است که Series یک شاخص هم دارد. وقتی دو Series را با هم جمع میکنید، مقادیر بر اساس شاخص با هم جفت میشوند، نه بر اساس ترتیب.
یک مثال؛ فروش روزانهی بستنی
فرض کنید میخواهیم فروش یک بستنیفروشی را تحلیل کنیم. یک Series از تعداد فروش روزانه برای سه ماه میسازیم که شاخصش تاریخ است. بعد فرض میکنیم هر هفته ده بستهی اضافه برای مهمانی میخریم و آن را به فروش اضافه میکنیم.
idx = pd.date_range("2025-01-01", "2025-03-31")
sold = pd.Series(np.random.default_rng(0).integers(25, 50, len(idx)), index=idx)
extra = pd.Series(10, index=pd.date_range("2025-01-01", "2025-03-31", freq="W"))

total = sold.add(extra, fill_value=0)
monthly = total.resample("MS").mean()
print(monthly.round(1))
چرا از sold + extra استفاده نکردیم؟ چون در روزهایی که extra مقدار ندارد، حاصل جمع NaN میشد. پارامتر fill_value=0 مقدار نبوده را صفر در نظر میگیرد. این نکتهی کوچک منشأ بسیاری از خطاهای پنهان در تحلیل است.
سری زمانی و resample
وقتی شاخص از جنس تاریخ است، Series امکانات ویژهای برای سری زمانی دارد. مهمترینش resample است که داده را به بازهی زمانی دیگری تبدیل میکند. در کد بالا، فروش روزانه به میانگین ماهانه تبدیل شد.
این قابلیت در پروژههای واقعی بسیار کاربرد دارد. مثلاً تعداد پرسشهای روزانهی کاربران دستیار را به هفتگی تبدیل میکنید تا روند را ببینید. در قسمتهای بعدی این مجموعه، سری زمانی و پیشبینی را جداگانه بررسی میکنیم.
DataFrame؛ جدول کامل داده
DataFrame مجموعهای از چند Series با شاخص مشترک است. هر ستون یک Series است و نامی دارد. سادهترین راه ساخت آن، دادن یک دیکشنری است که کلیدهایش نام ستونها و مقادیرش Series یا فهرست باشند.
df = pd.DataFrame({
    "A": range(1, 10),
    "B": ["I", "like", "to", "use", "Python", "and", "Pandas", "very", "much"],
})
انتخاب ستون و فیلتر ردیف
با df["A"] یک ستون را بهصورت Series میگیرید. با df[["A", "B"]] چند ستون را بهصورت DataFrame جدید. برای انتخاب ردیف با شمارهی موقعیت، از iloc استفاده کنید؛ مثلاً df.iloc[:5] پنج ردیف اول را میدهد.
فیلتر ردیف با شرط انجام میشود. عبارت df["A"] < 5 یک Series از True و False برمیگرداند. وقتی آن را داخل کروشه بگذارید، فقط ردیفهای True میمانند؛ یعنی df[df["A"] < 5]. برای ترکیب چند شرط از & و | استفاده کنید و هر شرط را داخل پرانتز بگذارید.
ساخت ستون محاسباتی
ساخت ستون تازه ساده است. مثلاً df["DivA"] = df["A"] - df["A"].mean() فاصلهی هر مقدار از میانگین را حساب میکند. عملیات روی کل ستون یکجا انجام میشود و نیازی به حلقه نیست.
اما یک دام رایج وجود دارد. df["LenB"] = len(df["B"]) طول کل ستون را در همهی ردیفها مینویسد، نه طول هر کلمه را. برای اعمال یک تابع روی هر مقدار، از apply استفاده کنید: df["LenB"] = df["B"].apply(len). این کد طول هر کلمه را جداگانه حساب میکند.
بیشتر بخوانید: پیش از شروع تحلیل، نقشهی دادهی شخصی و اصل حداقل دادهی لازم را در اخلاق داده در هوش مصنوعی مرور کنید.
گروهبندی و خلاصهسازی با groupby
گروهبندی یکی از پرکاربردترین عملیات تحلیل داده است. نتیجهاش شبیه جدول محوری یا Pivot Table در اکسل است. داده را بر اساس مقدار یک ستون گروه میکنید و برای هر گروه آمارهای حساب میکنید.
میانگین هر گروه
فرض کنید میخواهیم میانگین ستون A را برای هر مقدار LenB بدانیم. یعنی کلمههای همطول را در یک گروه بگذاریم. این کار با یک خط انجام میشود:
df.groupby("LenB")["A"].mean()خروجی یک Series است که شاخصش مقادیر LenB و مقدارش میانگین A در آن گروه است. همین الگو برای سؤالهایی مثل «میانگین زمان پاسخ برای هر موضوع پرسش» یا «تعداد ثبتنام در هر دوره» کاربرد دارد.
چند آماره همزمان با agg
اغلب به بیش از یک آماره نیاز دارید؛ مثلاً میانگین و تعداد با هم. تابع agg این کار را انجام میدهد و میشود برای هر خروجی نام دلخواه گذاشت:
summary = df.groupby("LenB").agg(count=("A", "size"), mean_a=("A", "mean"))همیشه تعداد را کنار میانگین گزارش کنید. میانگینی که فقط از یک نمونه حساب شده، ارزش آماری ندارد. این همان نکتهای است که در قسمت آمار دربارهی حجم نمونه گفتیم.
از فایل خام تا تحلیل قابل تکرار
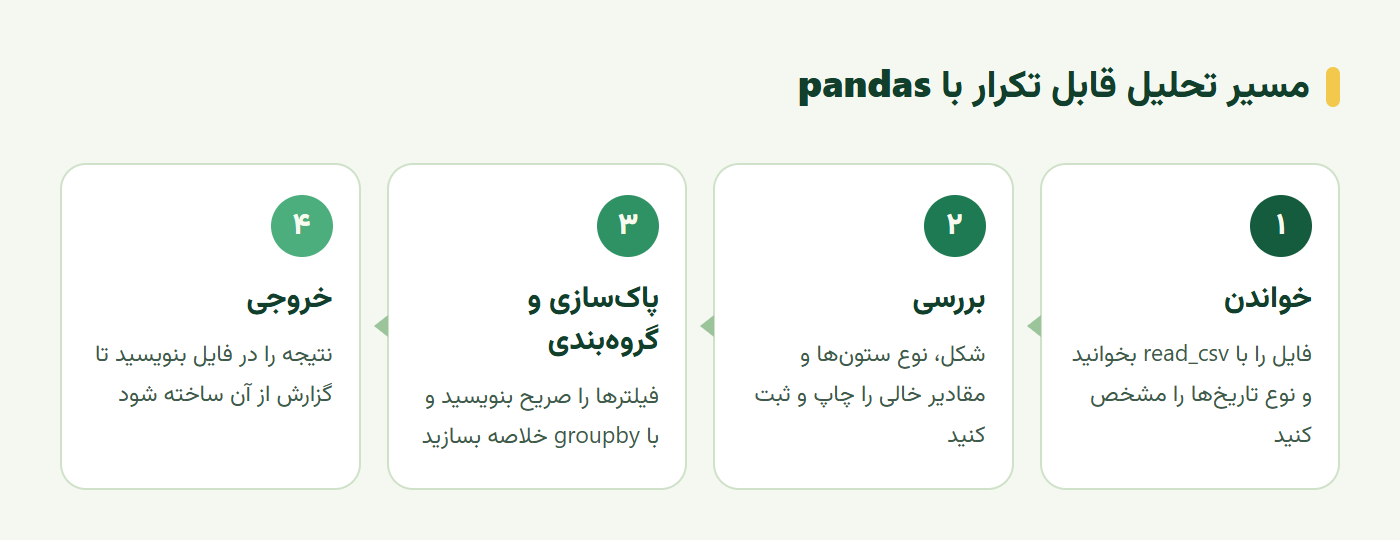
در دنیای واقعی، داده را از فایل میخوانید، نه از دیکشنری پایتون. pandas فرمتهای زیادی را پشتیبانی میکند؛ CSV، اکسل، JSON، Parquet و حتی جدولهای HTML. رایجترین آنها pd.read_csv است. نمودار زیر مسیر یک تحلیل قابل تکرار را نشان میدهد.
یک تحلیل کامل در چند خط
فرض کنید فایلی از پرسشهای پشتیبانی دارید که ستونهای تاریخ، موضوع و زمان پاسخ دارد. کد زیر آن را میخواند، بررسی میکند و خلاصهی هفتگی میسازد:
df = pd.read_csv("tickets.csv", parse_dates=["created_at"])
print(df.shape, df.dtypes, df.isna().sum(), sep="\n")

df = df.dropna(subset=["topic"]).query("response_hours >= 0")
weekly = (
    df.set_index("created_at")
      .groupby("topic")["response_hours"]
      .resample("W").median()
      .unstack(0)
)
weekly.to_csv("weekly_response.csv")
چه چیزی تحلیل را قابل تکرار میکند؟
تحلیل قابل تکرار یعنی اگر فردا فایل تازه بیاید، با اجرای همان کد، گزارش تازه بگیرید. برای این کار چند عادت لازم است. همهی مراحل را در کد بنویسید، نه با دست در اکسل. تصمیمهای پاکسازی، مثل حذف ردیفهای بدون موضوع، را صریح در کد بیاورید.
عادت دیگر ثبت شکل داده در هر مرحله است. اگر پس از فیلتر نیمی از ردیفها حذف شد، باید بدانید چرا. در نهایت، خروجی را در فایل بنویسید تا نمودار یا گزارش از همان فایل ساخته شود. با این عادتها، تحلیل شما به یک فرایند تبدیل میشود، نه یک کار یکباره.
تمرین عملی؛ اولین گزارش pandas
یک فایل CSV واقعی انتخاب کنید؛ از پروژهی خودتان یا یک مجموعهدادهی عمومی. یک اسکریپت بنویسید که این کارها را انجام دهد:
- خواندن و بررسی: شکل داده، نوع ستونها و تعداد مقادیر خالی را چاپ کند.
- فیلتر: ردیفهای نامعتبر را با یک شرط صریح حذف کند و تعداد حذفشدهها را گزارش دهد.
- ستون تازه: دستکم یک ستون محاسباتی بسازد.
- گروهبندی: برای یک ستون دستهای، تعداد و میانگین را با
aggحساب کند. - خروجی: نتیجه را در یک فایل CSV تازه ذخیره کند.
اسکریپت را دو بار اجرا کنید و مطمئن شوید خروجی یکسان است. اگر از عدد تصادفی استفاده کردهاید، seed را ثابت کنید.
سخن پایانی
pandas با دو مفهوم ساده کار میکند؛ Series یعنی ستونی با شاخص، و DataFrame یعنی جدولی از چند Series. با انتخاب، فیلتر، ستون محاسباتی و groupby میشود بیشتر سؤالهای تحلیلی را در چند خط جواب داد. خواندن فایل و resample هم کار با دادهی واقعی و سری زمانی را آسان میکند.
مهمتر از هر تابع، عادت نوشتن تحلیل قابل تکرار است. هر قدم در کد، هر تصمیم صریح و هر خروجی در فایل. این عادت در قسمتهای بعدی که داده را برای مدل آماده میکنیم، بیشترین کمک را به شما میکند.
این آموزش بر پایهی درس Working with Data: Python and the Pandas Library از مجموعهی آزاد Data Science for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
pandas چیست و چه کاربردی دارد؟
pandas کتابخانهی پایتون برای کار با دادهی جدولی است. ساختار اصلی آن DataFrame است که شبیه جدول پایگاه داده یا برگهی اکسل است. با pandas میتوانید داده را بخوانید، پاکسازی کنید، فیلتر و گروهبندی کنید و خلاصهی آماری بگیرید.
تفاوت Series و DataFrame چیست؟
Series یک ستون داده با شاخص است؛ مثل فهرستی از اعداد که هر کدام برچسب یا تاریخ دارند. DataFrame مجموعهای از چند Series با شاخص مشترک است؛ یعنی یک جدول کامل با چند ستون.
تفاوت loc و iloc در pandas چیست؟
iloc ردیف و ستون را با شمارهی موقعیت انتخاب میکند؛ مثلاً پنج ردیف اول. loc با برچسب شاخص و نام ستون کار میکند؛ مثلاً ردیفهای یک تاریخ خاص یا ستونهای مشخص. برای فیلتر شرطی هم معمولاً از loc استفاده میشود.
pandas را یاد بگیرم یا SQL؟
هر دو مفیدند و مکمل هماند. SQL برای پرسوجو روی پایگاه دادهی بزرگ و اشتراکی مناسب است. pandas برای تحلیل انعطافپذیر، پاکسازی و آمادهسازی داده برای مدل یادگیری ماشین در پایتون بهتر است. بسیاری از پروژهها داده را با SQL میگیرند و با pandas تحلیل میکنند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.