
پاکسازی داده همان کاری است که در هیچ نمایش جذابی از هوش مصنوعی دیده نمیشود، اما بیشترین وقت پروژه را میگیرد. دادهی خام تقریباً همیشه مشکل دارد؛ ستون خالی، ردیف تکراری، تاریخ با قالبهای مختلف و متنی که یک کلمه را به سه شکل نوشته است. مدلی که با این داده آموزش ببیند، همین مشکلات را یاد میگیرد.
در قسمت قبل با pandas آشنا شدیم. حالا از همان ابزار برای پاکسازی استفاده میکنیم. اول میبینیم چرا پاکسازی مهم است و چطور داده را سریع بشناسیم. بعد سه مشکل اصلی را یکییکی حل میکنیم و در پایان همه را در یک تابع قابل تکرار کنار هم میگذاریم.
چرا پاکسازی داده مهم است؟
پاکسازی داده سه فایدهی اصلی دارد. اول، دادهی مرتب و یکدست راحتتر جستجو، استفاده و با دیگران به اشتراک گذاشته میشود. دوم، وقتی چند مجموعهداده از منابع مختلف را ترکیب میکنید، باید استاندارد یکسانی داشته باشند. سوم، دقت مدل مستقیماً به کیفیت داده بستگی دارد.
جملهی مشهور «ورودی بیکیفیت، خروجی بیکیفیت» در هوش مصنوعی از همیشه درستتر است. پیچیدهترین مدل هم نمیتواند خطای سیستماتیک داده را جبران کند. گاهی یک روز پاکسازی بیش از یک ماه تنظیم مدل اثر دارد.
چهار هدف اصلی پاکسازی
هر فرایند پاکسازی معمولاً این چهار کار را انجام میدهد:
- کاوش داده: پیدا کردن مشکلات با نگاه به خلاصه و نمونهی داده.
- یکدستسازی قالب: یکسان کردن شیوهی نوشتن تاریخ، عدد، نام و متن.
- حذف تکراری: پاک کردن رکوردهایی که بیش از یک بار آمدهاند.
- مدیریت مقدار گمشده: حذف، جایگزینی یا علامتگذاری مقادیر خالی.
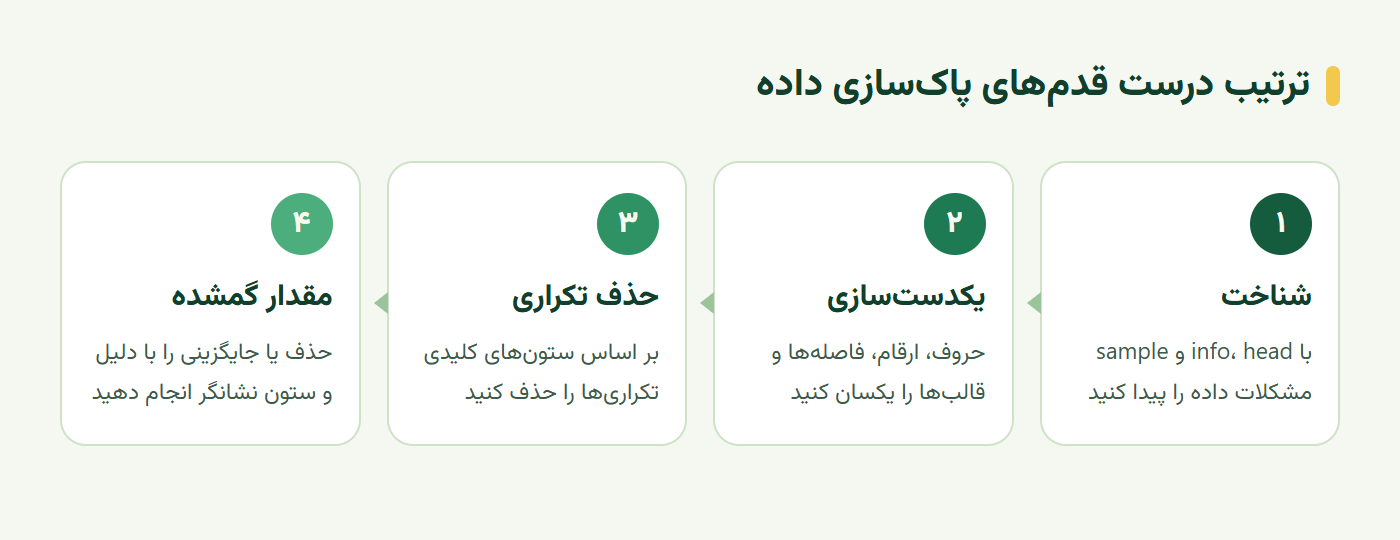
ترتیب این کارها مهم است. اول باید داده را بشناسید، بعد یکدست کنید، بعد تکراریها را پیدا کنید. چون دو رکورد با قالب متفاوت، پیش از یکدستسازی تکراری به نظر نمیرسند.
قدم اول؛ شناخت داده با info و head
پیش از هر تغییری، باید بدانید با چه دادهای روبهرو هستید. pandas چند تابع ساده برای این کار دارد. برای مثال از مجموعهدادهی مشهور گل زنبق استفاده میکنیم که در scikit-learn آماده است.
import pandas as pd
from sklearn.datasets import load_iris

iris = load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)
df.info()
print(df.head(), df.tail(), sep="\n")
info چه چیزی به ما میگوید؟
خروجی info() تعداد ردیفها، نام ستونها، تعداد مقادیر غیرخالی و نوع دادهی هر ستون را نشان میدهد. برای دادهی زنبق، ۱۵۰ ردیف و چهار ستون اعشاری بدون هیچ مقدار خالی داریم. این داده از قبل تمیز است.
در دادهی واقعی، info() معمولاً اولین زنگ خطر را به صدا درمیآورد. مثلاً ستون قیمت که باید عدد باشد، نوع object دارد. این یعنی جایی در ستون متنی مثل «توافقی» یا «۱۲۰٬۰۰۰» با ارقام فارسی آمده است.
head و tail؛ نگاه چشمی
head() چند ردیف اول و tail() چند ردیف آخر را نشان میدهد. این نگاه ساده گاهی مشکلاتی را نشان میدهد که آمار نمیبیند. مثلاً ردیف آخر فایل اکسل «جمع کل» است و نباید در تحلیل بیاید.
برای دادهی بزرگ، sample(10) هم مفید است، چون ردیفهای تصادفی از وسط داده را نشان میدهد. عادت کنید پیش از هر تحلیل، دستکم بیست ردیف واقعی را با چشم ببینید.
بیشتر بخوانید: اگر هنوز با Series، DataFrame و groupby راحت نیستید، اول آموزش pandas برای تحلیل داده را بخوانید.
مدیریت مقدار گمشده
تقریباً هر مجموعهدادهی واقعی مقدار گمشده دارد. نحوهی برخورد با آن روی نتیجهی تحلیل و دقت مدل اثر مستقیم دارد. هیچ روش واحدی برای همهی موارد نیست. تصمیم به دلیل گمشدگی و مقدار آن بستگی دارد.
NaN و None؛ دو شکل مقدار خالی
pandas مقدار گمشده را به دو شکل نشان میدهد. NaN مقدار اعشاری ویژهای برای عدد نامعلوم است. None شیء پایتون برای نبود مقدار است که در ستونهای متنی دیده میشود. خوشبختانه isnull() هر دو را تشخیص میدهد.
اما دقت کنید؛ رشتهی خالی و صفر مقدار گمشده نیستند. در pd.Series([0, np.nan, "", None]).isnull() فقط دو مورد وسطی True میشوند. اگر در دادهی شما رشتهی خالی یعنی «نامعلوم»، باید اول آن را به NaN تبدیل کنید.
حذف یا جایگزینی؟
dropna() ردیفهای دارای مقدار خالی را حذف میکند. در DataFrame نمیشود یک خانه را حذف کرد، پس کل ردیف یا ستون حذف میشود. پارامتر thresh کمک میکند فقط ردیفهایی را حذف کنید که بیش از حد خالیاند؛ مثلاً dropna(thresh=3) ردیفهایی را نگه میدارد که دستکم سه مقدار دارند.
fillna() مقدار خالی را جایگزین میکند. برای عدد، میانه معمولاً از میانگین امنتر است. برای سری زمانی، مقدار قبلی با ffill() منطقی است. برای ستون دستهای، یک دستهی جدا مثل «نامعلوم» صادقانهتر از پرتکرارترین مقدار است. قاعدهی مهم هم این است: اگر گمشدگی معنادار است، یک ستون نشانگر بسازید تا مدل بداند این مقدار در اصل خالی بوده است.
حذف رکورد تکراری و یکدستسازی قالب
دو مشکل دیگر که تقریباً در هر دادهای هست، تکرار و ناسازگاری قالب است. این دو به هم گره خوردهاند. رکوردی که با قالب متفاوت دوباره ثبت شده، تا یکدست نشود تکراری دیده نمیشود.
یکدستسازی متن فارسی
متن فارسی چالشهای خاص خودش را دارد. یک کلمه ممکن است با «ي» و «ك» عربی یا «ی» و «ک» فارسی نوشته شود. ارقام ممکن است فارسی، عربی یا لاتین باشند. نیمفاصله گاهی فاصله و گاهی حذف شده است. برای کامپیوتر همهی اینها کلمههای متفاوتاند.
تابع زیر رایجترین ناسازگاریها را یکدست میکند. برای کار جدیتر، کتابخانههایی مثل Hazm نرمالساز کاملتری دارند.
import re

AR_TO_FA = str.maketrans("يكۀ٠١٢٣٤٥٦٧٨٩۰۱۲۳۴۵۶۷۸۹", "یکه01234567890123456789")

def normalize_fa(text):
    if pd.isna(text):
        return text
    text = str(text).translate(AR_TO_FA)
    text = re.sub(r"\s+", " ", text).strip()
    return text
پیدا کردن و حذف تکراری
بعد از یکدستسازی، نوبت تکراریهاست. duplicated() یک Series از True و False برمیگرداند که نشان میدهد هر ردیف قبلاً آمده یا نه. drop_duplicates() تکراریها را حذف میکند و اولین نمونه را نگه میدارد.
همیشه مشخص کنید تکراری بودن بر اساس کدام ستونهاست. دو پیام پشتیبانی با متن یکسان از دو کاربر مختلف تکراری نیستند. اما دو ثبتنام با ایمیل یکسان در یک دوره احتمالاً تکراریاند. پس drop_duplicates(subset=["email", "course_id"]) دقیقتر از حذف کورکورانه است.
یک تابع پاکسازی قابل تکرار
پاکسازی نباید یک کار دستی یکباره باشد. اگر فردا دادهی تازه بیاید، باید همان پاکسازی دقیقاً تکرار شود. بهترین راه، نوشتن یک تابع است که همهی قدمها را انجام دهد و گزارش بدهد. نمودار زیر ترتیب این قدمها را نشان میدهد.
کد تابع
این تابع روی دادهی ثبتنام یک آموزشگاه کار میکند و در هر قدم تعداد ردیفها را ثبت میکند:
def clean_enrollments(df):
    log = {"raw": len(df)}
    df = df.copy()
    for col in ["name", "course", "city"]:
        df[col] = df[col].map(normalize_fa).replace("", pd.NA)
    df["email"] = df["email"].str.strip().str.lower()

    df = df.drop_duplicates(subset=["email", "course"])
    log["after_dedup"] = len(df)

    df = df.dropna(subset=["email", "course"])
    log["after_required"] = len(df)

    df["city_missing"] = df["city"].isna()
    df["city"] = df["city"].fillna("نامعلوم")
    df["age"] = pd.to_numeric(df["age"], errors="coerce")
    df["age"] = df["age"].fillna(df["age"].median())
    return df, log
چرا لاگ مهم است؟
دیکشنری log نشان میدهد در هر قدم چند ردیف حذف شد. اگر روزی ببینید پس از حذف تکراری نیمی از داده رفته، میفهمید مشکلی در منبع داده پیش آمده است. بدون این لاگ، این اتفاق بیصدا رخ میدهد.
به errors="coerce" هم دقت کنید. این پارامتر مقادیر غیرعددی مثل «نامشخص» را به NaN تبدیل میکند، به جای اینکه برنامه را متوقف کند. ستون city_missing هم اطلاعات گمشدگی را برای مدل نگه میدارد.
تمرین عملی؛ گزارش پاکسازی
یک مجموعهدادهی واقعی با دستکم یک ستون متنی فارسی انتخاب کنید. تابع پاکسازی خودتان را بنویسید و این گزارش را تهیه کنید:
- پیش از پاکسازی: خروجی
info()و تعداد مقادیر خالی هر ستون. - یکدستسازی: تعداد مقادیر یکتای ستون متنی، پیش و پس از نرمالسازی.
- تکراریها: تعداد حذفشده و ستونهایی که بر اساسشان تصمیم گرفتید.
- مقادیر گمشده: برای هر ستون، تصمیم حذف یا جایگزینی و دلیلش.
- پس از پاکسازی: تعداد نهایی ردیفها و درصد دادهی حذفشده.
اگر بیش از بیست درصد داده حذف شد، دوباره فکر کنید. شاید جایگزینی بهتر از حذف باشد.
سخن پایانی
پاکسازی داده چهار کار اصلی دارد؛ شناخت داده، یکدستسازی قالب، حذف تکراری و مدیریت مقدار گمشده. pandas برای همهی آنها ابزار آماده دارد؛ از info و isnull تا drop_duplicates و fillna. متن فارسی هم به یکدستسازی ویژهی حروف، ارقام و فاصلهها نیاز دارد.
مهمتر از هر تابع، نوشتن پاکسازی بهصورت یک فرایند قابل تکرار با لاگ است. هر تصمیم پاکسازی روی نتیجهی مدل اثر میگذارد. پس آن را صریح بنویسید، مستند کنید و با هر دادهی تازه دوباره اجرا کنید.
این آموزش بر پایهی درس Working with Data: Data Preparation از مجموعهی آزاد Data Science for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
پاکسازی داده چیست؟
پاکسازی داده فرایند پیدا کردن و اصلاح مشکلات دادهی خام است؛ مثل مقادیر گمشده، رکوردهای تکراری، قالبهای ناسازگار و مقادیر نامعتبر. هدف این است که داده برای تحلیل و آموزش مدل قابل اعتماد شود.
با مقدار گمشده چه کنیم؛ حذف یا جایگزینی؟
بستگی به دلیل گمشدگی و مقدار آن دارد. اگر فقط چند ردیف گمشده دارند و تصادفیاند، حذف معمولاً مشکلی ندارد. اگر گمشدگی زیاد یا معنادار است، جایگزینی با میانه، مقدار قبلی یا یک دستهی «نامعلوم» بهتر است. همیشه تصمیم را مستند کنید.
تفاوت NaN و None در pandas چیست؟
NaN یک مقدار اعشاری ویژه برای عدد نامعلوم است و در ستونهای عددی استفاده میشود. None شیء پایتون برای نبود مقدار است و در ستونهای متنی یا object دیده میشود. pandas هر دو را با isnull بهعنوان مقدار گمشده تشخیص میدهد.
چرا متن فارسی به یکدستسازی نیاز دارد؟
چون یک کلمه ممکن است با «ي» و «ك» عربی یا «ی» و «ک» فارسی، با فاصله یا نیمفاصله و با ارقام فارسی یا لاتین نوشته شود. کامپیوتر اینها را کلمههای متفاوت میبیند و شمارش، جستجو و گروهبندی اشتباه میشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.