
مهندسی ویژگی چیست و چرا گاهی بیش از انتخاب الگوریتم روی نتیجه اثر دارد؟ مدل یادگیری ماشین فقط چیزی را یاد میگیرد که در ورودیاش هست. اگر ستون تاریخ را خام به مدل بدهید، نمیفهمد فروش در پاییز بالا میرود. اما اگر ستون «ماه» را برایش بسازید، این الگو را راحت پیدا میکند.
در قسمت قبل داده را پاکسازی کردیم. حالا دادهی تمیز را به ورودی مناسب مدل تبدیل میکنیم. در این قسمت با یک مجموعهدادهی واقعی از قیمت کدو تنبل در بازارهای آمریکا کار میکنیم. این داده دقیقاً همان مشکلاتی را دارد که در پروژههای واقعی میبینید.
مهندسی ویژگی از یک سؤال شروع میشود
سؤالی که از داده میپرسید، نوع الگوریتم و ویژگیهای لازم را تعیین میکند. کیفیت پاسخ هم به شکل داده بستگی دارد. تقریباً هیچ مجموعهدادهای از اول آمادهی مدلسازی نیست. کار شما این است که داده را با سؤال هماهنگ کنید.
مطالعهی موردی؛ بازار کدو تنبل
دادهی این قسمت از وزارت کشاورزی آمریکا آمده و در مخزن ML for Beginners در دسترس است. هر ردیف قیمت کمینه و بیشینهی کدو در یک بازار و یک روز را نشان میدهد. ستونهایی مثل نوع بستهبندی، شهر، رنگ و تنوع هم دارد.
اولین نگاه به داده ترکیبی از رشته، عدد، خانهی خالی و مقادیر عجیب را نشان میدهد. سؤال ما این است: قیمت یک کدو در یک ماه مشخص چقدر است؟ برای پاسخ، باید تاریخ را به ماه، دو ستون قیمت را به یک قیمت و واحدهای مختلف را به یک واحد تبدیل کنیم.
انتخاب ستونهای مرتبط
قدم اول کم کردن ستونهاست. داده دهها ستون دارد، اما برای سؤال ما فقط چهار ستون لازم است. انتخاب ستون با loc کار با DataFrame را سادهتر و خطا را کمتر میکند:
import pandas as pd

pumpkins = pd.read_csv("US-pumpkins.csv")
print(pumpkins.isnull().sum())
pumpkins = pumpkins.loc[:, ["Package", "Low Price", "High Price", "Date"]]
خروجی isnull().sum() نشان میدهد بعضی ستونها خالی زیادی دارند. اما ستونهایی که انتخاب کردیم تقریباً کاملاند. این یکی از مزیتهای انتخاب زودهنگام ستون است؛ بسیاری از مشکلات پاکسازی خودبهخود حذف میشوند.
ساخت ویژگی تازه از ستونهای موجود
ساخت ویژگی یعنی از ستونهای موجود ستون تازهای بسازیم که الگو را برای مدل روشنتر کند. این بخش خلاقانهترین قسمت مهندسی ویژگی است. دانش حوزهی کاری اینجا بیشترین ارزش را دارد.
قیمت میانگین و ماه
برای قیمت، میانگین قیمت کمینه و بیشینه را میگیریم. برای زمان، ماه را از تاریخ بیرون میکشیم. ماه برای مدل معنادارتر از تاریخ کامل است، چون الگوی فصلی را نشان میدهد:
price = (pumpkins["Low Price"] + pumpkins["High Price"]) / 2
month = pd.to_datetime(pumpkins["Date"], format="%m/%d/%y").dt.month
از تاریخ ویژگیهای دیگری هم میشود ساخت؛ روز هفته، تعطیل بودن یا فاصله تا یک مناسبت. مثلاً در دادهی فروش ایران، فاصله تا نوروز احتمالاً ویژگی مهمی است. این همان جایی است که دانش حوزه به کمک میآید.
یکسان کردن واحد؛ دامی که دیده نمیشود
اگر به ستون Package نگاه کنید، میبینید کدوها به شکلهای مختلفی فروخته میشوند. بعضی در بستهی «۱ و ۱/۹ بوشل»، بعضی «۱/۲ بوشل»، بعضی دانهای و بعضی به وزن. مقایسهی قیمت اینها با هم مثل مقایسهی قیمت یک کیلو با یک تن است.
راهحل دو قدم دارد. اول فقط ردیفهایی را نگه میداریم که واحدشان بوشل است. بعد قیمت را به قیمت هر یک بوشل تبدیل میکنیم:
mask = pumpkins["Package"].str.contains("bushel")
df = pd.DataFrame({"Month": month, "Package": pumpkins["Package"], "Price": price})[mask]
df.loc[df["Package"].str.contains("1 1/9"), "Price"] /= (1 + 1 / 9)
df.loc[df["Package"].str.contains("1/2"), "Price"] /= 0.5
پس از این تبدیل، حدود ۴۱۵ ردیف با قیمت قابل مقایسه باقی میماند. این خطا در هیچ آمارهی خلاصهای دیده نمیشد. فقط با نگاه دقیق به مقادیر یک ستون پیدا شد.
بیشتر بخوانید: پیش از مهندسی ویژگی، داده باید تمیز باشد. روشهای مدیریت مقدار گمشده و تکراری را در پاکسازی داده با pandas ببینید.
رمزگذاری و مقیاسبندی؛ زبان عددی مدل
مدلها فقط عدد میفهمند. ستونهایی مثل نوع بستهبندی، شهر یا رنگ باید به عدد تبدیل شوند. ستونهای عددی هم معمولاً باید هممقیاس شوند. جدول زیر روشهای رایج را خلاصه میکند.
| نوع ستون | روش | ابزار در scikit-learn | کی استفاده کنیم؟ |
|---|---|---|---|
| دستهای بدون ترتیب | رمزگذاری یکداغ | OneHotEncoder | شهر، رنگ، نوع بسته |
| دستهای با ترتیب | رمزگذاری ترتیبی | OrdinalEncoder | کوچک، متوسط، بزرگ |
| عددی | استانداردسازی | StandardScaler | بیشتر مدلهای خطی و شبکهی عصبی |
| عددی با دادهی پرت | مقیاسبندی مقاوم | RobustScaler | درآمد، قیمت با مقادیر خیلی بزرگ |
رمزگذاری دادهی دستهای
در رمزگذاری یکداغ، برای هر دسته یک ستون صفر و یک ساخته میشود. اگر نوع بسته سه حالت داشته باشد، سه ستون تازه میگیرید. این روش هیچ ترتیب ساختگی بین دستهها ایجاد نمیکند.
اشتباه رایج این است که دستهها را مستقیم به عدد ۱، ۲ و ۳ تبدیل کنیم. مدل خطی فکر میکند دستهی ۳ «سه برابر» دستهی ۱ است. این فقط وقتی درست است که دستهها واقعاً ترتیب داشته باشند؛ مثل اندازهی کوچک، متوسط و بزرگ.
مقیاسبندی و خطر نشت داده
استانداردسازی هر ستون را طوری تغییر میدهد که میانگینش صفر و انحراف معیارش یک شود. این کار برای مدلهایی که به بازهی عددها حساساند ضروری است. اما یک دام بزرگ اینجا هست.
میانگین و انحراف معیار باید فقط از دادهی آموزش حساب شوند. اگر روی کل داده حساب شوند، اطلاعاتی از دادهی آزمون وارد آموزش میشود. به این مشکل نشت داده میگویند. نتیجهاش دقتی است که در آزمون خوب و در دنیای واقعی بد است.
Pipeline؛ مهندسی ویژگی بدون نشت داده
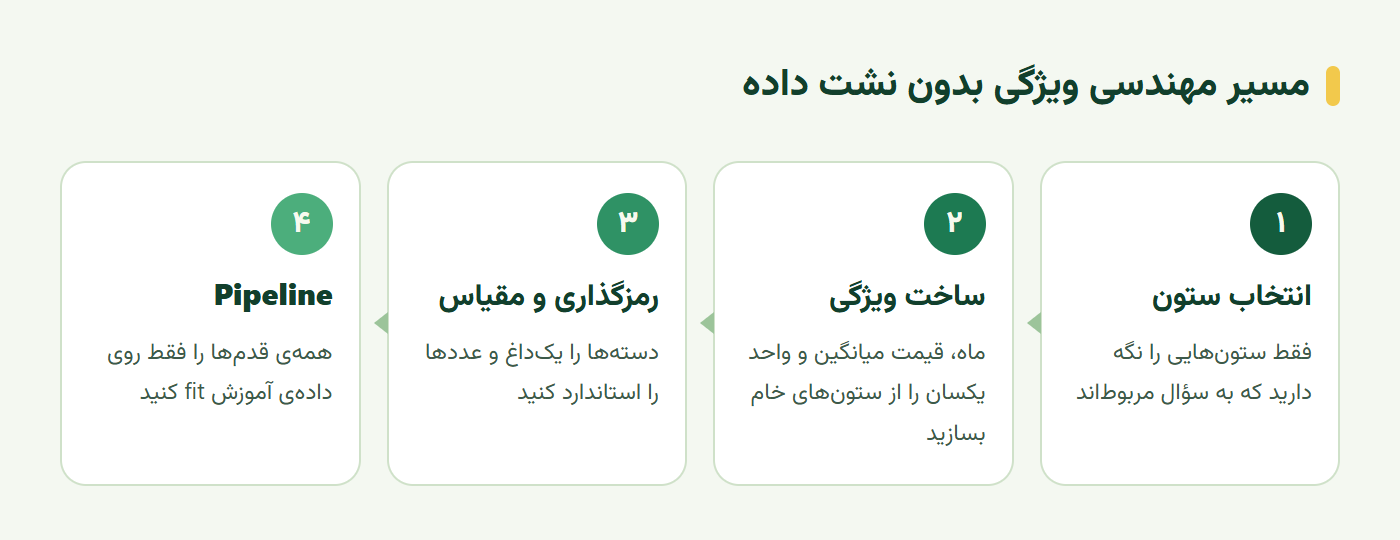
بهترین راه جلوگیری از نشت داده، استفاده از Pipeline در scikit-learn است. Pipeline همهی قدمهای آمادهسازی و مدل را در یک شیء کنار هم میگذارد. وقتی fit را صدا میزنید، هر قدم فقط روی دادهی آموزش یاد میگیرد. نمودار زیر این مسیر را نشان میدهد.
ساخت Pipeline برای دادهی کدو
کد زیر ماه را استاندارد و نوع بسته را یکداغ میکند و یک مدل رگرسیون خطی روی آن میسازد:
from sklearn.compose import ColumnTransformer
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

X, y = df[["Month", "Package"]], df["Price"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

prep = ColumnTransformer([
    ("num", StandardScaler(), ["Month"]),
    ("cat", OneHotEncoder(handle_unknown="ignore"), ["Package"]),
])
model = Pipeline([("prep", prep), ("reg", LinearRegression())]).fit(X_train, y_train)
print("R2 on test:", round(model.score(X_test, y_test), 3))
چرا Pipeline بهتر است؟
Pipeline سه مزیت دارد. اول، نشت داده را غیرممکن میکند، چون مقیاسبندی فقط با X_train یاد گرفته میشود. دوم، همین شیء را میشود ذخیره کرد و در محیط واقعی روی ورودی خام اجرا کرد. نیازی نیست قدمهای آمادهسازی را دوباره بنویسید.
سوم، handle_unknown="ignore" کمک میکند اگر در آینده نوع بستهی تازهای آمد، مدل خطا ندهد. این جزئیات کوچک فاصلهی یک نوتبوک آزمایشی با یک سیستم قابل استفاده را میسازند.
تمرین عملی؛ کارت ویژگیها
برای مدلی که در قسمتهای قبل طراحی کردید، یک جدول ویژگی بسازید. برای هر ستون ورودی این موارد را بنویسید:
- منبع: ستون خام یا ستونهایی که این ویژگی از آنها ساخته شده است.
- نوع: عددی، دستهای بدون ترتیب یا دستهای با ترتیب.
- تبدیل: روش رمزگذاری یا مقیاسبندی و دلیل انتخابش.
- دسترسی در زمان پیشبینی: آیا این مقدار وقتی کاربر واقعی درخواست میدهد موجود است؟
- ریسک نشت: آیا این ویژگی ممکن است اطلاعاتی از آینده یا از هدف در خود داشته باشد؟
ستون «دسترسی در زمان پیشبینی» را جدی بگیرید. ویژگیای که فقط در دادهی تاریخی هست، مدل را در آزمون خوب و در عمل بیفایده میکند.
سخن پایانی
مهندسی ویژگی پلی بین دادهی خام و مدل است. شامل انتخاب ستونهای مرتبط، ساخت ویژگی تازه، یکسان کردن واحد، رمزگذاری دادهی دستهای و مقیاسبندی عددهاست. مثال کدو تنبل نشان داد بعضی مشکلات، مثل واحدهای متفاوت، فقط با نگاه دقیق به داده پیدا میشوند.
Pipeline در scikit-learn همهی این قدمها را در یک جا جمع میکند و جلوی نشت داده را میگیرد. اگر یک عادت از این قسمت بردارید، این باشد: هر تبدیلی که از داده یاد میگیرد، فقط روی دادهی آموزش fit شود.
این آموزش بر پایهی درس Build a regression model: prepare and visualize data از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
مهندسی ویژگی چیست؟
مهندسی ویژگی فرایند تبدیل دادهی خام به ورودیهای مفید برای مدل است. شامل انتخاب ستونهای مرتبط، ساخت ستونهای تازه مثل ماه از تاریخ، یکسان کردن واحدها، رمزگذاری دادهی دستهای و مقیاسبندی عددها میشود.
تفاوت انتخاب ویژگی و استخراج ویژگی چیست؟
انتخاب ویژگی یعنی از میان ستونهای موجود، زیرمجموعهی مفید را نگه دارید. استخراج یا ساخت ویژگی یعنی از ستونهای موجود ستون تازه بسازید؛ مثل محاسبهی قیمت میانگین از کمینه و بیشینه یا استخراج روز هفته از تاریخ.
نشت داده چیست؟
نشت داده یعنی اطلاعاتی که در زمان پیشبینی واقعی در دسترس نیست، هنگام آموزش وارد مدل شود. مثلاً میانگین مقیاسبندی روی کل داده، شامل دادهی آزمون، حساب شود. نتیجهاش دقت خوشبینانه در آزمون و عملکرد ضعیف در عمل است.
چرا باید داده را مقیاسبندی کنیم؟
چون بسیاری از الگوریتمها مثل رگرسیون با تنظیم، KNN و شبکهی عصبی به بازهی عددها حساساند. اگر یک ستون بین صفر و یک و ستون دیگر بین صفر و یک میلیون باشد، ستون بزرگتر بیدلیل اثر بیشتری میگیرد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.