
آموزش SQL برای کسی که با هوش مصنوعی کار میکند یک مهارت جانبی نیست؛ یک ضرورت است. دادهی بیشتر سازمانها در پایگاههای دادهی رابطهای نگهداری میشود. فهرست دورهها، ثبتنامها، پرداختها و پرسشهای پشتیبانی همه در جدولهاییاند که با SQL خوانده میشوند.
در قسمتهای قبل با pandas داده را پاکسازی کردیم و ویژگی ساختیم. اما پیش از همهی اینها، داده باید از جایی خوانده شود. در این قسمت یاد میگیریم پایگاه دادهی رابطهای چطور کار میکند و با چهار دستور اصلی SQL دادهی لازم را بیرون بکشیم. در پایان هم نتیجه را مستقیم در pandas میخوانیم.
همه چیز با جدول شروع میشود
پایگاه دادهی رابطهای در قلبش جدول دارد. جدول هم مثل صفحهی گسترده مجموعهای از ستون و ردیف است. هر ردیف یک رکورد است و هر ستون یک ویژگی از آن رکورد. مثلاً جدولی از شهرها که ستونهای نام شهر، کشور و جمعیت دارد.
فرض کنید میخواهیم دادهی بارش سالانهی هر شهر را هم ذخیره کنیم. سادهترین راه اضافه کردن ستونهایی مثل «بارش ۲۰۱۸»، «بارش ۲۰۱۹» و «بارش ۲۰۲۰» است. این کار برای سه سال کار میکند، اما خیلی زود مشکلساز میشود.
کاستی جدول واحد
با هر سال تازه باید یک ستون اضافه کنید و ساختار جدول را تغییر دهید. راه دیگر این است که برای هر سال یک ردیف تازه بسازید. اما آن وقت نام شهر و کشور و جمعیت در هر ردیف تکرار میشود.
تکرار داده دو مشکل دارد. اول، فضای بیشتری میگیرد. دوم و مهمتر، اگر نام یک شهر عوض شود، باید همهی ردیفهایش را اصلاح کنید. اگر یکی جا بماند، داده ناسازگار میشود. پایگاه دادهی رابطهای این مشکل را با جدا کردن داده در چند جدول مرتبط حل میکند.
رابطه؛ کلید اصلی و کلید خارجی
راهحل این است که داده را در دو جدول نگه داریم. جدول شهرها فقط اطلاعات ثابت هر شهر را دارد. جدول بارش فقط مقدار بارش هر شهر در هر سال را دارد. این دو جدول با یک ستون مشترک به هم وصل میشوند.
جدول شهرها و جدول بارش
هر شهر در جدول شهرها یک شناسهی یکتا دارد که به آن کلید اصلی میگویند. جدول بارش ستونی به نام city_id دارد که به همین شناسه اشاره میکند. به این ستون کلید خارجی میگویند.
| جدول | ستونها | کلید |
|---|---|---|
| cities | city_id، city، country، population | city_id کلید اصلی |
| rainfall | rainfall_id، city_id، year، amount | city_id کلید خارجی |
حالا نام هر شهر فقط یک بار ذخیره میشود. برای هر سال تازه هم فقط یک ردیف به جدول بارش اضافه میشود و ساختار جدول ثابت میماند. به این شیوهی طراحی نرمالسازی میگویند.
رابطه در دستیار آموزشی
همین الگو در دستیار آموزشی ما هم کاربرد دارد. یک جدول دورهها داریم، یک جدول دانشجویان و یک جدول ثبتنامها. جدول ثبتنام دو کلید خارجی دارد؛ یکی به دانشجو و یکی به دوره. این رابطهی چندبهچند را نشان میدهد؛ هر دانشجو چند دوره و هر دوره چند دانشجو دارد.
وقتی دستیار باید بگوید «شما در کدام دورهها ثبتنام کردهاید؟»، این سه جدول را به هم وصل میکند. پاسخ دقیق است، چون از دادهی واقعی میآید، نه از حافظهی مدل زبانی.
بیشتر بخوانید: پیش از مدلسازی، دادهای که با SQL خواندید باید به ویژگی تبدیل شود. روش کار را در مهندسی ویژگی چیست؟ ببینید.
بازیابی داده با SELECT و WHERE
SQL زبانی توصیفی است. شما میگویید چه دادهای میخواهید، نه اینکه چطور پیدایش کنید. پایگاه داده خودش بهترین راه را انتخاب میکند. سادهترین دستور SELECT است که ستونها را از یک جدول میخواند.
ساختار پایهی SELECT
هر پرسوجوی ساده دو بخش اصلی دارد. SELECT مشخص میکند کدام ستونها را میخواهید و FROM مشخص میکند از کدام جدول. نام همهی شهرها با این دستور خوانده میشود:
SELECT city
FROM cities;
برای خواندن همهی ستونها میشود از * استفاده کرد. اما در پروژهی واقعی، ستونها را صریح نام ببرید. این کار هم سریعتر است و هم اگر ستون تازهای به جدول اضافه شود، کد شما عوض نمیشود.
فیلتر ردیف با WHERE
WHERE ردیفها را فیلتر میکند. فقط ردیفهایی برمیگردند که شرط را دارند. مثلاً شهرهای یک کشور خاص:
SELECT city, population
FROM cities
WHERE country = 'New Zealand'
ORDER BY population DESC;
ORDER BY نتیجه را مرتب میکند و DESC یعنی از بزرگ به کوچک. شرطها را میشود با AND و OR ترکیب کرد. برای مقایسهی متن با الگو هم LIKE کاربرد دارد.
پیوند جدولها با JOIN و خلاصه با GROUP BY
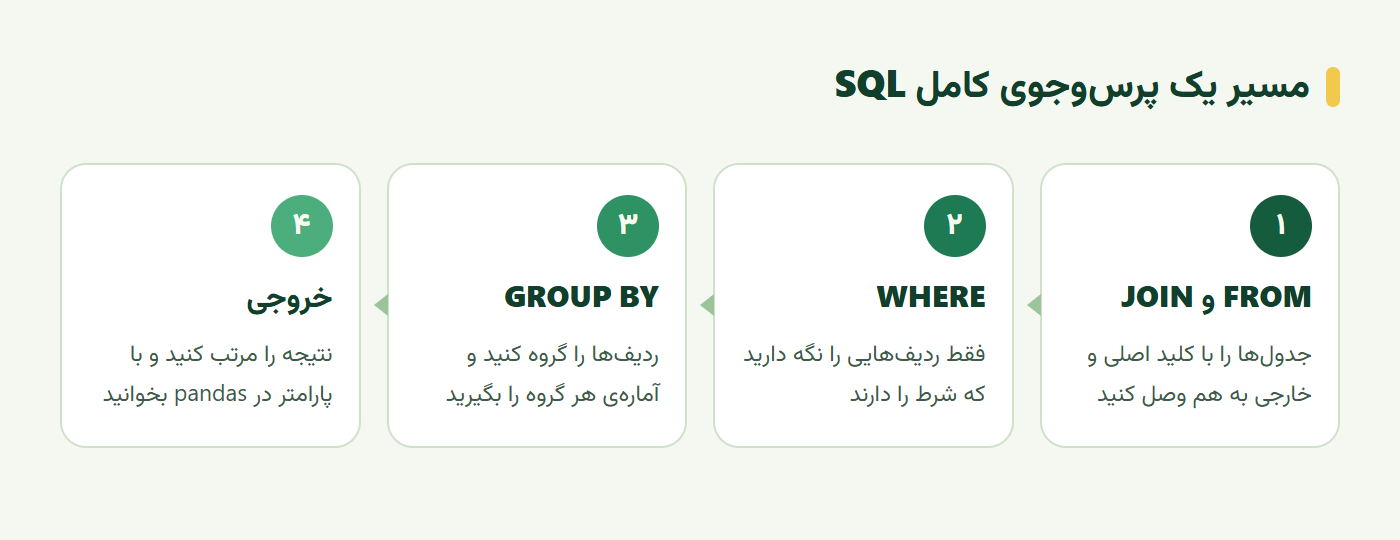
قدرت اصلی پایگاه دادهی رابطهای در پیوند جدولهاست. JOIN ردیفهای دو جدول را بر اساس ستون مشترک کنار هم میگذارد. بعد با GROUP BY میشود نتیجه را خلاصه کرد. نمودار زیر مسیر یک پرسوجوی کامل را نشان میدهد.
JOIN؛ نام شهر کنار مقدار بارش
برای دیدن بارش سال ۲۰۱۹ هر شهر، جدول شهرها را با جدول بارش پیوند میدهیم. شرط پیوند برابری city_id در دو جدول است:
SELECT cities.city, rainfall.amount
FROM cities
INNER JOIN rainfall ON cities.city_id = rainfall.city_id
WHERE rainfall.year = 2019;
INNER JOIN فقط ردیفهایی را برمیگرداند که در هر دو جدول جفت دارند. اگر شهری در سال ۲۰۱۹ دادهی بارش نداشته باشد، در نتیجه نمیآید. اگر میخواهید همهی شهرها بیایند، حتی بدون بارش، از LEFT JOIN استفاده کنید. تفاوت این دو منشأ بسیاری از خطاهای شمارش است.
GROUP BY؛ میانگین بارش هر کشور
GROUP BY ردیفها را بر اساس یک ستون گروه میکند و برای هر گروه یک آماره حساب میکند. این همان کاری است که در pandas با groupby انجام دادیم:
SELECT cities.country, AVG(rainfall.amount) AS avg_rain, COUNT(*) AS n
FROM cities
JOIN rainfall ON cities.city_id = rainfall.city_id
GROUP BY cities.country
HAVING COUNT(*) >= 3;
HAVING شبیه WHERE است، اما روی گروهها کار میکند. اینجا فقط کشورهایی میآیند که دستکم سه اندازهگیری دارند. یادتان باشد، میانگین روی نمونهی خیلی کم قابل اعتماد نیست.
SQL و پایتون؛ خواندن نتیجه در pandas
در پروژهی هوش مصنوعی، معمولاً داده را با SQL فیلتر و خلاصه میکنید و نتیجه را در pandas میخوانید. این کار سریعتر از خواندن کل جدول و فیلتر در پایتون است، چون فقط دادهی لازم منتقل میشود.
یک مثال با SQLite
SQLite یک پایگاه دادهی کامل در یک فایل است و در پایتون بدون نصب اضافه در دسترس است. کد زیر یک پرسوجو را اجرا و نتیجه را در DataFrame میخواند:
import sqlite3
import pandas as pd

con = sqlite3.connect("school.db")
query = """
SELECT c.title, COUNT(e.student_id) AS students
FROM courses c
LEFT JOIN enrollments e ON e.course_id = c.course_id
GROUP BY c.course_id
ORDER BY students DESC
"""
df = pd.read_sql_query(query, con)
print(df.head())
پارامتر به جای چسباندن رشته
وقتی مقدار شرط از کاربر میآید، هرگز آن را مستقیم به متن پرسوجو نچسبانید. این کار راه حملهای به نام تزریق SQL را باز میکند. به جای آن از پارامتر استفاده کنید:
pd.read_sql_query("SELECT * FROM courses WHERE level = ?", con, params=("beginner",))این نکته برای دستیارهای هوش مصنوعی اهمیت ویژهای دارد. اگر مدل زبانی بخشی از پرسوجو را میسازد، ورودی آن را هم باید مثل ورودی کاربر ناامن فرض کرد.
تمرین عملی؛ طرح پایگاه دادهی دستیار
برای دستیار آموزشی یک پایگاه دادهی SQLite کوچک بسازید و این کارها را انجام دهید:
- سه جدول: courses، students و enrollments را با کلید اصلی و خارجی تعریف کنید.
- دادهی نمونه: دستکم پنج دوره و بیست ثبتنام وارد کنید.
- پرسوجوی JOIN: نام دورههای هر دانشجو را برگردانید.
- پرسوجوی GROUP BY: تعداد دانشجوی هر دوره را حساب کنید، شامل دورههای بدون دانشجو.
- خواندن در pandas: نتیجه را با
read_sql_queryو یک پارامتر بخوانید.
در پرسوجوی چهارم، INNER JOIN و LEFT JOIN را امتحان کنید و تفاوت تعداد ردیفها را توضیح دهید.
سخن پایانی
پایگاه دادهی رابطهای داده را در جدولهای جدا نگه میدارد و با کلید اصلی و خارجی به هم وصل میکند. این طراحی تکرار را حذف میکند و داده را سازگار نگه میدارد. SQL زبان کار با همین جدولهاست؛ SELECT و WHERE برای خواندن و فیلتر، JOIN برای پیوند و GROUP BY برای خلاصه.
برای سازندهی هوش مصنوعی، ترکیب SQL و pandas بهترین مسیر است. سنگینی کار را به پایگاه داده بسپارید و فقط نتیجهی لازم را به پایتون بیاورید. و هیچوقت ورودی کاربر یا مدل را مستقیم در پرسوجو نچسبانید.
این آموزش بر پایهی درس Working with Data: Relational Databases از مجموعهی آزاد Data Science for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
SQL چیست؟
SQL زبان استاندارد پرسوجو در پایگاههای دادهی رابطهای است. با آن میتوانید داده را از جدولها بخوانید، فیلتر کنید، جدولها را به هم وصل کنید و خلاصهی آماری بگیرید. MySQL، PostgreSQL و SQLite از این زبان استفاده میکنند.
کلید اصلی و کلید خارجی چه فرقی دارند؟
کلید اصلی ستونی است که هر ردیف جدول را بهطور یکتا مشخص میکند؛ مثل شناسهی شهر. کلید خارجی ستونی در جدول دیگر است که به کلید اصلی اشاره میکند و رابطهی دو جدول را میسازد؛ مثل شناسهی شهر در جدول بارش.
JOIN در SQL چه کاری انجام میدهد؟
JOIN ردیفهای دو جدول را بر اساس یک ستون مشترک، معمولاً کلید خارجی، کنار هم میگذارد. مثلاً نام شهر را از جدول شهرها و مقدار بارش را از جدول بارش در یک نتیجهی واحد میآورد.
برای یادگیری ماشین SQL لازم است؟
بله، در بیشتر پروژههای واقعی داده در پایگاه دادهی رابطهای است. با SQL داده را در همان پایگاه داده فیلتر و خلاصه میکنید و فقط نتیجهی لازم را به پایتون میآورید. این کار سریعتر و کمحافظهتر از خواندن کل جدول است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.