
NoSQL چیست و چرا تقریباً هر دستیار هوش مصنوعی در جایی از آن استفاده میکند؟ پیامهای یک گفتوگو شکل ثابتی ندارند. یک پیام فقط متن است، دیگری پیوست دارد، سومی فراخوانی ابزار است و چهارمی چند منبع استناد. جا دادن این تنوع در جدولهای ثابت SQL سخت است، اما برای پایگاه دادهی سندی کاملاً طبیعی است.
در قسمت قبل پایگاه دادهی رابطهای و SQL را دیدیم. حالا با خانوادهی دیگری از پایگاههای داده آشنا میشویم که طرح ثابت ندارند. در این قسمت چهار نوع اصلی NoSQL را میشناسیم، روی پایگاه دادهی سندی تمرکز میکنیم و در پایان طرحی برای ذخیرهی گفتوگوهای دستیار میسازیم.
NoSQL چیست و از کجا آمد؟
NoSQL اصطلاحی کلی برای روشهای مختلف ذخیرهی دادهی غیررابطهای است. معنایش را «غیر SQL»، «غیررابطهای» یا «نه فقط SQL» تفسیر میکنند. تفسیر سوم دقیقتر است، چون بسیاری از این پایگاهها زبانی شبیه SQL هم برای پرسوجو دارند.
این پایگاهها با رشد وب و دادههای حجیم رایج شدند. شبکههای اجتماعی و فروشگاههای بزرگ به ذخیرهای نیاز داشتند که روی صدها سرور پخش شود و با هر تغییر محصول، ساختارش عوض نشود. پایگاه دادهی رابطهای برای این نیاز طراحی نشده بود.
تفاوت اصلی با پایگاه داده رابطهای
در پایگاه دادهی رابطهای، اول طرح جدول را تعریف میکنید و بعد داده را مطابق آن وارد میکنید. به این «طرح هنگام نوشتن» میگویند. در بیشتر پایگاههای NoSQL، داده را بدون طرح از پیش تعریفشده ذخیره میکنید و هنگام خواندن تفسیرش میکنید.
این انعطاف هزینه هم دارد. پایگاه دادهی NoSQL معمولاً قابلیتهای غنی پرسوجوی SQL را ندارد. یکپارچگی ارجاعی را هم تضمین نمیکند؛ یعنی جلوی سندی را که به سند حذفشده اشاره میکند، نمیگیرد. این مسئولیت به کد برنامه منتقل میشود.
چهار نوع پایگاه داده NoSQL
NoSQL یک فناوری واحد نیست. چهار خانوادهی اصلی دارد که هرکدام برای نوعی از مسئله ساخته شدهاند. جدول زیر آنها را کنار هم میگذارد.
| نوع | شکل ذخیره | نمونهی رایج | کاربرد در دستیار |
|---|---|---|---|
| کلید-مقدار | جفت کلید یکتا و مقدار | Redis | کش پاسخ و وضعیت نشست |
| سندی | سند JSON با فیلدهای متغیر | MongoDB، Cosmos DB | گفتوگوها و پیامها |
| گراف | گره و یال با ویژگی | Neo4j | پیشنیاز دورهها و رابطهی مفاهیم |
| ستونی | گروههای ستون روی حجم عظیم | Cassandra | لاگ رویدادهای میلیونها کاربر |
کلید-مقدار و گراف
پایگاه دادهی کلید-مقدار سادهترین نوع است. هر کلید یکتا به یک مقدار اشاره میکند. با تابع درهمسازی، مقدار با کلید بسیار سریع پیدا میشود. این نوع برای کش و وضعیت موقت عالی است، اما پرسوجو روی محتوای مقدار را پشتیبانی نمیکند.
پایگاه دادهی گراف رابطهها را در قلب خود دارد. داده به شکل گره و یال ذخیره میشود. گرهها موجودیتاند، مثل دانشجو یا دوره، و یالها رابطهاند، مثل «پیشنیاز است». پرسوجویی مثل «همهی پیشنیازهای مستقیم و غیرمستقیم این دوره» در گراف بسیار سادهتر از SQL است.
ستونی و سندی
پایگاه دادهی ستونی داده را در ستون و ردیف نگه میدارد، اما ستونها در گروههایی به نام خانوادهی ستون ذخیره میشوند. همهی دادهی یک خانواده کنار هم روی دیسک است. این طراحی برای خواندن و نوشتن حجم عظیم داده روی چندین سرور بهینه است.
پایگاه دادهی سندی رایجترین نوع NoSQL در برنامههای وب و هوش مصنوعی است. هر سند مجموعهای از فیلد و مقدار است که شبیه JSON نوشته میشود. در ادامه روی همین نوع تمرکز میکنیم.
بیشتر بخوانید: اگر هنوز کلید اصلی، JOIN و GROUP BY را ندیدهاید، اول آموزش SQL برای دادههای هوش مصنوعی را بخوانید.
پایگاه داده سندی از نزدیک
در پایگاه دادهی سندی، به جای جدول، مجموعه یا کانتینر داریم و به جای ردیف، سند. هر سند یک شناسهی یکتا دارد. بقیهی فیلدها آزادند و میتوانند عدد، رشته، فهرست یا شیء تودرتو باشند.
ساختار یک سند
سند زیر اطلاعات یک فرد را نشان میدهد. در پایگاههایی مثل Cosmos DB، فیلدهایی که با زیرخط شروع میشوند، مثل _ts برای زمان آخرین تغییر، را خود سیستم میسازد:
{
  "id": "8c74a315-aebf-4a16-bb38-2430a9896ce5",
  "firstname": "Eva",
  "age": 44,
  "interests": ["python", "data"],
  "_ts": 1630544034
}نکتهی مهم این است که سند بعدی میتواند فیلد interests نداشته باشد یا فیلد تازهای مثل city داشته باشد. هیچ خطایی رخ نمیدهد. بسیاری از APIها هم خروجی JSON دارند که مستقیم بهعنوان سند ذخیره میشود.
پرسوجو روی سندها
بیشتر پایگاههای سندی زبان پرسوجو دارند. Cosmos DB زبانی شبیه SQL دارد و مثلاً افراد زیر چهل سال را اینطور پیدا میکند: SELECT * FROM c WHERE c.age < 40. در MongoDB همین کار با یک شیء فیلتر انجام میشود.
کد پایتون زیر با کتابخانهی pymongo یک سند را وارد و بعد جستجو میکند:
from pymongo import MongoClient

db = MongoClient("mongodb://localhost:27017")["school"]
db.people.insert_one({"firstname": "Sara", "age": 29, "city": "Shiraz"})
for doc in db.people.find({"age": {"$lt": 40}}, {"_id": 0, "firstname": 1, "age": 1}):
    print(doc)
طراحی ذخیره گفتوگوهای دستیار با پایگاه داده سندی
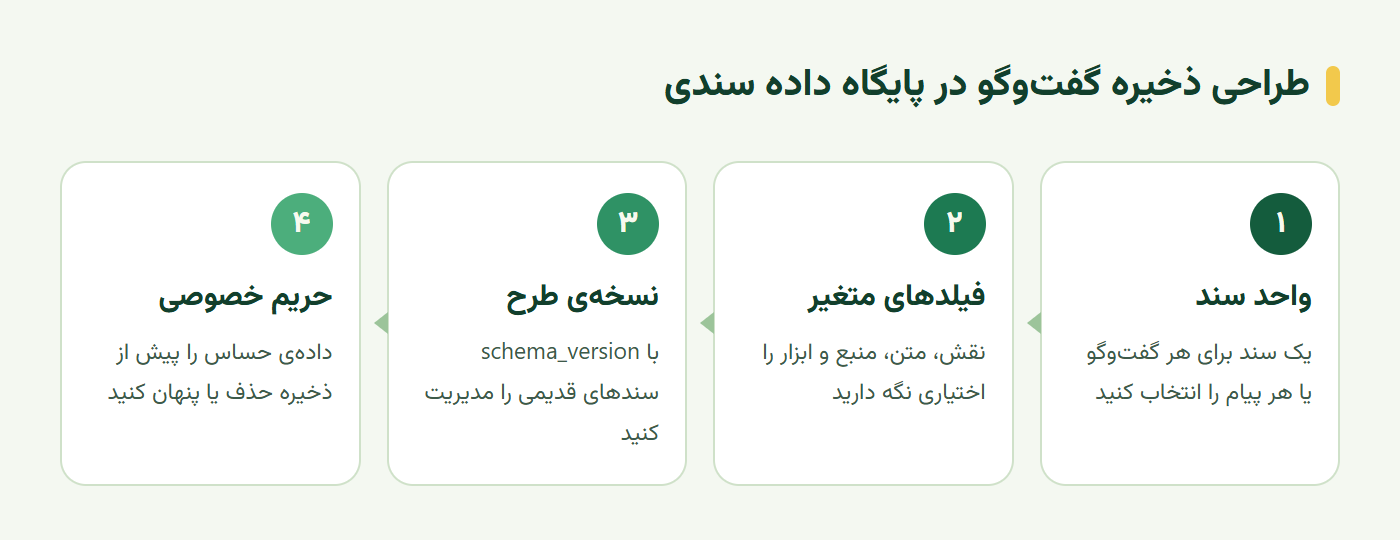
حالا به کاربرد اصلی میرسیم. پیامهای دستیار هوش مصنوعی نمونهی کلاسیک دادهی متغیر است. در پایگاه دادهی سندی، هر گفتوگو میتواند یک سند باشد که فهرستی از پیامها را در خود دارد. نمودار زیر چهار تصمیم اصلی این طراحی را نشان میدهد.
یک سند برای هر گفتوگو
در این طرح، سند گفتوگو شناسهی کاربر، زمان شروع و فهرست پیامها را دارد. هر پیام نقش، متن و فیلدهای اختیاری مثل منابع یا فراخوانی ابزار دارد:
{
"id": "conv-2031",
"user_id": "u-118",
"started_at": "2026-10-27T09:12:00Z",
"messages": [
{"role": "user", "text": "پیشنیاز دوره پایتون پیشرفته چیست؟"},
{"role": "assistant", "text": "دوره پایتون مقدماتی.", "sources": ["course-12"]},
{"role": "tool", "name": "check_enrollment", "result": {"passed": true}}
],
"schema_version": 2
}سه پیام سه شکل متفاوت دارند و همه در یک سند جا میگیرند. خواندن کل گفتوگو هم با یک درخواست انجام میشود، بدون هیچ JOIN.
محدودیتها و نسخهی طرح
این طرح یک محدودیت دارد. اگر گفتوگو بسیار طولانی شود، سند بزرگ میشود و بیشتر پایگاهها سقف اندازهی سند دارند. برای گفتوگوهای طولانی، میشود هر پیام را سند جدا با شناسهی گفتوگو ذخیره کرد.
به فیلد schema_version هم دقت کنید. نبود طرح ثابت به معنای نبود طرح نیست. کد شما هنوز انتظار شکل مشخصی دارد. با نسخهگذاری طرح، وقتی شکل سند را تغییر میدهید، کد میداند با سندهای قدیمی چه کند. پیش از ذخیره هم دادهی شخصی حساس را حذف یا پنهان کنید، همانطور که در قسمت اخلاق داده گفتیم.
تمرین عملی؛ SQL یا NoSQL؟
برای دستیار آموزشی، هر بخش از داده را بررسی کنید و بهترین نوع ذخیرهسازی را انتخاب کنید:
- فهرست دورهها و ثبتنامها: رابطهای یا سندی؟ دلیل را بنویسید.
- گفتوگوهای کاربران: یک سند برای هر گفتوگو یا یک سند برای هر پیام؟
- پیشنیاز دورهها: جدول رابطهای کافی است یا گراف لازم است؟
- وضعیت موقت نشست: آیا کلید-مقدار با زمان انقضا مناسبتر است؟
یک سند نمونهی گفتوگو بنویسید که دستکم سه نوع پیام داشته باشد. بعد یک پرسوجو طراحی کنید که همهی گفتوگوهای شامل فراخوانی یک ابزار خاص را پیدا کند.
سخن پایانی
NoSQL خانوادهای از پایگاههای دادهی غیررابطهای است که طرح ثابت ندارند. چهار نوع اصلی آن کلید-مقدار، سندی، گراف و ستونیاند و هرکدام برای مسئلهی خاصی ساخته شدهاند. پایگاه دادهی سندی با سندهای شبیه JSON رایجترین انتخاب برای دادهی متغیر است.
برای دستیار هوش مصنوعی، ترکیب هر دو دنیا معمولاً بهترین است. دادهی ساختاریافته و رابطهای مثل دورهها و ثبتنامها در SQL و گفتوگوهای متغیر در پایگاه دادهی سندی. هر ابزار را برای کاری انتخاب کنید که برایش ساخته شده است.
این آموزش بر پایهی درس Working with Data: Non-Relational Data از مجموعهی آزاد Data Science for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
NoSQL چیست؟
NoSQL نام کلی روشهای ذخیرهی دادهی غیررابطهای است. این پایگاههای داده برخلاف SQL طرح ثابت جدول ندارند و داده را به شکل سند، جفت کلید-مقدار، گراف یا ستون نگه میدارند. نام آن را معمولاً «نه فقط SQL» تفسیر میکنند.
انواع پایگاه داده NoSQL کداماند؟
چهار نوع اصلی دارد؛ کلید-مقدار مثل Redis برای دسترسی سریع با کلید، سندی مثل MongoDB برای اسناد JSON، گراف مثل Neo4j برای رابطههای پیچیده، و ستونی مثل Cassandra برای حجم عظیم داده با ستونهای گروهبندیشده.
کی از NoSQL به جای SQL استفاده کنیم؟
وقتی شکل داده متغیر است، رکوردها ساختار تودرتو دارند یا به مقیاسپذیری افقی نیاز دارید، NoSQL مناسبتر است. وقتی رابطههای دقیق بین جدولها، تراکنشهای چندجدولی و پرسوجوهای پیچیدهی گزارشی مهم است، پایگاه داده رابطهای بهتر است.
پایگاه داده سندی چیست؟
پایگاه دادهی سندی داده را به شکل سندهایی شبیه JSON ذخیره میکند. هر سند مجموعهای از فیلد و مقدار است و میتواند شیء یا فهرست تودرتو داشته باشد. سندهای یک مجموعه لازم نیست فیلدهای یکسان داشته باشند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.