
تحلیل اکتشافی داده همان کاری است که یک کارآگاه پیش از متهم کردن کسی انجام میدهد. سرنخها را جمع میکند، چیزهای عجیب را یادداشت میکند و فرضیه میسازد. در پروژهی داده، EDA به شما میگوید داده چه چیزی میتواند بگوید و چه چیزی نمیتواند. بدون آن، مدل شما روی حدس ساخته میشود.
در قسمتهای قبل داده را خواندیم، پاکسازی کردیم و ذخیره کردیم. حالا پیش از مدلسازی، با داده آشنا میشویم. در این قسمت با یک مجموعهدادهی واقعی از ۵۳۰ آهنگ نیجریهای کار میکنیم. هدف نهایی این است که بفهمیم آیا آهنگها گروههای طبیعی دارند که بعداً با خوشهبندی پیدایشان کنیم.
تحلیل اکتشافی داده چیست و چرا مهم است؟
تحلیل اکتشافی داده فرایند آشنایی با داده پیش از مدلسازی است. در این مرحله هنوز فرضیهی قطعی ندارید. با نگاه به خلاصهها و نمودارها، فرضیه میسازید. EDA به سؤالهایی جواب میدهد که در مرحلهی جمعآوری پرسیدید؛ آیا داده کافی است و کیفیتش برای این مسئله قابل قبول است؟
EDA گاهی سؤال شما را هم عوض میکند. ممکن است بفهمید داده برای پیشبینی چیزی که میخواستید کافی نیست. در عوض، برای سؤال دیگری که به ذهنتان نرسیده بود، مناسب است. این کشف در ابتدای پروژه ارزان است و در انتهای آن بسیار گران.
چهار پرسش اصلی EDA
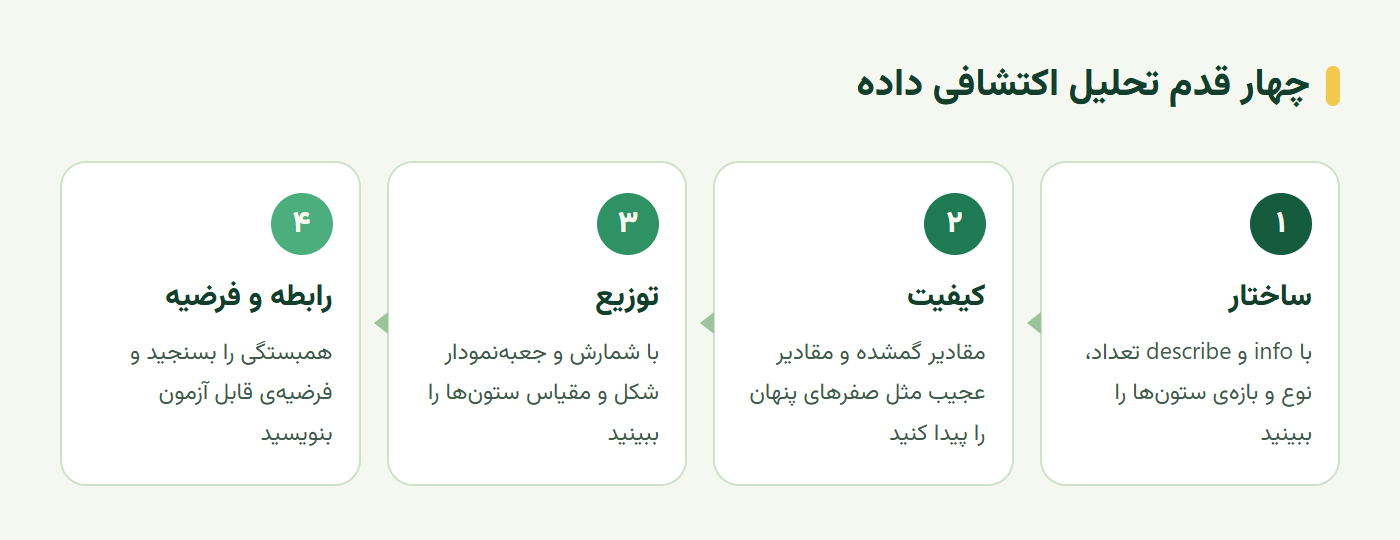
هر تحلیل اکتشافی دستکم به این چهار پرسش پاسخ میدهد:
- ساختار: چند ردیف و ستون داریم و نوع هر ستون چیست؟
- کیفیت: کجا مقدار گمشده، تکراری یا عجیب داریم؟
- توزیع: هر ستون چه شکلی دارد و دادهی پرت کجاست؟
- رابطه: کدام ستونها با هم تغییر میکنند؟
ترتیب این پرسشها مهم است. تا ساختار و کیفیت را نفهمید، نمودار توزیع ممکن است گمراهکننده باشد.
قدم اول؛ ساختار و کیفیت داده
دادهی این قسمت از Spotify جمع شده و در مخزن ML for Beginners در دسترس است. هر ردیف یک آهنگ است. ستونهایی مثل نام، خواننده، ژانر، سال انتشار، محبوبیت و ویژگیهای صوتی مثل رقصپذیری، انرژی و آکوستیک بودن دارد.
info، isnull و describe
سه دستور ساده تصویر کلی را میدهند. info() نشان میدهد ۵۳۰ ردیف و ۱۶ ستون داریم. چهار ستون متنی و بقیه عددیاند. isnull().sum() هم نشان میدهد هیچ مقدار خالی نداریم.
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

df = pd.read_csv("nigerian-songs.csv")
df.info()
print(df.isnull().sum().sum())
print(df.describe().T[["mean", "50%", "min", "max"]])
describe() خلاصهی آماری ستونهای عددی را میدهد. از همین جدول چند چیز جالب پیدا میشود. میانگین سال انتشار حدود ۲۰۱۵ است، پس داده بیشتر آهنگهای جدید را دارد. طول آهنگها به میلیثانیه است و بازهاش با بقیهی ستونها بسیار متفاوت است.
مقدار عجیب؛ محبوبیت صفر
به ستون محبوبیت دقت کنید. کمینه صفر است و چارک اول هم صفر. یعنی دستکم یکچهارم آهنگها محبوبیت صفر دارند. آیا واقعاً هیچکس این آهنگها را گوش نداده است؟ احتمالاً نه. صفر در اینجا یعنی «رتبهبندی نشده».
این دقیقاً همان مقدار عجیبی است که EDA باید پیدا کند. صفر در این ستون مقدار گمشدهای است که خودش را به شکل عدد درآورده است. اگر آن را واقعی فرض کنید، هر تحلیل محبوبیت منحرف میشود. تصمیم منطقی حذف این ردیفها از تحلیل محبوبیت است.
بیشتر بخوانید: مقادیر گمشدهای که به شکل صفر یا رشتهی خالی پنهان شدهاند را در پاکسازی داده با pandas با جزئیات بررسی کردهایم.
قدم دوم؛ توزیع و دستهها
حالا که ساختار را میشناسیم، به شکل داده نگاه میکنیم. برای ستونهای دستهای، شمارش هر دسته مهم است. برای ستونهای عددی، شکل توزیع و دادهی پرت.
پرتکرارترین ژانرها
با value_counts میبینیم هر ژانر چند آهنگ دارد. نتیجه نشان میدهد سه ژانر afro dancehall، afropop و nigerian pop بیشتر داده را پوشش میدهند. تعدادی آهنگ هم ژانر «Missing» دارند که باز یک مقدار گمشدهی پنهان است.
top = df["artist_top_genre"].value_counts()
print(top.head(6))

df = df[(df["artist_top_genre"] != "Missing") & (df["popularity"] > 0)]
df = df[df["artist_top_genre"].isin(["afro dancehall", "afropop", "nigerian pop"])]
print(len(df))
با این فیلتر، روی سه ژانر اصلی و آهنگهای دارای رتبه تمرکز میکنیم. این تصمیم را در گزارش ثبت کنید. هر نتیجهای که بعداً میگیرید، فقط برای همین زیرمجموعه معتبر است.
جعبهنمودار؛ دیدن پراکندگی و دادهی پرت
جعبهنمودار برای هر ستون عددی میانه، چارکها و دادهی پرت را نشان میدهد. وقتی چند ستون را کنار هم رسم کنید، تفاوت مقیاسها هم دیده میشود. ستونهایی مثل رقصپذیری بین صفر و یکاند، اما سرعت ضرب یا tempo حدود صد است.
این تفاوت مقیاس برای خوشهبندی بسیار مهم است. خوشهبندی بر فاصله تکیه دارد. اگر مقیاسبندی نکنید، ستون tempo بهتنهایی فاصلهها را تعیین میکند و بقیهی ویژگیها عملاً نادیده گرفته میشوند.
قدم سوم؛ رابطه ویژگیها با همبستگی
آخرین پرسش EDA این است که ستونها چطور با هم تغییر میکنند. ماتریس همبستگی ابزار سریع این کار است. نمودار زیر چهار قدم تحلیل اکتشافی داده را که تا اینجا دیدیم خلاصه میکند.
ماتریس همبستگی و نقشهی حرارتی
ضریب همبستگی عددی بین منفی یک و یک است. نزدیک به یک یعنی دو ستون با هم بالا میروند و نزدیک به منفی یک یعنی یکی بالا و دیگری پایین میرود. نقشهی حرارتی این ماتریس را رنگی نشان میدهد تا الگوها سریع دیده شوند.
corr = df.select_dtypes("number").corr()
plt.figure(figsize=(9, 7))
sns.heatmap(corr, cmap="vlag", center=0, annot=True, fmt=".1f")
plt.tight_layout()
plt.show()
در این داده، رابطهی قوی بین انرژی و بلندی صدا دیده میشود. این منطقی است؛ آهنگهای پرانرژی معمولاً بلندترند. اما بیشتر ویژگیها همبستگی ضعیفی با هم دارند. این یعنی هرکدام اطلاعات نسبتاً مستقلی میدهند.
همبستگی علیت نیست
یک هشدار مهم؛ همبستگی فقط میگوید دو ستون با هم تغییر میکنند، نه اینکه یکی باعث دیگری است. ممکن است عامل سومی هر دو را تغییر دهد. همبستگی هم فقط رابطهی خطی را میسنجد. رابطهای مثل U شکل با ضریب نزدیک صفر هم دیده نمیشود.
برای خوشهبندی، همبستگی بسیار بالا بین دو ستون یعنی اطلاعات تکراری. اگر هر دو را نگه دارید، آن جنبه از داده دو بار در فاصله حساب میشود. پس معمولاً یکی را کنار میگذارید یا با کاهش بعد ترکیبشان میکنید.
از EDA تا فرضیه؛ آیا داده خوشهپذیر است؟
هدف نهایی ما این بود که بفهمیم آیا آهنگها گروههای طبیعی دارند. نمودار پراکنش دو ویژگی، با رنگ ژانر، سرنخ خوبی میدهد. اگر نقطههای هر ژانر در ناحیهی جداگانهای جمع شوند، خوشهبندی احتمالاً گروههای معناداری پیدا میکند.
نمودار پراکنش و مرز ژانرها
در این داده، وقتی محبوبیت را در برابر رقصپذیری رسم میکنیم، ژانرها همپوشانی زیادی دارند. مرز روشنی بین آنها نیست. این نتیجهی مهمی است. میگوید خوشهبندی با این دو ویژگی احتمالاً ژانرها را از هم جدا نمیکند.
این شکست نیست؛ یک یافته است. EDA نشان داد باید ویژگیهای دیگری را امتحان کنیم یا انتظارمان را اصلاح کنیم. در قسمت خوشهبندی با K-Means، همین داده را با ویژگیهای مقیاسشده دوباره بررسی میکنیم.
گزارش EDA چه چیزی دارد؟
خروجی EDA یک گزارش کوتاه است، نه یک نوتبوک پر از نمودار. این گزارش باید بگوید داده چه شکلی دارد، چه مشکلاتی پیدا شد و چه تصمیمی دربارهشان گرفتید. فرضیههای قابل آزمون هم برای مرحلهی بعد پیشنهاد میدهد.
در این مثال، گزارش میگوید: محبوبیت صفر یعنی رتبهبندی نشده و حذف شد. سه ژانر اصلی بیشتر داده را پوشش میدهند. مقیاس ستونها بسیار متفاوت است و پیش از خوشهبندی باید استاندارد شوند. انرژی و بلندی صدا همبستگی بالایی دارند.
تمرین عملی؛ گزارش EDA یکصفحهای
یک مجموعهداده انتخاب کنید و گزارشی با این بخشها بنویسید:
- ساختار: تعداد ردیف و ستون، نوع ستونها و بازهی زمانی داده.
- مقادیر عجیب: دستکم یک مقدار گمشدهی پنهان مثل صفر یا «Missing» و تصمیم شما دربارهاش.
- توزیع: جعبهنمودار سه ستون عددی و توضیح تفاوت مقیاسها.
- رابطه: نقشهی حرارتی همبستگی و دو رابطهی قوی با تفسیر منطقی.
- فرضیه: یک فرضیهی قابل آزمون برای مرحلهی مدلسازی.
گزارش را برای کسی بنویسید که داده را ندیده است. اگر او با خواندنش بفهمد داده برای چه کاری مناسب است، EDA شما موفق بوده است.
سخن پایانی
تحلیل اکتشافی داده چهار پرسش ساده دارد؛ ساختار، کیفیت، توزیع و رابطه. در مثال آهنگهای نیجریهای، همین چهار پرسش مقادیر گمشدهی پنهان، تفاوت بزرگ مقیاسها و همپوشانی ژانرها را نشان داد. هیچکدام از اینها بدون EDA دیده نمیشد.
مهمترین خروجی EDA نمودار نیست، تصمیم است. کدام ردیفها حذف شوند، کدام ستونها مقیاسبندی شوند و چه فرضیهای آزموده شود. این تصمیمها را مکتوب کنید تا مرحلهی مدلسازی روی زمین محکم بنا شود.
این آموزش بر پایهی درس Introduction to Clustering از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
تحلیل اکتشافی داده چیست؟
تحلیل اکتشافی داده یا EDA فرایند آشنایی با داده پیش از مدلسازی است. با خلاصهی آماری، نمودار و پرسوجو، ساختار داده، مقادیر عجیب، توزیع ستونها و رابطهی آنها را پیدا میکنید تا بدانید داده برای سؤال شما مناسب است یا نه.
مراحل EDA کداماند؟
معمولاً چهار قدم دارد؛ بررسی ساختار با info و describe، پیدا کردن مقادیر عجیب و گمشده، بررسی توزیع هر ستون با هیستوگرام یا جعبهنمودار، و بررسی رابطهی ستونها با نمودار پراکنش و ماتریس همبستگی.
همبستگی بالا بین دو ویژگی یعنی چه؟
یعنی وقتی یکی بالا میرود، دیگری هم معمولاً بالا یا پایین میرود. همبستگی نزدیک به یک یا منفی یک رابطهی خطی قوی را نشان میدهد. اما همبستگی علیت نیست و دو ویژگی بسیار همبسته ممکن است اطلاعات تکراری به مدل بدهند.
چرا پیش از خوشهبندی باید EDA انجام داد؟
چون خوشهبندی به فاصلهی نقطهها حساس است. EDA نشان میدهد کدام ستونها مقیاس متفاوت دارند، کدام دادهی پرت دارند و آیا اصلاً گروههای طبیعی در داده دیده میشود. بدون این بررسی، خوشهها ممکن است فقط بازتاب مقیاس یا نویز باشند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.