
رگرسیون خطی چیست و چرا با وجود این همه مدل پیچیده، هنوز نقطهی شروع هر پروژهی پیشبینی عددی است؟ چون ساده، سریع و قابل توضیح است. اگر مدل پیچیدهی شما از رگرسیون خطی بهتر نیست، پیچیدگیاش ارزشی ندارد. رگرسیون خطی خط پایهای است که هر مدل دیگری باید از آن عبور کند.
در قسمت مهندسی ویژگی، دادهی قیمت کدو تنبل را آماده کردیم. حالا روی همان داده اولین مدل واقعی را میسازیم. در این قسمت ریاضی سادهی پشت رگرسیون خطی را میفهمیم، مدل را با scikit-learn آموزش میدهیم و یاد میگیریم خطایش را تفسیر کنیم.
رگرسیون خطی چیست؟
رگرسیون خطی برای پیشبینی یک مقدار عددی به کار میرود؛ مثل قیمت خانه، دما یا فروش ماه آینده. این روش خطی مستقیم پیدا میکند که رابطهی ویژگی ورودی و خروجی را بهتر از هر خط دیگری نشان دهد. آن خط دو کار انجام میدهد؛ رابطهی متغیرها را نشان میدهد و برای دادهی تازه پیشبینی میکند.
کمترین مربعات؛ کدام خط بهترین است؟
بینهایت خط میشود از میان نقطهها کشید. سؤال این است که کدام بهترین است. روش کمترین مربعات پاسخ میدهد: خطی که مجموع مربع فاصلهی عمودی نقطهها از آن کمترین باشد.
چرا مربع؟ به دو دلیل. اول، خطای منفی پنج و مثبت پنج باید یکسان حساب شوند؛ مربع هر دو را مثبت میکند. دوم، مربع به خطاهای بزرگ وزن بیشتری میدهد. پس خط مجبور میشود از نقطههای دور، دور نماند. البته همین ویژگی رگرسیون خطی را به دادهی پرت حساس میکند.
معادلهی خط؛ شیب و عرض از مبدأ
خط بهترین برازش معادلهی سادهای دارد: Y برابر است با a بهعلاوهی b ضرب در X. در این معادله X متغیر توضیحدهنده و Y متغیر وابسته است. b شیب خط است و a عرض از مبدأ؛ یعنی مقدار Y وقتی X صفر است.
تفسیر شیب ساده و مفید است. اگر در مدل قیمت کدو، شیب برای ماه منفی ۰٫۵ باشد، یعنی با هر ماه جلوتر، قیمت بهطور میانگین نیم دلار کم میشود. همین قابلیت توضیح، رگرسیون خطی را برای گزارش به مدیر بسیار ارزشمند میکند.
همبستگی؛ آیا اصلاً رابطهی خطی هست؟
پیش از ساخت مدل، باید بدانیم آیا رابطهی خطی قابل توجهی وجود دارد. ضریب همبستگی همین را میسنجد. عددی بین منفی یک و یک است و هرچه به یک یا منفی یک نزدیکتر باشد، رابطهی خطی قویتر است.
همبستگی ضعیف با زمان
در دادهی کدو تنبل، دو ویژگی زمانی داریم؛ ماه و روز سال. روز سال را از تاریخ حساب میکنیم تا دقیقتر از ماه باشد. بعد همبستگی هرکدام با قیمت را میگیریم:
from datetime import datetime

pumpkins["DayOfYear"] = pd.to_datetime(pumpkins["Date"]).apply(
    lambda dt: (dt - datetime(dt.year, 1, 1)).days)
print(pumpkins["Month"].corr(pumpkins["Price"]))
print(pumpkins["DayOfYear"].corr(pumpkins["Price"]))
نتیجه ناامیدکننده است؛ حدود منفی ۰٫۱۵ برای ماه و منفی ۰٫۱۷ برای روز سال. یعنی رابطهی خطی بسیار ضعیفی بین زمان و قیمت هست. آیا این یعنی زمان اهمیتی ندارد؟ نه لزوماً.
عامل پنهان؛ نوع کدو
وقتی نمودار پراکنش روز سال و قیمت را با رنگبندی بر اساس نوع کدو رسم کنیم، الگو عوض میشود. هر نوع کدو بازهی قیمت خودش را دارد. کدوهای تزئینی و کدوهای مخصوص پای قیمت کاملاً متفاوتی دارند.
پس نوع کدو اثر بسیار بیشتری از تاریخ فروش روی قیمت دارد. این همان نقشی است که EDA بازی میکند. اگر مستقیم مدل را روی همهی داده میساختیم، نتیجهی ضعیف را به الگوریتم نسبت میدادیم. در حالی که مشکل ترکیب گروههای متفاوت بود.
بیشتر بخوانید: روش ساخت ویژگی روز سال، یکسان کردن واحد بوشل و Pipeline بدون نشت داده را در مهندسی ویژگی چیست؟ دیدیم.
ساخت مدل رگرسیون خطی با scikit-learn
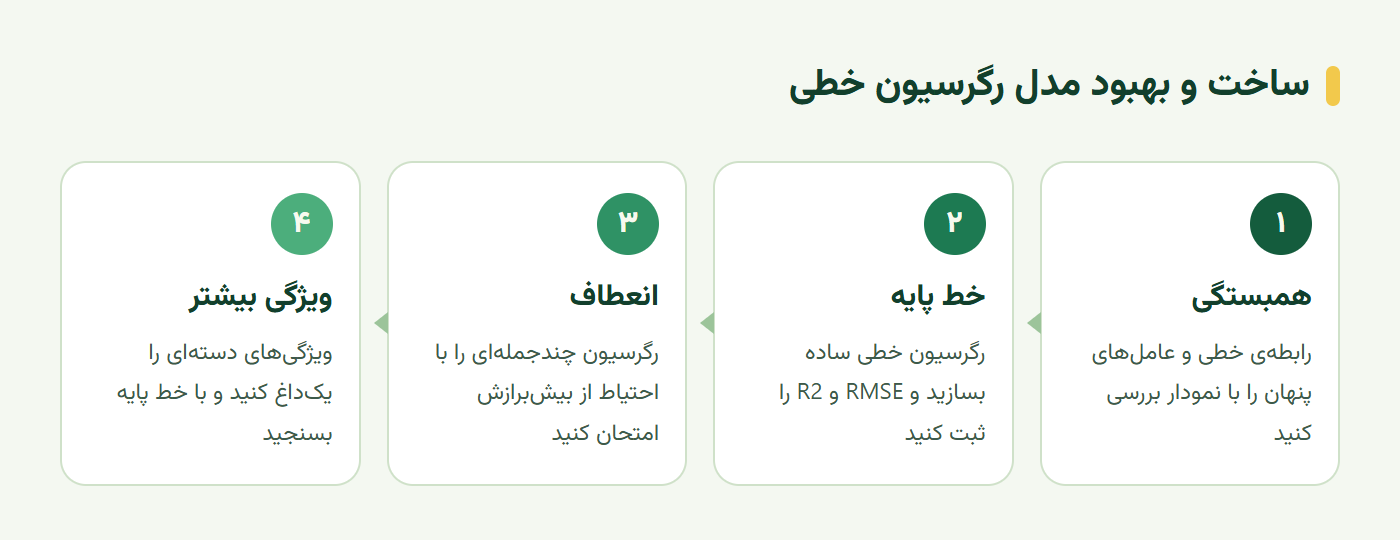
برای حذف اثر نوع کدو، اول فقط روی یک نوع تمرکز میکنیم؛ کدوی مخصوص پای. بعد مدلی میسازیم که از روز سال قیمت را پیشبینی کند. نمودار زیر مسیر ساخت و ارزیابی مدل را نشان میدهد.
آموزش و پیشبینی
داده را به آموزش و آزمون تقسیم میکنیم و مدل را آموزش میدهیم. scikit-learn انتظار دارد ورودی دوبعدی باشد، پس از دو کروشه استفاده میکنیم:
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score
from sklearn.model_selection import train_test_split

pie = pumpkins[pumpkins["Variety"] == "PIE TYPE"]
X, y = pie[["DayOfYear"]], pie["Price"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

lin = LinearRegression().fit(X_train, y_train)
pred = lin.predict(X_test)
rmse = np.sqrt(mean_squared_error(y_test, pred))
print(f"slope={lin.coef_[0]:.3f}  RMSE={rmse:.2f}  ({rmse / y_test.mean():.0%})  R2={r2_score(y_test, pred):.2f}")
تفسیر RMSE و R2
RMSE یا ریشهی میانگین مربع خطا، خطای معمول پیشبینی را به همان واحد هدف نشان میدهد. اینجا یعنی دلار. تقسیم آن بر میانگین قیمت، خطای نسبی را میدهد که برای گزارش به مدیر گویاتر است. مثلاً «پیشبینیها بهطور معمول حدود ۱۷ درصد خطا دارند».
R2 یا ضریب تعیین نشان میدهد مدل چه نسبتی از تغییرات قیمت را توضیح میدهد. برای مدل تکویژگی روز سال، R2 بسیار پایین است. یعنی روز سال بهتنهایی قیمت را توضیح نمیدهد، حتی در یک نوع کدو. این نتیجهی بدی نیست؛ خط پایهی ماست.
رگرسیون چندجملهای و ویژگیهای بیشتر
از خط پایه دو راه برای بهبود داریم. راه اول انعطاف بیشتر به شکل رابطه است. راه دوم ویژگیهای بیشتر است. هر دو را امتحان میکنیم و نتیجه را با خط پایه مقایسه میکنیم.
رگرسیون چندجملهای؛ اجازهی خم شدن
شاید رابطهی قیمت و زمان خمیده باشد؛ مثلاً قیمت در ابتدای فصل بالا، در میانه پایین و در انتها دوباره بالا. رگرسیون چندجملهای با افزودن توانهای ویژگی این شکل را مدل میکند:
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures

poly = make_pipeline(PolynomialFeatures(2), LinearRegression()).fit(X_train, y_train)
در دادهی کدو، مدل درجهی دو بهبود کوچکی میدهد. درجهی بالاتر را هم میشود امتحان کرد، اما مراقب باشید. با درجهی زیاد، منحنی از روی تکتک نقطههای آموزش رد میشود و روی دادهی تازه بد عمل میکند. این همان بیشبرازش است.
افزودن نوع کدو با رمزگذاری یکداغ
بهبود بزرگ از ویژگی درست میآید، نه از مدل پیچیدهتر. به جای محدود کردن داده به یک نوع، نوع کدو، شهر و نوع بسته را با رمزگذاری یکداغ بهعنوان ویژگی اضافه میکنیم. حالا مدل میداند هر نوع کدو سطح قیمت خودش را دارد.
با این ویژگیها، R2 بهطور چشمگیری بالا میرود و خطای نسبی کم میشود. این مقایسه درس مهمی دارد. چند ساعت فکر دربارهی ویژگیها معمولاً بیش از روزها تنظیم مدل ارزش دارد. عدد دقیق را خودتان روی داده اجرا و ثبت کنید.
تمرین عملی؛ جدول مقایسهی مدلها
روی دادهی کدو تنبل یا دادهی عددی خودتان، این چهار مدل را بسازید و نتیجه را در یک جدول ثبت کنید:
- پیشبینی ثابت: همیشه میانگین قیمت آموزش را پیشبینی کنید.
- رگرسیون خطی تکویژگی: فقط با روز سال.
- رگرسیون چندجملهای: درجهی دو و سه با همان ویژگی.
- رگرسیون خطی چندویژگی: با افزودن ویژگیهای دستهای یکداغ.
برای هر مدل RMSE، خطای نسبی و R2 روی دادهی آزمون را بنویسید. بعد یک جمله بنویسید که کدام تغییر بیشترین بهبود را داد و چرا.
سخن پایانی
رگرسیون خطی خطی پیدا میکند که مجموع مربع خطاها کمترین باشد. شیب و عرض از مبدأ آن قابل تفسیرند و همین آن را به بهترین خط پایه تبدیل میکند. RMSE خطا را به واحد هدف نشان میدهد و R2 نسبت تغییرات توضیحدادهشده را.
دادهی کدو تنبل نشان داد همبستگی ضعیف گاهی نشانهی عامل پنهان است، نه نبود رابطه. و بزرگترین بهبود از افزودن ویژگی درست آمد، نه از مدل پیچیدهتر. این درس را در همهی پروژههای پیشبینی به خاطر بسپارید.
این آموزش بر پایهی درس Build a regression model using Scikit-learn: regression four ways از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
رگرسیون خطی چیست؟
رگرسیون خطی روشی برای پیشبینی یک مقدار عددی است. خط یا صفحهای پیدا میکند که رابطهی ویژگیهای ورودی و خروجی را بهتر از هر خط دیگری نشان دهد. معادلهی سادهاش Y = a + bX است که b شیب و a عرض از مبدأ است.
روش کمترین مربعات یعنی چه؟
یعنی خطی را پیدا کنیم که مجموع مربع فاصلهی عمودی نقطهها از خط کمترین باشد. مربع گرفتن دو فایده دارد؛ خطای مثبت و منفی را یکسان حساب میکند و به خطاهای بزرگ وزن بیشتری میدهد.
R2 یا ضریب تعیین چه چیزی را نشان میدهد؟
R2 نشان میدهد مدل چه نسبتی از تغییرات هدف را توضیح میدهد. عدد یک یعنی توضیح کامل و صفر یعنی مدل بهتر از پیشبینی ثابت میانگین نیست. R2 را همیشه کنار یک معیار خطا مثل RMSE گزارش کنید.
رگرسیون چندجملهای چه فرقی با رگرسیون خطی دارد؟
رگرسیون چندجملهای با افزودن توانهای ویژگی، مثل مربع و مکعب، به مدل اجازه میدهد منحنی بسازد. در واقع هنوز نسبت به ضرایب خطی است، اما رابطهی خمیده را هم مدل میکند. درجهی بالا خطر بیشبرازش را زیاد میکند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.