
طبقهبندی در یادگیری ماشین یکی از رایجترین کارهایی است که از هوش مصنوعی خواسته میشود. موضوع پیام پشتیبانی چیست؟ این نظر مثبت است یا منفی؟ این عکس گواهینامه است یا نه؟ اما بیشتر شکستها در طبقهبندی از الگوریتم نیست. از برچسبی است که درست تعریف نشده، یا دادهای که یک دسته را خیلی بیشتر از بقیه دارد.
در قسمت قبل با رگرسیون لجستیک یک مسئلهی دودویی را حل کردیم. حالا سراغ مسئلهی چندکلاسه میرویم و روی طراحی مسئله تمرکز میکنیم. در این قسمت با دادهای از دستور غذاهای آسیایی کار میکنیم. هدف این است که از روی مواد اولیه، بفهمیم غذا مال کدام کشور است.
طبقهبندی در یادگیری ماشین چیست؟
طبقهبندی شاخهای از یادگیری نظارتشده است و با رگرسیون ریشهی مشترک دارد. تفاوت در خروجی است. رگرسیون عدد پیشبینی میکند و طبقهبندی دسته. مدل از نمونههای برچسبخورده یاد میگیرد که کدام ترکیب ویژگیها به کدام دسته تعلق دارد.
دودویی، چندکلاسه و چندبرچسبی
در طبقهبندی دودویی فقط دو دسته داریم؛ مثل سفید یا نارنجی. در طبقهبندی چندکلاسه چند دسته داریم و هر نمونه دقیقاً به یکی تعلق دارد؛ مثل غذای تایلندی، ژاپنی یا هندی. حالت سومی هم هست به نام چندبرچسبی که هر نمونه میتواند چند برچسب همزمان داشته باشد.
این تفاوت در طراحی مهم است. پیامی که هم دربارهی ثبتنام است و هم دربارهی پرداخت، در مسئلهی چندکلاسه جا نمیگیرد. اگر چنین پیامهایی زیادند، باید مسئله را چندبرچسبی تعریف کنید. این تصمیم را پیش از برچسبگذاری بگیرید، نه بعد از آن.
برچسب را دقیق تعریف کنید
برچسب ستون فقرات طبقهبندی است. اگر دو برچسبگذار برای یک نمونه دو برچسب متفاوت بزنند، مدل هم گیج میشود. پیش از جمعآوری برچسب، برای هر دسته یک تعریف کتبی و چند مثال مرزی بنویسید.
یک آزمون ساده هم وجود دارد. پنجاه نمونه را به دو نفر بدهید تا مستقل برچسب بزنند. اگر در بیش از ده درصد موارد اختلاف داشتند، تعریفها مبهماند. هیچ مدلی از توافق انسانها دقیقتر نمیشود.
داده غذاهای آسیایی؛ مسئلهی چندکلاسه
دادهی این قسمت ۲۴۴۸ دستور غذا از پنج آشپزی آسیایی دارد؛ تایلندی، ژاپنی، چینی، هندی و کرهای. هر ستون یک مادهی اولیه است و مقدار یک یعنی آن ماده در دستور هست. پس ۳۸۴ ستون صفر و یک و یک ستون برچسب داریم.
توزیع دستهها؛ اولین نگاه
با value_counts تعداد هر دسته را میبینیم. نتیجه نابرابر است:
| آشپزی | تعداد دستور |
|---|---|
| کرهای | ۷۹۹ |
| هندی | ۵۹۸ |
| چینی | ۴۴۲ |
| ژاپنی | ۳۲۰ |
| تایلندی | ۲۸۹ |
دستهی کرهای تقریباً سه برابر تایلندی است. مدلی که روی این داده آموزش ببیند، تمایل دارد در موارد مبهم «کرهای» بگوید. چون در آموزش این پاسخ بیشتر پاداش گرفته است.
حذف ویژگیهای بیاثر
با شمارش پرتکرارترین مواد در هر آشپزی، نکتهی جالبی دیده میشود. برنج، سیر و زنجبیل تقریباً در همهی آشپزیها پرتکرارند. این مواد برای تشخیص اینکه غذا مال کجاست کمکی نمیکنند.
حذف چنین ویژگیهایی مدل را سادهتر و گاهی دقیقتر میکند. این همان انتخاب ویژگی است که در قسمت مهندسی ویژگی دیدیم. ویژگیای که در همهی دستهها یکسان است، فقط نویز اضافه میکند.
بیشتر بخوانید: ماتریس درهمریختگی، دقت مثبت و بازیابی را در رگرسیون لجستیک چیست؟ برای مسئلهی دودویی توضیح دادیم.
داده نامتوازن و SMOTE
دادهی نامتوازن در دنیای واقعی بسیار رایج است. تراکنشهای تقلبی، بیماریهای نادر و پیامهای فوری همه کمتعدادند. چند راه برای مقابله با آن وجود دارد. یکی از مشهورترینها SMOTE است.
SMOTE چطور کار میکند؟
SMOTE برای دستههای کمتعداد نمونهی مصنوعی میسازد. برای هر نمونهی واقعی، چند همسایهی نزدیک از همان دسته پیدا میکند. بعد نقطهای تصادفی روی خط بین نمونه و یکی از همسایهها میسازد.
نتیجه این است که همهی دستهها همتعداد میشوند. برخلاف تکرار سادهی نمونهها، SMOTE نمونههای کمی متفاوت میسازد. پس خطر حفظ کردن نمونههای تکراری کمتر است.
اشتباه رایج؛ SMOTE روی کل داده
یک اشتباه بسیار رایج این است که SMOTE را پیش از تقسیم داده روی کل داده اعمال کنیم. در این حالت، نمونههای مصنوعی آزمون از نمونههای واقعی آموزش ساخته میشوند و برعکس. این نشت داده است و دقت آزمون را غیرواقعی بالا میبرد.
روش درست این است که SMOTE فقط روی دادهی آموزش اجرا شود. کتابخانهی imbalanced-learn یک Pipeline مخصوص دارد که این کار را خودکار انجام میدهد:
import pandas as pd
from imblearn.over_sampling import SMOTE
from imblearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

df = pd.read_csv("cuisines.csv")
X = df.drop(columns=["Unnamed: 0", "cuisine", "rice", "garlic", "ginger"])
y = df["cuisine"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, stratify=y, random_state=0)

model = Pipeline([("smote", SMOTE(random_state=0)),
                  ("clf", LogisticRegression(max_iter=2000))]).fit(X_tr, y_tr)
خط پایه و معیار درست
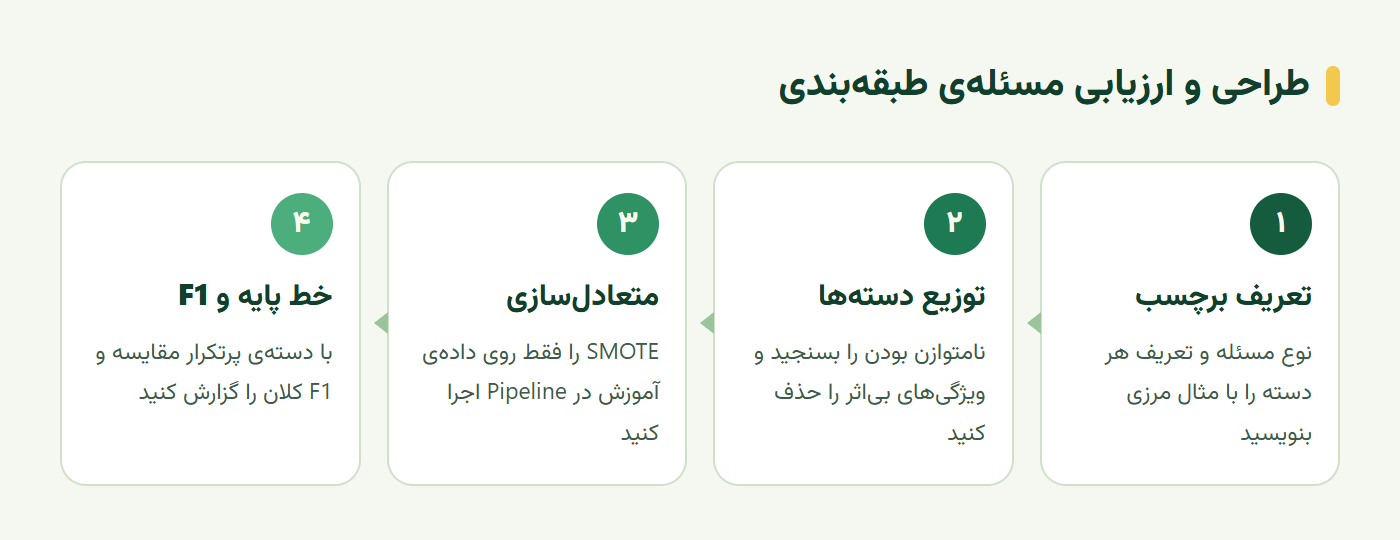
پیش از هر ادعایی دربارهی مدل، به خط پایه نیاز داریم. در دادهی نامتوازن، دقت کلی میتواند بسیار گمراهکننده باشد. نمودار زیر مسیر طراحی و ارزیابی یک مسئلهی طبقهبندی را نشان میدهد.
خط پایهی دستهی پرتکرار
سادهترین خط پایه این است که همیشه پرتکرارترین دسته را پیشبینی کنیم. در دادهی غذاها، این یعنی همیشه «کرهای». دقت این مدل ساده حدود ۳۳ درصد است. هر مدلی که ادعای یادگیری دارد، باید بهوضوح از این عدد بالاتر باشد.
خط پایهی دوم میتواند یک قاعدهی ساده باشد. مثلاً «اگر کیمچی هست، کرهای؛ اگر کاری هست، هندی». اگر مدل یادگیری ماشین از این قاعده بهتر نباشد، پیچیدگیاش توجیه ندارد.
F1 کلان به جای دقت کلی
برای دادهی نامتوازن، F1 کلان معیار صادقانهتری است. ابتدا امتیاز F1 هر دسته جداگانه حساب میشود و بعد میانگین سادهی آنها گرفته میشود. پس دستهی تایلندی با ۲۸۹ نمونه همان وزن دستهی کرهای با ۷۹۹ نمونه را دارد.
from sklearn.metrics import classification_report, f1_score

pred = model.predict(X_te)
print(classification_report(y_te, pred))
print("macro F1:", round(f1_score(y_te, pred, average="macro"), 3))
گزارش طبقهبندی دقت مثبت، بازیابی و F1 هر دسته را جداگانه نشان میدهد. اگر یک دسته F1 بسیار پایینتری دارد، ماتریس درهمریختگی را ببینید. معمولاً معلوم میشود با کدام دسته اشتباه گرفته میشود؛ مثلاً چینی و تایلندی.
از مدل تا اپلیکیشن وب
مدلی که فقط در نوتبوک کار کند، به کاربر نمیرسد. یک راه ساده برای استفاده از مدل در وب، تبدیل آن به قالب ONNX است. ONNX قالبی استاندارد است که مدل را مستقل از پایتون اجرا میکند؛ حتی در مرورگر با جاوااسکریپت.
تبدیل و اجرای مدل
کتابخانهی skl2onnx مدل scikit-learn را به ONNX تبدیل میکند. بعد در یک صفحهی وب، کاربر مواد اولیه را تیک میزند و مدل در همان مرورگر آشپزی پیشنهادی را برمیگرداند. هیچ سروری لازم نیست.
این روش برای مدلهای کوچک و ورودیهای ساده عالی است. اما دقت کنید؛ مرحلهی SMOTE فقط در آموزش لازم است و در مدل نهایی برای پیشبینی جایی ندارد. پیش از تبدیل، فقط مدل آموزشدیده را جدا کنید.
ترتیب ویژگیها را قفل کنید
یک خطای رایج در استقرار، جابهجا شدن ترتیب ستونهاست. مدل انتظار دارد ستون ۱۲۰ مثلاً «سس سویا» باشد. اگر صفحهی وب ترتیب دیگری بفرستد، پیشبینی بیمعنا میشود و هیچ خطایی هم نمیدهد.
فهرست نام ستونها را کنار مدل ذخیره کنید و در کد وب از همان فهرست بردار ورودی را بسازید. این قرارداد ساده، مهمترین قسمت اتصال مدل به محصول است.
تمرین عملی؛ برگهی طراحی طبقهبندی
برای یک مسئلهی طبقهبندی در دستیار آموزشی، مثل تشخیص موضوع پیام، این برگه را پر کنید:
- نوع مسئله: دودویی، چندکلاسه یا چندبرچسبی و دلیل انتخاب.
- تعریف برچسبها: برای هر دسته یک تعریف کتبی و دو مثال مرزی.
- توافق برچسبگذاران: درصد توافق دو نفر روی پنجاه نمونه.
- توزیع دستهها: تعداد هر دسته و نسبت بزرگترین به کوچکترین.
- خط پایه و معیار: دقت دستهی پرتکرار و F1 کلان مدل اول.
اگر توافق برچسبگذاران پایین بود، پیش از هر مدلسازی، تعریفها را اصلاح کنید.
سخن پایانی
طبقهبندی در یادگیری ماشین به هر نمونه یک دسته میدهد و میتواند دودویی، چندکلاسه یا چندبرچسبی باشد. کیفیت آن پیش از هر چیز به تعریف دقیق برچسب و توافق برچسبگذاران بستگی دارد. دادهی نامتوازن هم رایج است و با روشهایی مثل SMOTE، فقط روی دادهی آموزش، متعادل میشود.
برای ارزیابی صادقانه، مدل را با خط پایهی دستهی پرتکرار مقایسه کنید و F1 کلان را گزارش دهید. و وقتی مدل را به محصول میبرید، قرارداد ترتیب ویژگیها را قفل کنید تا خطای بیصدا رخ ندهد.
این آموزش بر پایهی درسهای Introduction to classification و Build a Cuisine Recommender Web App از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
طبقهبندی در یادگیری ماشین چیست؟
طبقهبندی نوعی یادگیری نظارتشده است که به هر نمونه یک برچسب از میان چند دستهی از پیش تعریفشده میدهد. اگر دو دسته باشد، طبقهبندی دودویی و اگر بیشتر باشد، طبقهبندی چندکلاسه نام دارد.
داده نامتوازن چیست و چه مشکلی ایجاد میکند؟
دادهای است که تعداد نمونههای یک یا چند دسته بسیار بیشتر از بقیه است. مدل روی چنین دادهای به سمت دستهی پرتعداد سوگیری پیدا میکند و دستههای کمتعداد را ضعیف تشخیص میدهد، در حالی که دقت کلی ممکن است خوب به نظر برسد.
SMOTE چیست؟
SMOTE روشی برای متعادلسازی داده است که برای دستههای کمتعداد نمونهی مصنوعی میسازد. هر نمونهی تازه بین یک نمونهی واقعی و یکی از همسایههای نزدیکش درونیابی میشود. SMOTE باید فقط روی دادهی آموزش اعمال شود.
F1 کلان یا macro F1 چیست؟
F1 کلان میانگین سادهی امتیاز F1 همهی دستههاست، بدون توجه به تعداد نمونهی هر دسته. پس ضعف مدل در یک دستهی کمتعداد را پنهان نمیکند. برای دادهی نامتوازن معیار صادقانهتری از دقت کلی است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.