
رگرسیون لجستیک چیست و چرا با وجود نامش، مدلی برای دستهبندی است؟ رگرسیون خطی یک عدد پیشبینی میکرد؛ مثل قیمت. اما خیلی از سؤالها جواب بله یا نه دارند. این ایمیل اسپم است یا نه؟ این دانشجو دوره را رها میکند یا نه؟ رگرسیون لجستیک برای همین سؤالها ساخته شده است.
در قسمت قبل با رگرسیون خطی قیمت کدو را پیشبینی کردیم. حالا روی همان داده سؤال دیگری میپرسیم: با دانستن نوع، اندازه و محل کدو، آیا رنگش سفید است یا نارنجی؟ در این قسمت سازوکار رگرسیون لجستیک را میفهمیم، مدل میسازیم و یاد میگیریم احتمال را به تصمیم تبدیل کنیم.
رگرسیون لجستیک چیست و چه فرقی با رگرسیون خطی دارد؟
رگرسیون لجستیک مثل رگرسیون خطی جمع وزندار ویژگیها را حساب میکند. تفاوت در قدم آخر است. حاصل این جمع از تابعی به نام سیگموید عبور میکند. سیگموید هر عددی را به بازهی صفر تا یک فشرده میکند.
تابع سیگموید؛ از عدد به احتمال
منحنی سیگموید شکل S دارد. برای عددهای خیلی منفی نزدیک صفر است، برای صفر دقیقاً نیم، و برای عددهای خیلی مثبت نزدیک یک. پس خروجی مدل را میشود احتمال تعلق به دستهی مثبت تفسیر کرد.
مثلاً اگر مدل برای یک کدو عدد ۰٫۸۲ بدهد، یعنی به احتمال ۸۲ درصد سفید است. این احتمال خودش اطلاعات ارزشمندی است. کدویی با احتمال ۰٫۵۱ و کدویی با احتمال ۰٫۹۹ هر دو «سفید» دستهبندی میشوند، اما اطمینان مدل دربارهشان کاملاً متفاوت است.
تفاوتهای مهم با رگرسیون خطی
چند تفاوت دیگر هم وجود دارد. رگرسیون خطی با متغیرهای همبسته با هدف بهتر کار میکرد. رگرسیون لجستیک به همبستگی خطی نیاز ندارد و روی ویژگیهای دستهای هم خوب کار میکند.
از طرف دیگر، رگرسیون لجستیک برای نتیجهی قابل اعتماد به دادهی تمیز و نسبتاً زیاد نیاز دارد. مجموعهدادههای خیلی کوچک، مخصوصاً وقتی یک دسته کمیاب است، نتیجهی ناپایدار میدهند. این نکته در دادهی کدو که کدوی سفید در آن کم است، اهمیت پیدا میکند.
انواع رگرسیون لجستیک
رگرسیون لجستیک فقط دودویی نیست. سه نوع اصلی دارد که هرکدام برای شکلی از سؤال مناسب است. جدول زیر آنها را مقایسه میکند.
| نوع | تعداد دسته | ترتیب دستهها | مثال |
|---|---|---|---|
| دودویی | دو | ندارد | سفید یا نارنجی |
| چندگانه | بیش از دو | ندارد | نارنجی، سفید یا راهراه |
| ترتیبی | بیش از دو | دارد | کوچک، متوسط، بزرگ |
تعریف سؤال بهصورت دودویی
دادهی کدو دستهی «راهراه» هم دارد، اما نمونههایش بسیار کم است. پس سؤال را دودویی تعریف میکنیم: سفید یا غیرسفید. این تصمیم سادهسازی است و باید در گزارش ذکر شود.
به کدوهای سفید گاهی «کدوی شبح» هم میگویند. کمتر از نوع نارنجی رایجاند، اما ظاهر جالبی دارند. همین کمیاب بودن، مسئله را از نظر آماری چالشبرانگیز میکند. در ادامه اثرش را روی ارزیابی میبینیم.
بیشتر بخوانید: مفهوم خط پایه، RMSE و اثر ویژگی دستهای روی مدل را در رگرسیون خطی چیست؟ دیدیم.
آمادهسازی داده؛ رمزگذاری ترتیبی و یکداغ
همهی ستونهای دادهی کدو برای این سؤال رشتهایاند. پیش از مدلسازی باید به عدد تبدیل شوند. اما همهی ستونها از یک جنس نیستند و هرکدام رمزگذار مناسب خودش را میخواهد.
انتخاب ستون و بررسی با catplot
اول ستونهای لازم را انتخاب و ردیفهای خالی را حذف میکنیم. بعد با catplot در seaborn میبینیم رنگ در هر نوع کدو چطور پخش شده است:
import seaborn as sns

cols = ["City Name", "Package", "Variety", "Origin", "Item Size", "Color"]
pumpkins = full_pumpkins.loc[:, cols].dropna()
sns.catplot(data=pumpkins, y="Variety", hue="Color", kind="count",
            palette={"ORANGE": "orange", "WHITE": "wheat"})
نمودار نشان میدهد کدوی سفید فقط در چند نوع دیده میشود. پس نوع کدو ویژگی مهمی برای پیشبینی رنگ است. این یافتهی EDA به انتخاب ویژگی کمک میکند.
دو رمزگذار در یک ColumnTransformer
اندازهی کدو ترتیب طبیعی دارد؛ از کوچک تا خیلی بزرگ. برای آن رمزگذار ترتیبی مناسب است و ترتیب را باید صریح مشخص کنیم. بقیهی ستونها مثل شهر و نوع، ترتیب ندارند و رمزگذار یکداغ میخواهند:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder, OrdinalEncoder

sizes = [["sml", "med", "med-lge", "lge", "xlge", "jbo", "exjbo"]]
ct = ColumnTransformer([
    ("ord", OrdinalEncoder(categories=sizes), ["Item Size"]),
    ("cat", OneHotEncoder(handle_unknown="ignore"), ["City Name", "Package", "Variety", "Origin"]),
])
X = pumpkins.drop(columns="Color")
y = (pumpkins["Color"] == "WHITE").astype(int)
آموزش و ارزیابی مدل
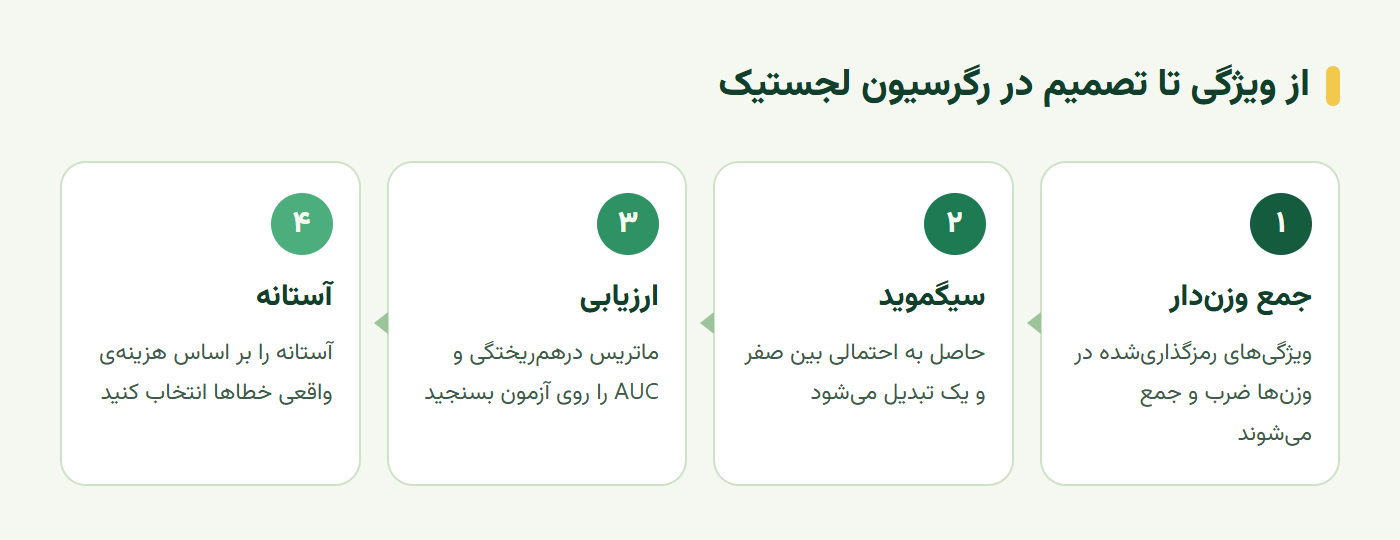
حالا مدل را در یک Pipeline با رمزگذارها آموزش میدهیم. چون کدوی سفید کمیاب است، هنگام تقسیم داده از stratify استفاده میکنیم تا نسبت دو دسته در آموزش و آزمون یکسان بماند. نمودار زیر مسیر از احتمال تا تصمیم را نشان میدهد.
ماتریس درهمریختگی
دقت کلی برای دادهی نامتوازن گمراهکننده است. اگر فقط ۱۵ درصد کدوها سفید باشند، مدلی که همیشه «نارنجی» بگوید ۸۵ درصد دقت دارد. اما حتی یک کدوی سفید را پیدا نمیکند. ماتریس درهمریختگی این مشکل را آشکار میکند.
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix, roc_auc_score
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, stratify=y, random_state=0)
model = Pipeline([("prep", ct), ("clf", LogisticRegression(max_iter=1000))]).fit(X_tr, y_tr)

proba = model.predict_proba(X_te)[:, 1]
print(confusion_matrix(y_te, proba >= 0.5))
print(classification_report(y_te, proba >= 0.5, target_names=["orange", "white"]))
print("AUC:", round(roc_auc_score(y_te, proba), 3))
ماتریس چهار خانه دارد؛ مثبت درست، منفی درست، مثبت کاذب و منفی کاذب. از روی آن دو معیار مهم حساب میشود. دقت مثبت یا Precision میگوید از کدوهایی که مدل سفید گفته، چند درصد واقعاً سفیدند. بازیابی یا Recall میگوید از کدوهای واقعاً سفید، چند درصد را مدل پیدا کرده است.
منحنی ROC و AUC
احتمال خروجی مدل را با یک آستانه به دسته تبدیل میکنیم. پیشفرض ۰٫۵ است، اما هیچ دلیلی ندارد که بهترین باشد. منحنی ROC عملکرد مدل را برای همهی آستانههای ممکن نشان میدهد. محور افقی نرخ مثبت کاذب و محور عمودی نرخ مثبت درست است.
مساحت زیر این منحنی یا AUC یک عدد خلاصه است. یک یعنی جداسازی کامل و نیم یعنی حدس تصادفی. مزیت AUC این است که به آستانه وابسته نیست. پس برای مقایسهی دو مدل، پیش از انتخاب آستانه، معیار مناسبی است.
انتخاب آستانه؛ تصمیم کسبوکاری، نه فنی
انتخاب آستانه به هزینهی خطاها بستگی دارد، نه به ریاضی. در دستیار آموزشی فرض کنید مدل احتمال رها کردن دوره را برای هر دانشجو پیشبینی میکند. دانشجوهایی که بالای آستانهاند، تماس پشتیبانی میگیرند.
دو هزینهی متفاوت
اگر آستانه پایین باشد، دانشجوهای بیشتری تماس میگیرند. بیشتر دانشجوهای در معرض خطر پیدا میشوند، اما هزینهی تماس بالا میرود و بعضی بیدلیل مزاحمت میبینند. اگر آستانه بالا باشد، تماسها دقیقترند، اما بعضی دانشجوهای در معرض خطر از دست میروند.
کدام بدتر است؟ پاسخ را تیم فنی نمیدهد. مدیر آموزش باید بگوید از دست دادن یک دانشجو چقدر هزینه دارد و هر تماس چقدر. با این دو عدد، آستانهای انتخاب میکنید که هزینهی کل کمترین باشد.
احتمال را هم نمایش دهید
یک نکتهی عملی دیگر؛ فقط دسته را به کاربر نشان ندهید. احتمال یا سطح اطمینان را هم نمایش دهید. مشاور آموزشی که میبیند احتمال رها کردن ۹۵ درصد است، رفتار متفاوتی دارد با وقتی که ۵۵ درصد است.
البته احتمالهای رگرسیون لجستیک همیشه دقیقاً کالیبره نیستند. اگر مدل میگوید ۸۰ درصد، باید در عمل حدود ۸۰ درصد این موارد درست باشند. این را هم با نمودار کالیبراسیون بررسی کنید.
تمرین عملی؛ آستانهی بهینه
روی دادهی کدو یا دادهی دودویی خودتان این کارها را انجام دهید:
- خط پایه: مدلی که همیشه دستهی پرتکرار را میگوید بسازید و دقتش را ثبت کنید.
- مدل لجستیک: با Pipeline آموزش دهید و AUC را گزارش کنید.
- سه آستانه: ماتریس درهمریختگی را برای ۰٫۳، ۰٫۵ و ۰٫۷ رسم کنید.
- هزینهی خطا: برای مثبت کاذب و منفی کاذب هزینهی فرضی بگذارید و آستانهی با کمترین هزینهی کل را پیدا کنید.
نتیجه را در یک جمله برای مدیر بنویسید؛ مثلاً «با آستانهی ۰٫۳، از هر ده مورد واقعی هشت مورد پیدا میشود و از هر ده هشدار، شش مورد درست است».
سخن پایانی
رگرسیون لجستیک جمع وزندار ویژگیها را با تابع سیگموید به احتمال تبدیل میکند. سه نوع دودویی، چندگانه و ترتیبی دارد و روی ویژگیهای دستهای با رمزگذاری درست خوب کار میکند. برای ارزیابی، ماتریس درهمریختگی و AUC از دقت کلی بسیار گویاترند.
مهمترین درس این قسمت اما جدایی احتمال از تصمیم است. مدل احتمال میدهد و آستانه آن را به تصمیم تبدیل میکند. انتخاب آستانه یک تصمیم کسبوکاری بر اساس هزینهی خطاهاست و باید با صاحب مسئله گرفته شود.
این آموزش بر پایهی درس Logistic regression to predict categories از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
رگرسیون لجستیک چیست؟
رگرسیون لجستیک مدلی برای دستهبندی است. مثل رگرسیون خطی جمع وزندار ویژگیها را حساب میکند، اما حاصل را از تابع سیگموید عبور میدهد تا عددی بین صفر و یک، یعنی احتمال تعلق به یک دسته، به دست آید.
چرا به رگرسیون لجستیک رگرسیون میگویند در حالی که دستهبندی میکند؟
چون در اصل یک عدد پیوسته، یعنی احتمال، را پیشبینی میکند و ریاضی آن از خانوادهی مدلهای رگرسیون خطی تعمیمیافته است. تبدیل احتمال به دسته با یک آستانه انجام میشود که بخشی از خود مدل نیست.
آستانه تصمیم در دستهبندی چیست؟
عددی است که احتمال را به دسته تبدیل میکند؛ پیشفرض ۰٫۵ است. اگر هزینهی از دست دادن یک نمونهی مثبت زیاد است، آستانه را پایینتر میگذارید و اگر هشدار اشتباه پرهزینه است، بالاتر.
منحنی ROC چه چیزی نشان میدهد؟
منحنی ROC نرخ مثبت درست را در برابر نرخ مثبت کاذب برای همهی آستانههای ممکن رسم میکند. مساحت زیر آن یا AUC نشان میدهد مدل چقدر خوب نمونههای مثبت و منفی را از هم جدا میکند؛ یک یعنی کامل و نیم یعنی تصادفی.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.