
الگوریتمهای طبقهبندی زیادند و هرکدام طرفداران خودش را دارد. اما سؤال «کدام بهتر است؟» بدون داده پاسخی ندارد. الگوریتمی که روی یک مسئله برنده است، روی مسئلهی دیگر ممکن است بازنده باشد. تنها راه مطمئن، یک مقایسهی منصفانه روی دادهی خودتان است.
در قسمت قبل مسئلهی طبقهبندی غذاهای آسیایی را طراحی کردیم و با رگرسیون لجستیک یک مدل اول ساختیم. حالا چند الگوریتم دیگر را روی همان داده امتحان میکنیم. اما مهمتر از خود الگوریتمها، روش مقایسه است. یاد میگیریم چطور مقایسه کنیم که نتیجه قابل اعتماد باشد.
انتخاب الگوریتم؛ از کجا شروع کنیم؟
scikit-learn دهها الگوریتم طبقهبندی دارد. برای شروع، راهنماهای انتخاب مثل نقشهی انتخاب الگوریتم scikit-learn مفیدند. این نقشه بر اساس اندازهی داده و نوع مسئله، چند الگوریتم پیشنهاد میدهد.
استدلال برای دادهی غذاها
با کمی استدلال میشود فهرست را کوتاه کرد. شبکهی عصبی برای دادهی تمیز اما کوچک ما، با حدود دو هزار نمونه، سنگین و بیدلیل پیچیده است. درخت تصمیم تقویتشده بیشتر برای مسائل رتبهبندی ساخته شده است. پس گزینههای معقول، مدلهای خطی، SVM، KNN و روشهای ترکیبیاند.
این استدلال انتخاب نهایی نیست؛ فقط فهرست نامزدها را تعیین میکند. تصمیم نهایی با آزمون گرفته میشود. عادت خوب این است که همیشه یک مدل ساده و یک مدل قویتر را کنار هم امتحان کنید.
طبقهبندی چندکلاسه با مدلهای دودویی
بعضی الگوریتمها ذاتاً دودوییاند. برای استفاده از آنها در مسئلهی چندکلاسه، دو راهبرد وجود دارد. در راهبرد یکی در برابر بقیه یا OvR، برای هر دسته یک مدل دودویی ساخته میشود که آن دسته را از بقیه جدا کند.
در راهبرد چندجملهای، یک مدل واحد مستقیماً احتمال همهی دستهها را با تابع softmax پیشبینی میکند. رگرسیون لجستیک در نسخههای جدید scikit-learn بهطور پیشفرض روش چندجملهای را به کار میبرد. بیشتر وقتها لازم نیست خودتان این را تنظیم کنید، اما دانستنش در تفسیر احتمالها کمک میکند.
شش الگوریتم طبقهبندی در یک نگاه
هر الگوریتم ایدهی متفاوتی برای جدا کردن دستهها دارد. جدول زیر ایدهی اصلی، نقطهی قوت و نقطهی ضعف هرکدام را خلاصه میکند.
| الگوریتم | ایدهی اصلی | نقطهی قوت | نقطهی ضعف |
|---|---|---|---|
| رگرسیون لجستیک | مرز خطی با احتمال | سریع و قابل توضیح | فقط مرز خطی |
| Linear SVC | مرز خطی با بیشترین فاصله | خوب روی دادهی پربعد | احتمال مستقیم نمیدهد |
| KNN | رأی نزدیکترین همسایهها | بدون آموزش، ساده | کند در پیشبینی، حساس به مقیاس |
| SVC با کرنل | مرز غیرخطی با کرنل | دقیق روی دادهی متوسط | کند روی دادهی بزرگ |
| جنگل تصادفی | رأی چندین درخت مستقل | قوی و کمنیاز به تنظیم | حجم مدل بزرگ |
| AdaBoost | درختهای پشت سر هم روی خطاها | تمرکز روی نمونههای سخت | حساس به نویز و برچسب غلط |
SVM و KNN؛ دو نگاه به فاصله
SVM مرزی پیدا میکند که دستهها را با بیشترین فاصله از هم جدا کند. نمونههایی که نزدیک مرزند، بردار پشتیبان نام دارند و مرز را تعیین میکنند. با کرنل، SVM میتواند مرزهای خمیده هم بسازد.
KNN اصلاً مدلی نمیسازد. برای هر نمونهی تازه، k نمونهی نزدیک در دادهی آموزش را پیدا میکند و دستهی اکثریت آنها را برمیگرداند. ساده و شهودی است، اما پیشبینیاش روی دادهی بزرگ کند میشود. به مقیاس ویژگیها هم حساس است.
روشهای ترکیبی؛ خرد جمعی
جنگل تصادفی صدها درخت تصمیم را روی زیرمجموعههای تصادفی داده و ویژگیها میسازد. پیشبینی نهایی رأی اکثریت آنهاست. خطای درختهای منفرد تا حدی همدیگر را خنثی میکنند.
AdaBoost راه دیگری میرود. درختهای کوچک را پشت سر هم میسازد. هر درخت روی نمونههایی که درخت قبلی اشتباه کرده، وزن بیشتری میگذارد. این تمرکز روی نمونههای سخت قدرت اوست، اما اگر برچسبها نویز داشته باشند، ضعفش هم هست.
بیشتر بخوانید: طراحی مسئله، دادهی نامتوازن و معیار F1 کلان را پیش از مقایسه در طبقهبندی در یادگیری ماشین مرور کنید.
مقایسه منصفانه؛ سه قاعده
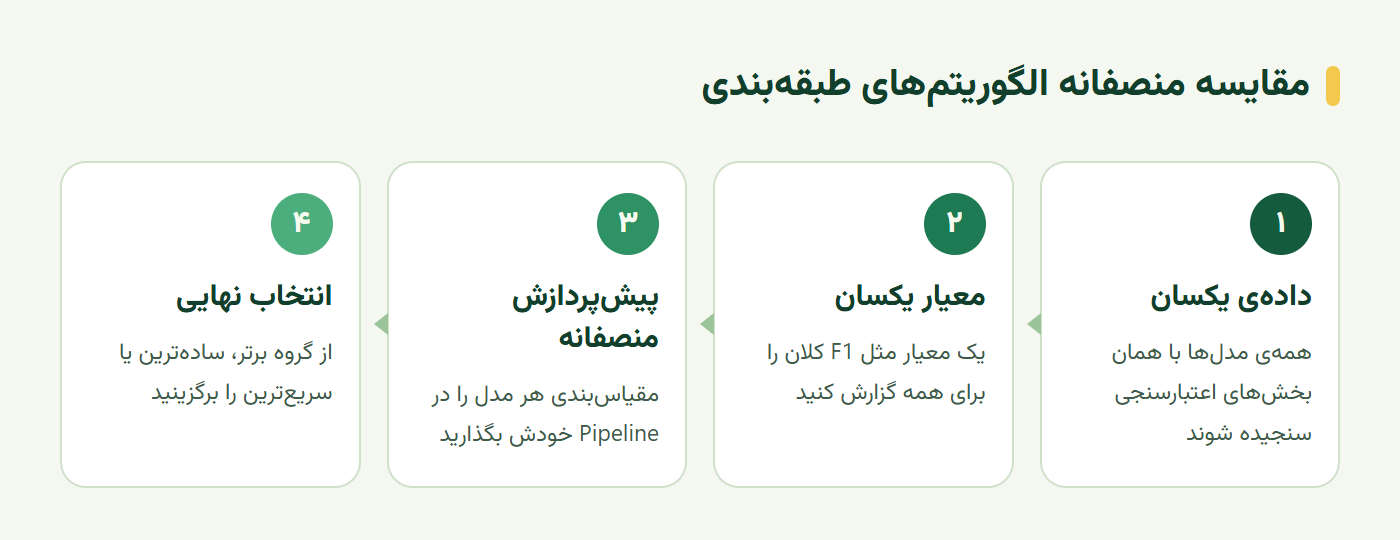
مقایسهی الگوریتمها وقتی منصفانه است که همه در شرایط یکسان سنجیده شوند. بسیاری از ادعاهای «الگوریتم X بهتر است» از مقایسهی ناعادلانه میآیند. نمودار زیر سه قاعدهی اصلی و قدم نهایی را نشان میدهد.
داده، معیار و پیشپردازش یکسان
قاعدهی اول، دادهی یکسان است. همهی مدلها باید با همان تقسیم یا همان بخشهای اعتبارسنجی سنجیده شوند. قاعدهی دوم، معیار یکسان است. اگر F1 کلان را انتخاب کردید، برای همه همان را گزارش کنید.
قاعدهی سوم، پیشپردازش منصفانه است. KNN و SVM به مقیاس حساساند و جنگل تصادفی نیست. اگر مقیاسبندی را فقط برای یکی انجام دهید و برای دیگری نه، مقایسه ناعادلانه است. بهترین راه، قرار دادن پیشپردازش هر مدل در Pipeline خودش است.
اعتبارسنجی متقابل به جای یک تقسیم
یک تقسیم آموزش و آزمون ممکن است از روی شانس به نفع یک مدل باشد. اعتبارسنجی متقابل این شانس را کم میکند. دادهی آموزش به پنج بخش تقسیم میشود و هر مدل پنج بار، هر بار روی یک بخش متفاوت، ارزیابی میشود.
import time
from sklearn.ensemble import AdaBoostClassifier, RandomForestClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC, LinearSVC

models = {
    "logistic": LogisticRegression(max_iter=2000),
    "linear_svc": LinearSVC(C=1),
    "knn": make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=7)),
    "svc_rbf": SVC(C=1),
    "forest": RandomForestClassifier(n_estimators=300, random_state=0),
    "adaboost": AdaBoostClassifier(n_estimators=100, random_state=0),
}
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)
for name, m in models.items():
    t = time.perf_counter()
    s = cross_val_score(m, X_tr, y_tr, cv=cv, scoring="f1_macro")
    print(f"{name:11s} F1={s.mean():.3f} ± {s.std():.3f}  time={time.perf_counter() - t:.1f}s")
تفسیر نتیجه و انتخاب نهایی
خروجی کد بالا برای هر مدل میانگین و انحراف معیار F1 کلان و زمان اجرا را میدهد. انتخاب نهایی اما فقط بالاترین عدد نیست. سه نکتهی دیگر را هم باید در نظر بگیرید.
تفاوت معنادار است یا نه؟
اگر دو مدل F1 نزدیک به هم دارند و انحراف معیارشان همپوشانی دارد، تفاوت احتمالاً معنادار نیست. همانطور که در قسمت آمار دیدیم، تفاوت کوچک روی دادهی کم معمولاً شانس است. در این حالت، مدل سادهتر را انتخاب کنید.
در دادهی غذاها، معمولاً چند مدل در بازهی نزدیکی قرار میگیرند و یکی دو مدل بهوضوح عقب میافتند. عدد دقیق را خودتان اجرا و ثبت کنید. نکته این است که به جای یک برنده، یک گروه از مدلهای خوب پیدا میکنید.
هزینه، سرعت و توضیحپذیری
از میان مدلهای خوب، معیارهای غیرفنی تصمیم میگیرند. آیا پیشبینی باید در کسری از ثانیه انجام شود؟ آیا مدل باید در مرورگر یا گوشی اجرا شود؟ آیا باید برای کاربر توضیح دهید چرا این دسته انتخاب شد؟
رگرسیون لجستیک ضریبهایی دارد که نشان میدهد کدام مادهی اولیه به کدام آشپزی اشاره میکند. جنگل تصادفی ممکن است کمی دقیقتر باشد، اما توضیحش سختتر و حجمش بیشتر است. اگر تفاوت دقت ناچیز است، این ویژگیها برنده را تعیین میکنند.
تمرین عملی؛ جدول مقایسهی منصفانه
روی دادهی غذاها یا دادهی طبقهبندی خودتان، این جدول را کامل کنید:
- خط پایه: F1 کلان مدلی که همیشه دستهی پرتکرار را میگوید.
- شش مدل: میانگین و انحراف معیار F1 کلان با اعتبارسنجی پنجبخشی.
- زمان: زمان آموزش و پیشبینی هر مدل.
- گروه برتر: مدلهایی که تفاوتشان با بهترین مدل کمتر از یک انحراف معیار است.
- انتخاب نهایی: از گروه برتر، یک مدل با دلیل غیرفنی مثل سرعت یا توضیحپذیری.
در پایان، فقط مدل منتخب را یک بار روی دادهی آزمون کنارگذاشته بسنجید و آن عدد را گزارش کنید.
سخن پایانی
الگوریتمهای طبقهبندی هرکدام ایدهی متفاوتی دارند؛ مرز خطی، بیشترین فاصله، نزدیکترین همسایه یا رأی جمعی درختها. اما هیچکدام همیشه بهترین نیست. برنده را فقط آزمون منصفانه روی دادهی خودتان مشخص میکند.
آزمون منصفانه یعنی داده، معیار و پیشپردازش یکسان و اعتبارسنجی متقابل. نتیجه معمولاً یک گروه از مدلهای خوب است، نه یک برندهی قطعی. از این گروه، سادهترین، سریعترین یا قابل توضیحترین را انتخاب کنید.
این آموزش بر پایهی درسهای Cuisine classifiers 1 و Cuisine classifiers 2 از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
بهترین الگوریتم طبقهبندی کدام است؟
الگوریتمی که برای همهی دادهها بهترین باشد وجود ندارد. انتخاب به اندازهی داده، نوع ویژگیها، نیاز به توضیحپذیری و محدودیت زمان و منابع بستگی دارد. تنها راه مطمئن، مقایسهی منصفانهی چند الگوریتم روی دادهی خودتان با اعتبارسنجی متقابل است.
اعتبارسنجی متقابل چیست؟
اعتبارسنجی متقابل دادهی آموزش را به چند بخش، مثلاً پنج بخش، تقسیم میکند. مدل هر بار روی چهار بخش آموزش میبیند و روی بخش پنجم ارزیابی میشود. میانگین و انحراف معیار پنج نتیجه، تخمین پایدارتری از یک تقسیم تنها میدهد.
تفاوت SVM و KNN چیست؟
SVM مرزی پیدا میکند که دستهها را با بیشترین فاصله از هم جدا کند و پس از آموزش فقط به بردارهای پشتیبان نیاز دارد. KNN مدلی نمیسازد و برای هر نمونهی تازه، نزدیکترین نمونههای آموزشی را پیدا میکند و به رأی آنها تکیه میکند؛ پس پیشبینیاش روی دادهی بزرگ کند است.
روشهای Ensemble چیست؟
روشهای Ensemble چند مدل ساده را ترکیب میکنند تا مدل قویتری بسازند. جنگل تصادفی میانگین رأی چندین درخت تصمیم مستقل است. AdaBoost درختها را پشت سر هم میسازد و هر درخت روی نمونههایی تمرکز میکند که درخت قبلی اشتباه کرده است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.