
خوشهبندی K-Means جواب سؤالی است که در بیشتر پروژهها پیش میآید: داده داریم، اما برچسب نداریم. هزاران پرسش کاربر، هزاران مشتری یا هزاران آهنگ. هیچکس برایشان دسته تعریف نکرده است. آیا گروههای طبیعی در این داده هست؟ K-Means سادهترین راه پیدا کردن آنهاست.
در قسمت تحلیل اکتشافی، دادهی آهنگهای نیجریهای را بررسی کردیم و دیدیم ژانرها همپوشانی زیادی دارند. حالا همان داده را با K-Means خوشهبندی میکنیم. در این قسمت سازوکار الگوریتم را میفهمیم، تعداد خوشه را انتخاب میکنیم و کیفیت نتیجه را میسنجیم.
خوشهبندی چیست؟
خوشهبندی نوعی یادگیری بدون نظارت است. برخلاف طبقهبندی، برچسبی در کار نیست. الگوریتم فقط از روی شباهت نمونهها، آنها را گروهبندی میکند. معنای هر گروه را بعداً شما تفسیر میکنید.
خوشهبندی کاربردهای زیادی دارد. تقسیمبندی مشتریان بر اساس رفتار خرید، گروهبندی نتایج جستجو، پیدا کردن الگوی تقلب و کشف موضوعات پرتکرار در پیامهای کاربران از این جملهاند. تحلیل خوشهای در دههی ۱۹۳۰ در انسانشناسی و روانشناسی شروع شد، خیلی پیش از کامپیوترهای امروزی.
خانوادههای الگوریتم خوشهبندی
بیش از صد الگوریتم خوشهبندی وجود دارد که در چند خانواده جا میگیرند:
- مرکزگرا: هر خوشه یک مرکز دارد و نقطهها به نزدیکترین مرکز تعلق میگیرند؛ مثل K-Means.
- سلسلهمراتبی: خوشهها بهتدریج با هم ادغام یا از هم جدا میشوند و درختی از خوشهها میسازند.
- مبتنی بر چگالی: نقطههای متراکم یک خوشهاند و نقطههای پراکنده نویز؛ مثل DBSCAN.
- مبتنی بر توزیع: هر خوشه یک توزیع آماری است؛ مثل مدل مخلوط گاوسی.
K-Means از خانوادهی مرکزگرا و محبوبترین آنهاست. ساده، سریع و برای دادهی بزرگ مناسب است. اما همانطور که میبینیم، فرضهایی دارد که باید بشناسید.
الگوریتم K-Means در چهار قدم
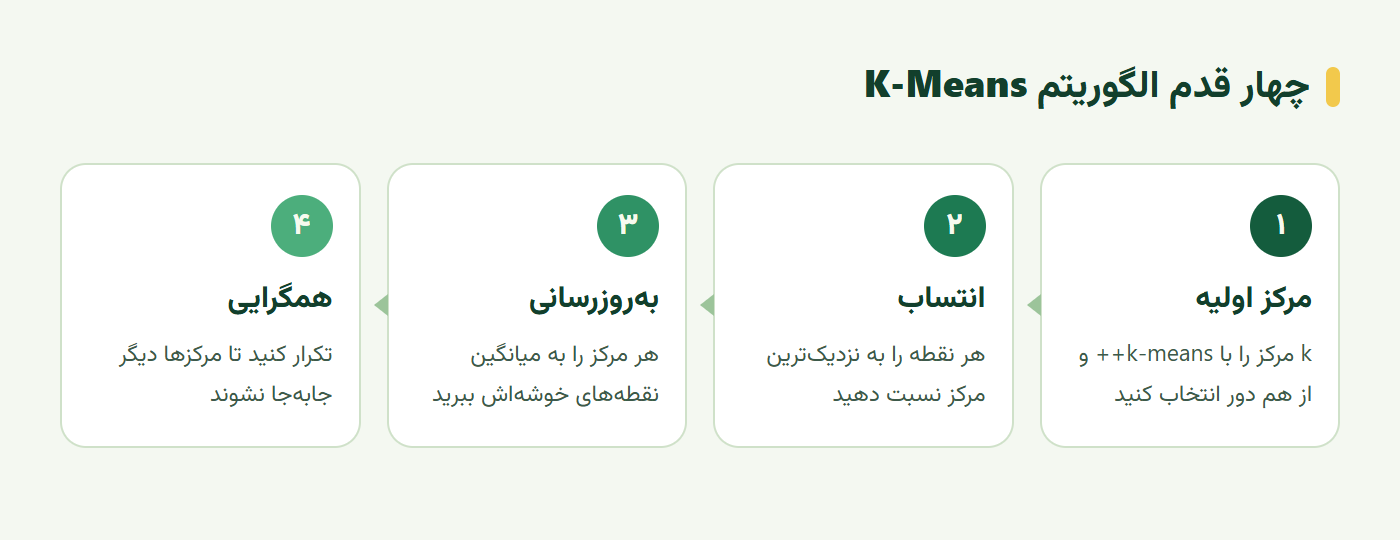
نام K-Means از دو بخش آمده است. k تعداد خوشههاست که شما تعیین میکنید. Means یعنی میانگین، چون مرکز هر خوشه میانگین نقطههای آن است. نمودار زیر چهار قدم الگوریتم را نشان میدهد.
انتساب و بهروزرسانی
الگوریتم با k مرکز اولیه شروع میکند. در قدم انتساب، هر نقطه به نزدیکترین مرکز تعلق میگیرد. در قدم بهروزرسانی، مرکز هر خوشه به میانگین نقطههایی که به آن تعلق گرفتهاند منتقل میشود.
این دو قدم تکرار میشوند تا مراکز دیگر جابهجا نشوند. نتیجه تقسیم فضا به ناحیههایی است که هرکدام به یک مرکز نزدیکترند. به این تقسیم نمودار ورونوی میگویند. الگوریتم تضمین میکند مجموع مربع فاصلهی نقطهها از مرکزشان در هر تکرار کمتر یا مساوی شود.
مرکز اولیه و k-means++
نتیجهی K-Means به مرکزهای اولیه بستگی دارد. با شروع بد، ممکن است در یک راهحل ضعیف گیر کند. روش k-means++ مرکزهای اولیه را هوشمندانهتر انتخاب میکند؛ طوری که از هم دور باشند.
scikit-learn بهطور پیشفرض از k-means++ استفاده میکند. همچنین الگوریتم را چند بار با شروعهای مختلف اجرا میکند و بهترین نتیجه را نگه میدارد. پارامتر n_init تعداد این اجراها را تعیین میکند.
بیشتر بخوانید: بررسی ساختار، مقادیر عجیب و تفاوت مقیاس دادهی آهنگها را پیش از خوشهبندی در تحلیل اکتشافی داده (EDA) ببینید.
آمادهسازی داده برای K-Means
K-Means بر فاصله تکیه دارد. پس هر چیزی که فاصله را منحرف کند، نتیجه را خراب میکند. دو مورد از همه مهمترند؛ مقیاس ویژگیها و دادهی پرت.
مقیاسبندی؛ ضروری، نه اختیاری
در دادهی آهنگها، رقصپذیری بین صفر و یک است و سرعت ضرب حدود صد. بدون مقیاسبندی، فاصله تقریباً فقط با سرعت ضرب تعیین میشود. خوشهها عملاً فقط آهنگهای تند و کند را جدا میکنند.
با StandardScaler همهی ویژگیها میانگین صفر و انحراف معیار یک میگیرند. حالا هر ویژگی سهم منصفانهای در فاصله دارد. این قدم را هرگز فراموش نکنید.
دادهی پرت و انتخاب ویژگی
میانگین به دادهی پرت حساس است. یک آهنگ بسیار طولانی میتواند مرکز یک خوشه را به سمت خودش بکشد. در EDA دیدیم بعضی ستونها دادهی پرت دارند. پیش از خوشهبندی، آنها را بررسی و در صورت لزوم حذف کنید.
انتخاب ویژگی هم مهم است. ویژگیهایی که همبستگی بسیار بالا دارند، یک جنبه از داده را دو بار در فاصله حساب میکنند. ویژگیهای بیربط هم نویز اضافه میکنند. با چند ویژگی معنادار شروع کنید و بهتدریج اضافه کنید.
انتخاب تعداد خوشه؛ روش آرنج و سیلوئت
بزرگترین سؤال K-Means این است که k چند باشد. الگوریتم خودش این را تعیین نمیکند. دو روش رایج برای انتخاب وجود دارد که بهتر است هر دو را با هم به کار ببرید.
روش آرنج
در روش آرنج، K-Means را برای k از ۱ تا ۱۰ اجرا میکنید. برای هر k، مجموع مربع فاصلهی نقطهها از مرکزشان را حساب میکنید. به این عدد اینرسی یا WCSS میگویند. با افزایش k، اینرسی همیشه کم میشود.
اما کاهش از جایی کند میشود. نمودار اینرسی در برابر k شبیه یک بازو است و نقطهی خم آن، آرنج، k مناسب را نشان میدهد. در دادهی آهنگها، آرنج حدود k برابر ۳ دیده میشود. این با سه ژانری که انتخاب کرده بودیم همخوانی دارد.
امتیاز سیلوئت
امتیاز سیلوئت کیفیت خوشهها را از زاویهی دیگری میسنجد. برای هر نقطه، فاصلهی میانگین تا نقطههای خوشهی خودش را با فاصلهی میانگین تا نزدیکترین خوشهی دیگر مقایسه میکند. نتیجه عددی بین منفی یک و یک است.
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score
from sklearn.preprocessing import StandardScaler

features = ["danceability", "energy", "acousticness", "popularity", "tempo"]
X = StandardScaler().fit_transform(df[features])

for k in range(2, 8):
    km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(X)
    print(k, round(km.inertia_, 1), round(silhouette_score(X, km.labels_), 3))
امتیاز نزدیک یک یعنی خوشههای فشرده و جدا. نزدیک صفر یعنی همپوشانی. در دادهی آهنگها، امتیاز سیلوئت متوسط است، حدود نیم. یعنی خوشهها وجود دارند، اما مرزهایشان روشن نیست. این همان چیزی است که EDA هم نشان داده بود.
تفسیر خوشهها و محدودیتها
خوشهبندی کار را تمام نمیکند؛ تازه شروع تفسیر است. الگوریتم فقط میگوید این نقطهها شبیه هماند. اینکه این شباهت چه معنایی دارد، کار شماست.
تفسیر هر خوشه
برای تفسیر، میانگین هر ویژگی را در هر خوشه حساب کنید. مثلاً ممکن است یک خوشه رقصپذیری و انرژی بالا داشته باشد و خوشهی دیگر آکوستیک بیشتر. این پروفایلها را با برچسبهای انسانی مقایسه کنید؛ مثلاً ژانر.
اگر خوشهها با ژانرها تطابق کامل ندارند، شکست نیست. شاید خوشهها چیز دیگری را کشف کردهاند؛ مثلاً آهنگهای مهمانی در برابر آهنگهای آرام، فارغ از ژانر. خوشهبندی گاهی دستهبندیای پیدا میکند که به ذهن هیچکس نرسیده بود.
کی K-Means مناسب نیست؟
K-Means فرض میکند خوشهها تقریباً کروی و هماندازهاند. اگر خوشهها شکل کشیده، حلقوی یا چگالی متفاوت داشته باشند، K-Means آنها را اشتباه تقسیم میکند. در این موارد DBSCAN یا خوشهبندی سلسلهمراتبی بهتر است.
برای دستیار آموزشی، کاربرد رایج K-Means گروهبندی پرسشهای کاربران است. پرسشها ابتدا به بردار عددی تبدیل میشوند و بعد خوشهبندی میشوند. هر خوشه یک موضوع پرتکرار را نشان میدهد که شاید ارزش یک پاسخ آماده یا صفحهی راهنما داشته باشد. روش تبدیل متن به بردار را در قسمتهای پردازش زبان میبینیم.
تمرین عملی؛ خوشهبندی و تفسیر
روی دادهی آهنگها یا دادهی بدون برچسب خودتان این کارها را انجام دهید:
- آمادهسازی: سه تا پنج ویژگی عددی انتخاب و استاندارد کنید.
- روش آرنج: نمودار اینرسی برای k از ۱ تا ۱۰ را رسم کنید.
- سیلوئت: امتیاز سیلوئت را برای k از ۲ تا ۷ حساب کنید.
- انتخاب k: با ترکیب هر دو روش، یک k انتخاب و دلیلش را بنویسید.
- تفسیر: برای هر خوشه یک نام پیشنهادی بر اساس میانگین ویژگیها بنویسید.
در پایان، بدون مقیاسبندی هم یک بار اجرا کنید و تفاوت خوشهها را توضیح دهید. این آزمایش اهمیت مقیاسبندی را بهتر از هر توضیحی نشان میدهد.
سخن پایانی
خوشهبندی K-Means دادهی بدون برچسب را به k گروه تقسیم میکند. با انتساب هر نقطه به نزدیکترین مرکز و بهروزرسانی مرکزها، گروهها بهتدریج پایدار میشوند. مقیاسبندی ضروری است و k را با روش آرنج و امتیاز سیلوئت انتخاب میکنیم.
خروجی K-Means یک پیشنهاد است، نه یک حقیقت. تفسیر خوشهها کار انسان است و گاهی به کشفهای تازه میرسد. محدودیتهایش را هم بشناسید. برای خوشههای نامنظم، سراغ روشهای دیگر بروید.
این آموزش بر پایهی درسهای K-Means clustering و Introduction to clustering از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
خوشهبندی K-Means چیست؟
K-Means الگوریتمی برای یادگیری بدون نظارت است که دادهی بدون برچسب را به k گروه تقسیم میکند. هر خوشه یک مرکز دارد و هر نقطه به نزدیکترین مرکز تعلق میگیرد. مراکز آنقدر جابهجا میشوند تا گروهها پایدار شوند.
تعداد خوشهها را در K-Means چطور انتخاب کنیم؟
دو روش رایج وجود دارد. در روش آرنج، مجموع مربع فاصلهی نقطهها از مرکزشان را برای kهای مختلف رسم میکنید و نقطهای را برمیگزینید که کاهش ناگهان کند میشود. در روش سیلوئت، kای را انتخاب میکنید که میانگین امتیاز سیلوئت بیشتری دارد.
امتیاز سیلوئت چه چیزی را نشان میدهد؟
امتیاز سیلوئت برای هر نقطه میسنجد که چقدر به خوشهی خودش نزدیک و از نزدیکترین خوشهی دیگر دور است. عددی بین منفی یک و یک است. نزدیک یک یعنی خوشههای فشرده و جدا، نزدیک صفر یعنی همپوشانی و منفی یعنی نقطه احتمالاً در خوشهی اشتباه است.
محدودیتهای K-Means چیست؟
K-Means فرض میکند خوشهها تقریباً کروی و هماندازهاند، به دادهی پرت و مقیاس ویژگیها حساس است و تعداد خوشه را باید از قبل تعیین کنید. برای خوشههای نامنظم یا با چگالی متفاوت، روشهایی مثل DBSCAN مناسبترند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.