
پایش ایجنت هوش مصنوعی از لحظهای مهم میشود که کاربر واقعی از راه میرسد. وقتی کاربری میگوید پاسخ بد بود، ذخیرهی متن نهایی برای پیدا کردن علت کافی نیست. باید بدانیم چه اسنادی بازیابی شد، کدام ابزار اجرا شد و زمان در کدام مرحله مصرف شد.
در قسمت نوزدهم با مفاهیم مشاهدهپذیری، Trace و Span و معیارهای ارزیابی آشنا شدیم. در این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز، سراغ کار عملی در محیط تولید میرویم. کد ایجنت را ابزارگذاری میکنیم، مشکلات رایج و راهحلهایشان را مرور میکنیم، هزینه را کنترل میکنیم و یک مسئلهی واقعی را حل میکنیم: کندیای که فقط برای بخشی از کاربران رخ میدهد.
چرا پایش در محیط تولید متفاوت است؟
در محیط توسعه، شما ورودیها را میشناسید و میتوانید هر اجرا را قدمبهقدم ببینید. در محیط تولید، هزاران کاربر با ورودیهای پیشبینینشده میآیند. نمیتوانید هر اجرا را دستی بررسی کنید؛ باید سیستم خودش اطلاعات لازم را ثبت کند.
از جعبهی سیاه تا مسیر روشن
بدون پایش، ایجنت یک جعبهی سیاه است. کاربر شکایت میکند و شما فقط میتوانید حدس بزنید. با پایش، هر درخواست یک مسیر روشن دارد: کدام مرحلهها اجرا شدند، هر کدام چقدر طول کشید، چه هزینهای داشت و کجا خطا رخ داد.
مرور کوتاه مفاهیم هم مفید است. Trace کل کار ایجنت برای یک درخواست است. Span هر مرحلهی جداگانه درون آن است؛ مثل فراخوانی مدل، بازیابی سند یا اجرای ابزار. معیارهایی مثل زمان پاسخ، هزینه، نرخ خطا و بازخورد کاربر هم سلامت کلی سیستم را نشان میدهند.
ابزارگذاری ایجنت با OpenTelemetry
برای جمعآوری دادهی پایش، باید کد ایجنت را ابزارگذاری کنید. OpenTelemetry استاندارد صنعتی این کار است؛ مجموعهای از API و SDK برای تولید، جمعآوری و ارسال دادهی پایش. بیشتر ابزارهای مشاهدهپذیری، مثل Langfuse، دادهی OpenTelemetry را دریافت میکنند.
ابزارگذاری خودکار
بسیاری از فریمورکهای ایجنت ابزارگذاری آماده دارند. Microsoft Agent Framework متدهایی برای گرفتن ردیاب و معیارسنج دارد و اجرای ایجنت را خودکار ثبت میکند. در قسمت CodeAgent هم دیدیم smolagents با یک خط به OpenTelemetry وصل میشود.
ابزارگذاری خودکار نقطهی شروع خوبی است. فراخوانیهای مدل و ابزار را بدون تغییر کد ثبت میکند. اما معمولاً اطلاعات خاص کسبوکار شما، مثل شناسهی دوره یا نوع درخواست، را ندارد.
Span دستی برای مراحل مهم
برای اطلاعات دقیقتر، Span دستی بسازید. کد زیر با API استاندارد OpenTelemetry برای هر مرحلهی ایجنت یک Span میسازد و ویژگیهای مفید را به آن اضافه میکند:
from opentelemetry import trace

tracer = trace.get_tracer("course-assistant")

def handle(request_id: str, question: str, user_tier: str):
    with tracer.start_as_current_span("request") as root:
        root.set_attribute("request.id", request_id)
        root.set_attribute("user.tier", user_tier)       # نه نام یا ایمیل کاربر
        with tracer.start_as_current_span("retrieve") as span:
            docs = retrieve(question)
            span.set_attribute("retrieve.count", len(docs))
        with tracer.start_as_current_span("generate") as span:
            answer, usage = generate(question, docs)
            span.set_attribute("llm.tokens.total", usage.total_tokens)
        return answer
هر Span زمان شروع و پایان خودش را خودکار ثبت میکند. ویژگیهایی که اضافه کردهایم، مثل تعداد سندهای بازیابیشده و تعداد توکن، بعداً برای جستجو و تحلیل به کار میآیند.
حریم خصوصی در لاگ
به یک نکته در کد دقت کنید: سطح اشتراک کاربر ثبت شده، نه نام یا ایمیلش. پایش نباید به منبع نشت اطلاعات شخصی تبدیل شود. پیش از ثبت، اطلاعات شخصی را حذف یا ناشناس کنید.
برای پیدا کردن علت کندی یا خطا، معمولاً زمان هر مرحله، نام ابزار و وضعیت خطا کافی است. متن کامل پیام کاربر را فقط وقتی ثبت کنید که واقعاً لازم است، با رضایت کاربر و با سیاست نگهداری مشخص.
مشکلات رایج ایجنت در محیط تولید
هنگام استقرار ایجنت با چند مشکل تکراری روبهرو میشوید. بیشتر این مشکلات با پایش خوب زودتر پیدا میشوند؛ Trace و معیارها دقیقاً نشان میدهند مشکل کجاست.
چهار مشکل پرتکرار
جدول زیر چهار مشکل رایج و راهحلهای پیشنهادی درسنامهی مایکروسافت را نشان میدهد.
| مشکل | نشانه در پایش | راهحل پیشنهادی |
|---|---|---|
| ایجنت کار را درست انجام نمیدهد | نرخ موفقیت پایین در ارزیابی | دستور را روشنتر کنید؛ کار را به زیرکارها تقسیم کنید |
| ایجنت در حلقه گیر میکند | تعداد Spanهای یک Trace غیرعادی زیاد | شرط پایان روشن و سقف قدم بگذارید |
| فراخوانی ابزار ضعیف است | خطا یا نتیجهی خالی در Span ابزار | ابزار را خارج از ایجنت آزمایش کنید؛ توضیح و پارامترها را اصلاح کنید |
| سیستم چندایجنتی ناپایدار است | ایجنتها کار تکراری انجام میدهند | پرامپت هر ایجنت را متمایز کنید؛ یک مسیریاب اضافه کنید |
مدل قویتر آخرین راهحل است
برای مشکل اول، یک وسوسهی رایج وجود دارد: مدل قویتر. گاهی این کار لازم است، بهخصوص برای کارهای استدلالی پیچیده. اما پیش از آن، دستور را روشنتر کنید و کار را به زیرکارهای کوچکتر بشکنید. مدل قویتر هزینهی هر درخواست را در کل عمر محصول بالا میبرد.
پایش کمک میکند این تصمیم را با داده بگیرید. اگر Traceها نشان دهند ایجنت ابزار درست را انتخاب میکند اما در ترکیب نتیجهها خطا دارد، مشکل در مرحلهی تولید پاسخ است. اگر ابزار اشتباه انتخاب میشود، مشکل در توضیح ابزار است، نه در قدرت مدل.
کنترل هزینه در محیط تولید
هزینهی ایجنت در محیط تولید میتواند بهسرعت بالا برود. سه راهبرد اصلی برای کنترل آن وجود دارد.
مدل کوچک، مسیریاب و کش
اول، مدل کوچکتر. در قسمت مدلهای زبانی کوچک دیدیم که برای کارهای محدود، مدل کوچک کافی است. پایش نشان میدهد کدام کارها واقعاً به مدل بزرگ نیاز دارند و کدام نه.
دوم، مسیریاب. بهجای فرستادن همهی درخواستها به یک مدل، یک مسیریاب ساده بر اساس پیچیدگی درخواست تصمیم میگیرد به کدام مدل برود. درخواست ساده به مدل کوچک و درخواست پیچیده به مدل بزرگ. سوم، کش. درخواستهای پرتکرار، مثل «ساعت کلاسها چیست؟»، را شناسایی کنید و پاسخشان را پیش از رسیدن به ایجنت از کش برگردانید.
هزینه را در Span ثبت کنید
برای کنترل هزینه، اول باید آن را ببینید. تعداد توکنهای هر فراخوانی مدل را در Span ثبت کنید. بعد میتوانید هزینه را بر اساس نوع درخواست، ایجنت یا کاربر تفکیک کنید.
یک هشدار ساده هم بگذارید. اگر هزینهی روزانه ناگهان چند برابر شد، احتمالاً یک باگ ایجنت را در حلقه انداخته است. پیدا کردن این باگ در همان روز، بسیار ارزانتر از دیدنش در صورتحساب ماه بعد است.
سناریوی عملی؛ کندی برای بخشی از کاربران
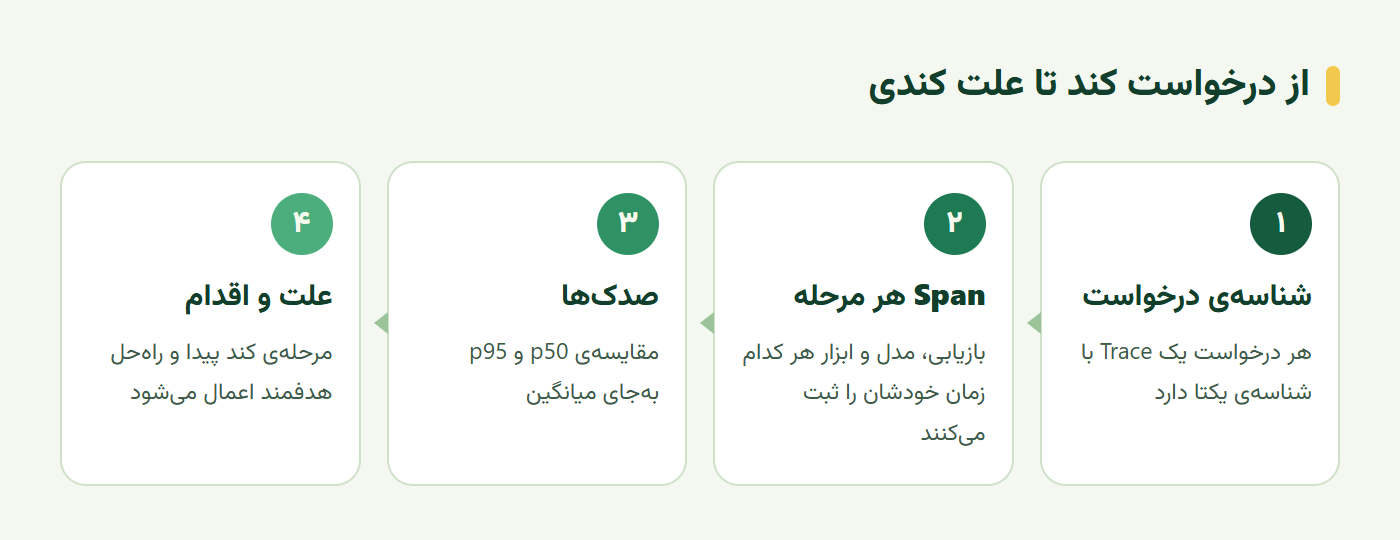
بخشی از کاربران پاسخ را دیر دریافت میکنند، اما کندی برای همه نیست. میانگین زمان پاسخ هم قابلقبول به نظر میرسد. این دقیقاً موقعیتی است که بدون پایش درست، علتش پیدا نمیشود. نمودار زیر مسیر رسیدن از درخواست کند به علت کندی را نشان میدهد.
صدکها بهجای میانگین
قدم اول، کنار گذاشتن میانگین است. اگر ۹۵ درصد درخواستها در سه ثانیه و ۵ درصد در سی ثانیه جواب بگیرند، میانگین حدود چهار و نیم ثانیه است؛ عددی که مشکل را پنهان میکند. صدک ۹۵ (p95) نشان میدهد پنج درصد کاربران دستکم سی ثانیه منتظر ماندهاند.
قدم دوم، مقایسهی Spanهای درخواستهای کند و عادی است. اگر Span بازیابی در درخواستهای کند ده برابر طولانیتر است، مشکل در جستجوست. شاید پرسشهای طولانیتر پرسوجوی سنگینتری میسازند. اگر Span مدل طولانیتر است، شاید این درخواستها سند بیشتری به مدل میدهند.
ورودی و معیار پذیرش
ورودی آزمون سه بخش دارد: شناسهی درخواست، زمان هر مرحله و وضعیت فراخوانی ابزارها. اقدام مورد بررسی، اتصال رویدادها به یک مسیر اجرا و مقایسهی درخواستهای کند و عادی است.
معیار پذیرش دو بخش دارد: بتوان مرحلهی کند را مشخص کرد و در این کار اطلاعات شخصی بیدلیل ثبت نشود. شکستی که باید از آن پرهیز کنید، اندازهگیری فقط زمان نهایی است. سیستمی که فقط زمان کل را ثبت کند، میگوید «کند است»، اما نمیگوید «کجا».
تمرین عملی؛ طرح پایش دستیار
خروجی این تمرین طرح پایشی شامل معیارها، رویدادها و روش رسیدگی به خطاست:
- کد دستیار را با Spanهای دستی برای بازیابی، تولید پاسخ و هر ابزار ابزارگذاری کنید.
- تعداد توکن، تعداد سند و وضعیت خطا را بهعنوان ویژگی Span ثبت کنید؛ بدون اطلاعات شخصی.
- یک کندی عمدی در مرحلهی بازیابی برای بخشی از درخواستها ایجاد کنید و بررسی کنید آیا با p95 و مقایسهی Spanها پیدا میشود.
مشخص کنید کدام بخش را واقعاً اجرا کردهاید و کدام هنوز فرض است.
سخن پایانی
پایش ایجنت هوش مصنوعی در محیط تولید یعنی هر درخواست یک مسیر روشن داشته باشد. OpenTelemetry استاندارد این کار است؛ ابزارگذاری خودکار فریمورکها شروع خوبی است و Span دستی جزئیات خاص کسبوکار را اضافه میکند. با این دادهها، مشکلات رایج زودتر پیدا میشوند، هزینه با مدل کوچک، مسیریاب و کش کنترل میشود و کندی بخشی از کاربران با صدکها و مقایسهی Spanها آشکار میشود. فقط فراموش نکنید پایش نباید به نشت اطلاعات شخصی تبدیل شود.
در قسمت بعد سراغ پروتکلهای MCP و A2A میرویم و میبینیم چه مسئلهای را حل میکنند.
این آموزش بر پایهی درس AI Agents in Production از مجموعهی آزاد AI Agents for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
ابزارگذاری ایجنت یعنی چه؟
یعنی کد ایجنت را طوری تغییر دهید که هنگام اجرا، اطلاعات هر مرحله مثل زمان، ورودی، خروجی و خطا را بهصورت Trace و Span ثبت کند. OpenTelemetry استاندارد رایج این کار است و بسیاری از فریمورکها آن را آماده دارند.
چرا میانگین زمان پاسخ برای پایش کافی نیست؟
چون میانگین کندی بخشی از کاربران را پنهان میکند. اگر ۹۵ درصد درخواستها سریع و ۵ درصد بسیار کند باشند، میانگین هنوز قابلقبول به نظر میرسد. صدکهایی مثل p95 نشان میدهند بدترین تجربهی کاربران چقدر بد است.
چطور هزینهی ایجنت را در محیط تولید کم کنیم؟
سه راه اصلی؛ استفاده از مدل کوچکتر برای کارهای ساده، مسیریابی درخواستها به مدل مناسب بر اساس پیچیدگی، و کش کردن پاسخ درخواستهای پرتکرار پیش از رسیدن به ایجنت.
آیا باید همهی ورودیها و خروجیها را در لاگ ذخیره کرد؟
نه. اطلاعات شخصی مثل نام، ایمیل و شمارهی تلفن را پیش از ثبت حذف یا ناشناس کنید. برای پیدا کردن علت کندی معمولاً زمان هر مرحله، نام ابزار و وضعیت خطا کافی است، نه متن کامل پیام کاربر.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.