
نمونهای که برای یک کاربر کار میکند، ممکن است با چند درخواست همزمان دچار مشکل شود. وضعیت کاربران نباید با هم مخلوط شود، هزینه نباید از کنترل خارج شود و خطای یک سرویس نباید کل ایجنت را از کار بیندازد. استقرار ایجنت هوش مصنوعی دربارهی پر کردن همین فاصله است؛ فاصلهی میان «روی سیستم من کار میکند» و «برای هزاران کاربر مطمئن کار میکند».
در این قسمت از مجموعهی آموزش هوش مصنوعی تخته سبز میبینیم دقیقاً چه چیزهایی تغییر میکند. سه الگوی استقرار، چرخهی عمر ایجنت و راهبردهای مقیاسپذیری را مرور میکنیم. در پایان، ایجنت را برای ساعت شلوغ پایان مهلت تکلیف آماده میکنیم.
از نمونه اولیه تا محیط واقعی چه تغییر میکند؟
ایجنت نمونه اولیه و ایجنت عملیاتی حلقهی اصلی یکسانی دارند؛ استدلال، فراخوانی ابزار، پاسخ. تفاوت در همهچیزِ اطراف مدل است. جدول زیر این تفاوتها را نشان میدهد و هر بخش بعدی به یکی از ردیفهایش میپردازد.
| موضوع | نمونه اولیه | محیط واقعی |
|---|---|---|
| میزبانی | در نوتبوک شما | سرویس نسخهدار و منتشرشده |
| هویت | توکن شخصی شما | هویت مدیریتشده با دسترسی محدود |
| وضعیت | در حافظه؛ با راهاندازی دوباره میرود | در ذخیرهگاه بیرونی |
| خطا | خودتان خطا را میبینید | تلاش دوباره، مسیر جایگزین، هشدار |
| هزینه | «چند سنت است» | ثبت هر درخواست، مسیریابی، بودجه |
| کیفیت | بررسی چشمی | ارزیابی خودکار پیش از هر انتشار |
| اعتماد | خودتان تأیید میکنید | سیاست و تأیید انسانی برای اقدام پرخطر |
سه الگوی استقرار
الگوی اول، ایجنت میزبانیشده در برنامه است. ایجنت داخل فرایند برنامهی شما زندگی میکند و مستقیم مدل را صدا میزند. کنترل کامل دارید و میتوانید ایجنت را در بکاند موجود جاسازی کنید؛ اما مقیاس، وضعیت و تابآوری را خودتان باید مدیریت کنید.
الگوی دوم، ایجنت میزبانیشده در سرویسی مثل Microsoft Foundry Agent Service است. ایجنت بهصورت یک منبع ثبت میشود و سرویس حلقهی استدلال، ذخیرهی گفتوگوها و ابزارها را مدیریت میکند. دوام، مشاهدهپذیری و حاکمیت داخلی دارید و در ازایش کنترل سطح پایین را از دست میدهید.
الگوی سوم، جریان کار ایجنتی است؛ چند ایجنت و ابزار در یک گراف با کنترل صریح، انشعاب، گرههای تأیید انسانی و نقاط ذخیره. وقتی یک کار چند ایجنت تخصصی یا تأیید میانی لازم دارد، این الگو مناسب است. این سه الگو اغلب با هم ترکیب میشوند.
چرخهی عمر ایجنت و دروازهی ارزیابی
استقرار ایجنت یک کار یکباره نیست؛ یک حلقه است. ساخت، نسخهگذاری، ارزیابی آفلاین، استقرار، مشاهدهی آنلاین، جمعآوری خطاها و دوباره ساخت. نسخههای قدیمی هم در زمان مناسب بازنشسته میشوند.
ارزیابی بهعنوان دروازهی انتشار
ایدهی کلیدی این است که ارزیابی آفلاین نقش دروازه را دارد. پیش از انتشار هر نسخهی تازه، یک مجموعه آزمون اجرا میشود. اگر امتیاز از حد تعیینشده کمتر باشد، نسخه منتشر نمیشود و به مرحلهی ساخت برمیگردد.
این همان کاری است که آزمونهای خودکار در انتشار نرمافزار میکنند. تفاوت اینجاست که تغییر دستور مدل یا نسخهی مدل هم باید از این دروازه بگذرد؛ نه فقط تغییر کد.
حلقهی بهبود
خطاهایی که در مشاهدهی آنلاین پیدا میشوند، به مجموعهی آزمون اضافه میشوند. به این ترتیب هر خطای واقعی یک بار رخ میدهد و بعد برای همیشه آزمون میشود. مجموعهی ارزیابی بهمرور به نقشهی دقیقی از رفتارهای مهم ایجنت تبدیل میشود.
راهبردهای مقیاسپذیری
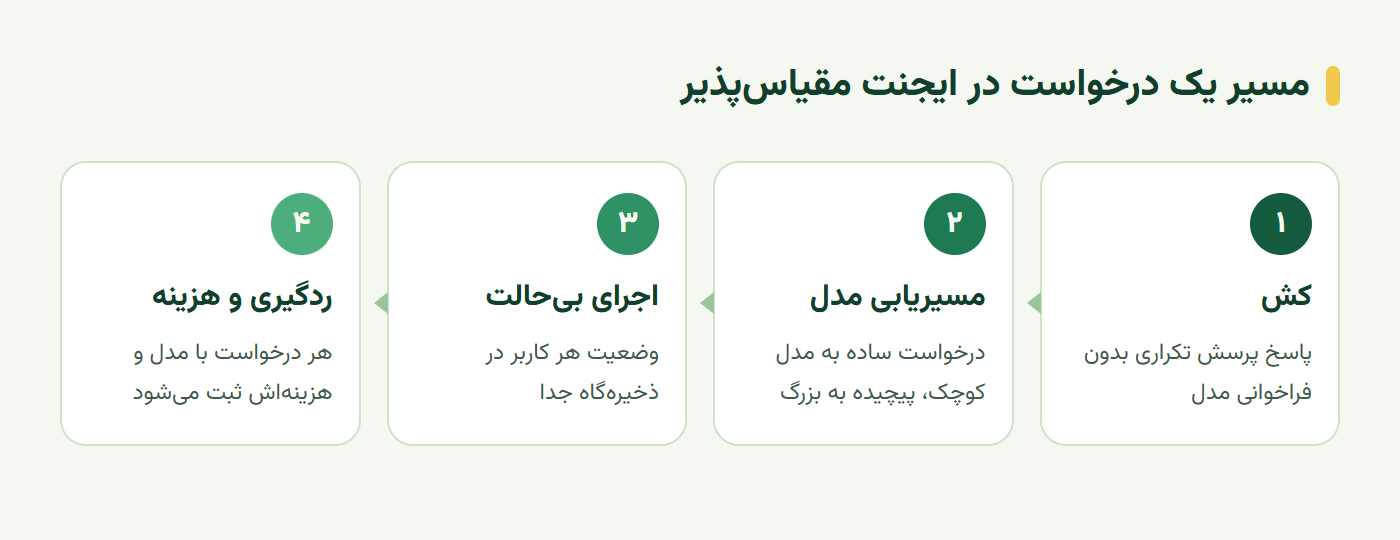
مقیاس دادن ایجنت با مقیاس دادن یک API معمولی فرق دارد. هر درخواست ممکن است چند فراخوانی مدل، چند ابزار و چند ثانیه زمان بگیرد. نمودار زیر مسیر یک درخواست در ایجنت مقیاسپذیر را نشان میدهد.
طراحی بیحالت و کنترل همزمانی
هیچ وضعیتی از کاربر را در حافظهی فرایند نگه ندارید. گفتوگوها را در ذخیرهگاه جلسه و حافظهی بلندمدت را در سرویس حافظه نگه دارید. آنوقت هر نمونهی ایجنت میتواند هر درخواستی را پاسخ دهد و مقیاس افقی ساده میشود.
ارائهدهندههای مدل محدودیت نرخ دارند. همزمانی را محدود کنید، تلاش دوباره را با فاصلهی رو به افزایش انجام دهید و کارهای طولانی را در صف بگذارید؛ نه اینکه اتصال کاربر را باز نگه دارید.
مسیریابی مدل و کش
هر درخواستی به مدل توانمند و گران نیاز ندارد. دستهبندی نیت، پرسشهای ساده و استخراج را میتوان به مدل کوچک فرستاد. یک دستهبند سبک پیچیدگی را میسنجد و فقط درخواستهای سخت به مدل بزرگ میروند.
بسیاری از پرسشها تقریباً تکراریاند؛ مثل «مهلت تحویل تکلیف کی است؟». پاسخ اینها را بر اساس متن نرمالشدهی پرسش کش کنید. ارزانترین فراخوانی مدل، فراخوانیای است که هرگز انجام نمیشود:
async def handle_request(query: str, user_id: str) -> str:
    if cached := cache.get(normalize(query)):
        return cached
    model = "small-model" if is_simple(query) else "large-model"
    with tracer.start_as_current_span("request") as span:
        span.set_attribute("routed.model", model)
        session = await sessions.load(user_id)   # وضعیت هر کاربر جدا
        answer = await agent.run(query, session=session, model=model)
    cache.set(normalize(query), answer)
    return answer
فقط پاسخهای عمومی را کش کنید. پاسخی که به اطلاعات شخصی یک کاربر وابسته است، نباید برای کاربر دیگری از کش برگردد.
مشاهدهپذیری، هزینه و ملاحظات سازمانی
چیزی را که نمیبینید، نمیتوانید اداره کنید. با ردگیری OpenTelemetry هر درخواست را از ابتدا تا انتها، در هر فراخوانی مدل و ابزار دنبال کنید. تأخیر p50 و p95 و هزینهی هر درخواست را در طول زمان ببینید.
ویژگیهایی که ردگیری را معنادار میکنند
ویژگیهایی مثل سطح مشتری یا مدل انتخابشده، انبوه ردگیریها را به پرسشهای قابل پاسخ تبدیل میکنند. مثلاً «چند درصد درخواستها به مدل بزرگ رفتند؟» یا «کدام دسته از کاربران بیشترین هزینه را دارند؟». بدون این ویژگیها فقط دیواری از داده دارید.
در هزینه، سه اهرم به ترتیب اثر وجود دارد: انتخاب کوچکترین مدلی که از دروازهی ارزیابی میگذرد، مسیریابی بر اساس پیچیدگی و کش. ارزیابی کف کیفیت را تعیین میکند و مسیریابی و کش سقف هزینه را.
حاکمیت، تأیید انسانی و MCP
به هر ایجنت یک هویت مدیریتشده با کمترین دسترسی لازم بدهید. برخی عملیات مثل بازپرداخت یا حذف حساب برای خودکارسازی کامل بیش از حد مهماند؛ اینها باید منتظر تأیید انسانی بمانند.
سرورهای MCP در محیط واقعی هم باید با احتیاط وصل شوند. فقط سرورهای مورد اعتماد، با اعتبارنامهی محدود و فهرست مشخص ابزارهای مجاز. هر ابزار تازه یعنی سطح حملهی تازه.
سناریوی عملی؛ ساعت پایانی مهلت تکلیف
در ساعت آخر مهلت یک تکلیف، دهها دانشجو همزمان از دستیار آموزشی سؤال میپرسند. ورودی آزمون، درخواستهای مستقل با شناسهی کاربر و محدودیت منابع است. یک بار عادی و یک بار سنگین که از ظرفیت بیشتر است، آماده کنید.
معیار پذیرش و نمونهی شکست
اقدام مورد بررسی، جداسازی وضعیت، کنترل همزمانی و رسیدگی منظم به درخواستهاست. معیار پذیرش دو بخش دارد: هیچ زمینهای میان کاربران نشت نکند و رفتار ایجنت در بار زیاد قابل پیشبینی باشد؛ یعنی درخواست اضافه در صف بماند یا پیام روشن بگیرد.
شکستی که باید عمداً دنبالش بگردید، استفادهی مشترک از تاریخچهی گفتوگو یا گم شدن درخواست در بار زیاد است. دو کاربر با سؤالهای متفاوت را همزمان بفرستید و بررسی کنید پاسخ هیچکدام به سؤال دیگری اشاره نکند. بعد بار را بالا ببرید و مطمئن شوید هیچ درخواستی بیصدا گم نمیشود.
تمرین عملی؛ طرح استقرار
خروجی این تمرین یک طرح استقرار با سیاست صف، محدودیت و بازیابی است:
- الگوی استقرار ایجنت خود را انتخاب کنید و دلیلش را بنویسید.
- سقف همزمانی، سیاست صف و رفتار تلاش دوباره را مشخص کنید.
- قاعدهی مسیریابی مدل و فهرست پرسشهای قابل کش را بنویسید و هزینهی ده درخواست ترکیبی را بسنجید.
مشخص کنید کدام بخش را واقعاً اجرا کردهاید و کدام هنوز فرض است.
سخن پایانی
استقرار ایجنت هوش مصنوعی بیشتر از خود مدل، دربارهی ساختار عملیاتی اطراف آن است؛ میزبانی، هویت، وضعیت، خطا، هزینه، کیفیت و اعتماد. سه الگوی استقرار را دیدیم که اغلب ترکیب میشوند. چرخهی عمر ایجنت با دروازهی ارزیابی از انتشار نسخهی ضعیف جلوگیری میکند. و طراحی بیحالت، مسیریابی مدل، کش و کنترل همزمانی ایجنت را برای بار واقعی آماده میکنند.
در قسمت بعد مسیر برعکس را میرویم؛ ایجنتی که کاملاً روی رایانهی خودتان اجرا میشود.
این آموزش بر پایهی درس Deploying Scalable Agents از مجموعهی آزاد AI Agents for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
فرق ایجنت نمونه اولیه و ایجنت مستقرشده چیست؟
حلقهی اصلی هر دو یکی است؛ استدلال، فراخوانی ابزار و پاسخ. تفاوت در همهچیزِ اطراف مدل است؛ میزبانی، هویت، نگهداری وضعیت، مدیریت خطا، کنترل هزینه، ارزیابی خودکار کیفیت و تأیید انسانی برای اقدامهای پرخطر.
چرا ایجنت باید بیحالت طراحی شود؟
اگر وضعیت کاربر در حافظهی فرایند بماند، با راهاندازی دوباره از دست میرود و درخواستهای همزمان ممکن است زمینهی هم را ببینند. نگهداری گفتوگو در ذخیرهگاه بیرونی با کلید کاربر، مقیاس افقی را ممکن و نشت زمینه را ناممکن میکند.
مسیریابی مدل چطور هزینه را کم میکند؟
بسیاری از درخواستها مثل دستهبندی نیت یا پرسش ساده به مدل بزرگ نیاز ندارند. یک دستهبند سبک پیچیدگی درخواست را میسنجد و سادهها را به مدل کوچک و ارزان و فقط پیچیدهها را به مدل بزرگ میفرستد.
دروازهی ارزیابی چیست؟
مجموعهای از آزمونهای آفلاین که پیش از هر انتشار نسخهی تازهی ایجنت اجرا میشود. اگر امتیاز از حد تعیینشده کمتر باشد، نسخه منتشر نمیشود؛ درست مثل آزمونهای خودکار در انتشار نرمافزار.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.