
رگرسیون بردار پشتیبان مدلی است که برای سری زمانی ساخته نشده، اما میتواند در آن بسیار خوب عمل کند. ترفندش یک تغییر نگاه است. به جای اینکه سری را یک دنبالهی پیوسته ببینیم، آن را به مجموعهای از نمونههای کوچک تبدیل میکنیم. هر نمونه چند ساعت گذشته است و هدفش ساعت بعد. حالا یک مسئلهی رگرسیون معمولی داریم.
در قسمت قبل ARIMA را روی دادهی مصرف برق ساختیم؛ مدلی خطی که گذشته را صریح مدل میکند. حالا همان داده را با رویکردی متفاوت پیشبینی میکنیم. در این قسمت با SVR آشنا میشویم، پنجرهسازی را یاد میگیریم و در پایان سه مدل را منصفانه با هم مقایسه میکنیم.
رگرسیون بردار پشتیبان چیست؟
ماشین بردار پشتیبان را در قسمت الگوریتمهای طبقهبندی دیدیم. SVM مرزی پیدا میکرد که دستهها را با بیشترین فاصله از هم جدا کند. SVR همین ایده را برای پیشبینی عدد به کار میبرد.
لولهی اپسیلون
SVR تابعی پیدا میکند که بیشتر نقطهها درون یک لوله به پهنای اپسیلون دور آن قرار بگیرند. خطای نقطههای داخل لوله اصلاً حساب نمیشود. فقط نقطههایی که بیرون لولهاند جریمه میشوند و همینها بردار پشتیبان نام دارند.
این تفاوت مهمی با رگرسیون خطی است. رگرسیون خطی همهی خطاها را به توان دو میرساند و جمع میکند. SVR خطاهای کوچک را نادیده میگیرد و روی خطاهای بزرگ تمرکز میکند. در نتیجه به نویز کوچک داده حساسیت کمتری دارد.
کرنل؛ رابطهی غیرخطی
قدرت اصلی SVR در کرنل است. کرنل داده را به فضایی با بعد بالاتر میبرد که در آن رابطهی غیرخطی، خطی به نظر میرسد. رایجترین کرنل RBF است که شباهت دو نمونه را بر اساس فاصلهشان میسنجد.
برای مصرف برق، رابطهی ساعتهای گذشته و ساعت بعد لزوماً خطی نیست. مثلاً وقتی مصرف در حال اوج گرفتن است، رفتارش با وقتی که در حال کاهش است فرق دارد. کرنل RBF این تفاوتها را بدون تعریف صریح یاد میگیرد.
پنجرهسازی؛ تبدیل سری زمانی به رگرسیون
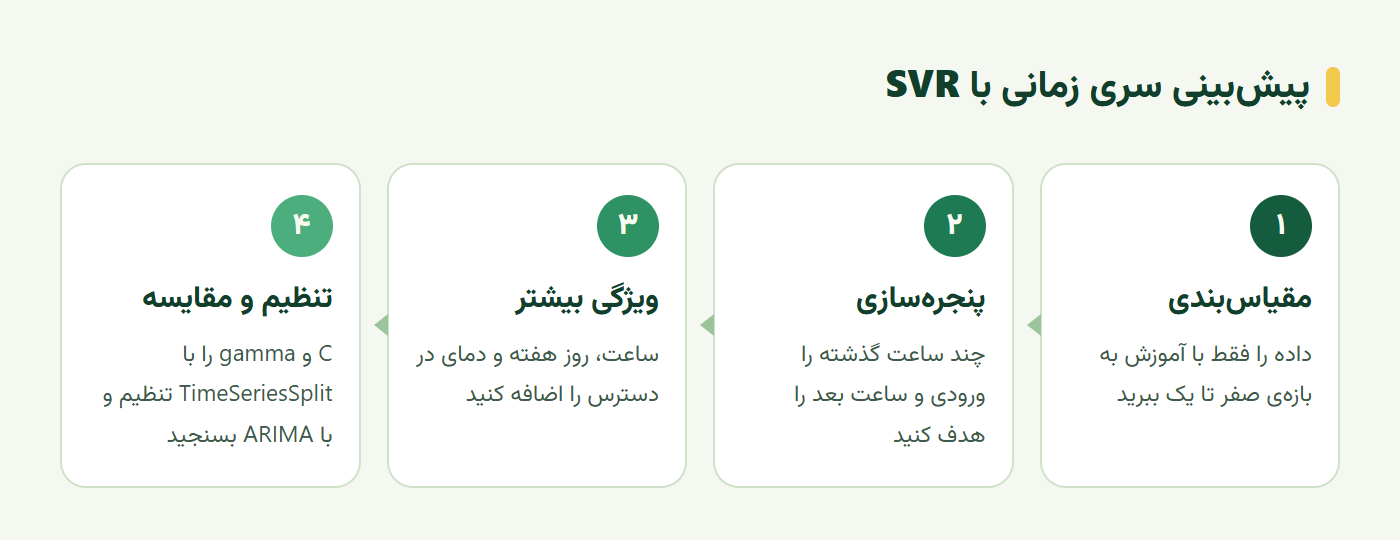
SVR ورودی را به شکل جدول ویژگیها میخواهد، نه یک دنباله. پنجرهسازی این تبدیل را انجام میدهد. نمودار زیر چهار قدم آمادهسازی و ساخت مدل را نشان میدهد.
پنجرهی لغزان
فرض کنید طول پنجره پنج است. نمونهی اول ساعتهای ۱ تا ۴ را بهعنوان ورودی و ساعت ۵ را بهعنوان هدف دارد. نمونهی دوم ساعتهای ۲ تا ۵ و هدف ساعت ۶. پنجره هر بار یک ساعت جلو میرود.
کد زیر این تبدیل را با NumPy انجام میدهد. تابع sliding_window_view بدون کپی اضافه پنجرهها را میسازد:
import numpy as np
from numpy.lib.stride_tricks import sliding_window_view

def make_windows(series, timesteps=5):
    w = sliding_window_view(series, timesteps)
    return w[:, :-1], w[:, -1]          # ورودی: چهار ساعت، هدف: ساعت پنجم

X_train, y_train = make_windows(train_scaled, timesteps=5)
X_test, y_test = make_windows(test_scaled, timesteps=5)
print(X_train.shape, y_train.shape)
انتخاب طول پنجره
طول پنجره یک تصمیم مهم است. پنجرهی کوتاه فقط الگوی چند ساعت اخیر را میبیند. پنجرهی ۲۵ ساعته همان ساعت دیروز را هم پوشش میدهد و فصلی بودن روزانه را میگیرد.
پنجرهی خیلی بلند هم مشکل دارد. تعداد ویژگیها زیاد میشود و مدل کندتر و مستعد بیشبرازش میشود. چند طول مختلف را روی دادهی اعتبارسنجی امتحان کنید. به جای پنجرهی خیلی بلند، میشود فقط تأخیرهای مهم مثل ۱، ۲، ۲۴ و ۱۶۸ ساعت را انتخاب کرد.
بیشتر بخوانید: خط پایهی فصلی، اعتبارسنجی گامبهگام و بررسی باقیمانده را در پیشبینی با مدل ARIMA ببینید تا مقایسهی امروز معنادار باشد.
ساخت و تنظیم مدل SVR
داده همان دو ماه نوامبر و دسامبر ۲۰۱۴ است که برای ARIMA استفاده کردیم. مقیاسبندی به بازهی صفر تا یک هم مثل قبل، فقط روی آموزش fit میشود. SVR به مقیاس بسیار حساس است و بدون آن نتیجهی بیمعنا میدهد.
آموزش مدل
ساخت مدل در scikit-learn چند خط بیشتر نیست. سه پارامتر اصلی C، gamma و epsilon را تعیین میکنیم:
from sklearn.svm import SVR

model = SVR(kernel="rbf", gamma=0.5, C=10, epsilon=0.05).fit(X_train, y_train)
pred = scaler.inverse_transform(model.predict(X_test).reshape(-1, 1)).ravel()
actual = scaler.inverse_transform(y_test.reshape(-1, 1)).ravel()
print("MAPE:", round(np.mean(np.abs(actual - pred) / actual) * 100, 2))
نقش C، gamma و epsilon
C تعیین میکند خطاهای بیرون لوله چقدر جریمه شوند. C بزرگ یعنی مدل سعی میکند همهی نقطهها را دقیق بگیرد و خطر بیشبرازش بالا میرود. gamma دامنهی اثر هر نمونه در کرنل است. gamma بزرگ یعنی هر نمونه فقط روی همسایههای خیلی نزدیکش اثر دارد.
epsilon پهنای لوله است. epsilon بزرگ یعنی خطاهای بیشتری نادیده گرفته میشوند و مدل سادهتر میشود. این سه پارامتر را با جستجوی شبکهای و TimeSeriesSplit تنظیم کنید. هرگز با اعتبارسنجی تصادفی، چون نشت آینده رخ میدهد.
ویژگیهای بیشتر؛ مزیت اصلی SVR
یکی از مزیتهای رویکرد پنجرهسازی این است که ویژگیهای دیگر هم راحت اضافه میشوند. ARIMA در اصل تکمتغیره است. اما در SVR میشود هر ستون تازهای را کنار ویژگیهای تأخیری گذاشت.
ویژگیهای تقویمی
ساعت روز، روز هفته و تعطیل بودن سه ویژگی تقویمی مهم برای مصرف برقاند. اینها از خود تاریخ ساخته میشوند و در لحظهی پیشبینی همیشه در دسترساند. پس هیچ خطر نشتی ندارند.
یک نکتهی ظریف هم هست. ساعت روز یک متغیر چرخهای است؛ ساعت ۲۳ به ساعت صفر نزدیک است، نه دور. برای نشان دادن این نزدیکی، ساعت را با سینوس و کسینوس رمزگذاری کنید. این دو ستون باهم چرخه را درست به مدل میفهمانند.
متغیرهای بیرونی مثل دما
دادهی GEFCom دمای هوا را هم دارد. دما اثر مستقیم روی مصرف برق دارد، به خاطر سرمایش و گرمایش. اما مراقب باشید. در لحظهی پیشبینی، دمای واقعی ساعت بعد را نمیدانید؛ فقط پیشبینی هواشناسی را دارید.
اگر در آموزش دمای واقعی و در استفادهی واقعی دمای پیشبینیشده بدهید، مدل در عمل بدتر از آزمون عمل میکند. برای ارزیابی صادقانه، در آزمون هم از همان نوع دادهای استفاده کنید که در عمل در دسترس است.
مقایسه منصفانه؛ خط پایه، ARIMA و SVR
حالا سه مدل داریم؛ خط پایهی فصلی، SARIMA و SVR. مقایسه باید روی همان بازهی آزمون، با همان افق و همان معیار انجام شود. اگر ARIMA با افق سه ساعت سنجیده شد، SVR هم باید با همان افق سنجیده شود.
جدول مقایسه
جدول زیر قالبی برای ثبت نتیجه است. عددها را خودتان اجرا و وارد کنید:
| مدل | MAPE افق ۱ ساعت | MAPE افق ۳ ساعت | زمان آموزش | ویژگی بیرونی |
|---|---|---|---|---|
| خط پایهی فصلی | صفر | ندارد | ||
| SARIMA | متوسط | ندارد | ||
| SVR با پنجره | کم | ندارد | ||
| SVR با تقویم و دما | کم | دارد |
تفسیر نتیجه
اگر SVR با ویژگیهای تقویمی و دما بهوضوح بهتر است، یعنی این اطلاعات بیرونی ارزش دارند. اگر SVR ساده فقط کمی بهتر از SARIMA است، شاید سادگی و بازهی اطمینان ARIMA ارزش بیشتری داشته باشد.
مهمتر از همه، اگر هیچ مدلی از خط پایهی فصلی بهوضوح بهتر نیست، پیام روشن است. یا داده الگوی بیشتری ندارد، یا ویژگیها کافی نیستند. در این حالت، پیچیدهتر کردن مدل کمکی نمیکند.
تمرین عملی؛ سه طول پنجره و یک ویژگی تازه
روی دادهی مصرف برق یا سری زمانی خودتان این آزمایشها را انجام دهید:
- سه پنجره: SVR را با طول پنجرهی ۵، ۲۵ و تأخیرهای انتخابی ۱، ۲، ۲۴ و ۱۶۸ بسازید.
- تنظیم پارامتر: C و gamma را با
TimeSeriesSplitتنظیم کنید. - ویژگی تقویمی: ساعت را با سینوس و کسینوس اضافه کنید و اثرش را بسنجید.
- جدول نهایی: جدول مقایسهی بالا را با عددهای واقعی پر کنید.
در پایان یک جمله بنویسید: کدام تغییر بیشترین بهبود را داد؛ مدل، طول پنجره یا ویژگی تازه؟
سخن پایانی
رگرسیون بردار پشتیبان با لولهی اپسیلون خطاهای کوچک را نادیده میگیرد و با کرنل RBF رابطهی غیرخطی را یاد میگیرد. برای استفاده در سری زمانی، سری را با پنجرهسازی به یک مسئلهی رگرسیون معمولی تبدیل میکنیم. طول پنجره و انتخاب تأخیرها روی نتیجه اثر زیادی دارند.
مزیت اصلی این رویکرد، افزودن آسان ویژگیهای تقویمی و بیرونی است. اما هر ویژگی باید در لحظهی پیشبینی واقعاً در دسترس باشد. و مثل همیشه، مقایسهی منصفانه با ARIMA و خط پایه تعیین میکند کدام مدل ارزش استقرار دارد.
این آموزش بر پایهی درس Time Series Forecasting with Support Vector Regressor از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
رگرسیون بردار پشتیبان چیست؟
رگرسیون بردار پشتیبان یا SVR نسخهی رگرسیونی ماشین بردار پشتیبان است. تابعی پیدا میکند که بیشتر نقطهها درون یک لوله به پهنای اپسیلون دور آن قرار بگیرند و فقط خطاهای بیرون لوله جریمه شوند. با کرنل میتواند رابطهی غیرخطی را هم مدل کند.
پنجرهسازی سری زمانی یعنی چه؟
یعنی سری را به نمونههایی تبدیل کنیم که هرکدام چند مقدار پشت سر هم بهعنوان ورودی و مقدار بعدی بهعنوان هدف دارند. مثلاً پنج ساعت گذشته ورودی و ساعت ششم هدف. با این کار هر مدل رگرسیون معمولی را میشود برای سری زمانی به کار برد.
SVR بهتر است یا ARIMA؟
بستگی به داده دارد. ARIMA برای الگوهای خطی و فصلی پایدار سریع و قابل توضیح است. SVR رابطهی غیرخطی و ویژگیهای بیرونی مثل دما را راحتتر مدل میکند، اما به تنظیم پارامتر و مقیاسبندی حساس است. فقط مقایسه روی دادهی خودتان جواب قطعی میدهد.
پارامترهای C، gamma و epsilon در SVR چه نقشی دارند؟
C تعیین میکند خطاهای بیرون لوله چقدر جریمه شوند؛ C بزرگ یعنی برازش دقیقتر و خطر بیشبرازش. gamma دامنهی اثر هر نمونه در کرنل RBF است. epsilon پهنای لولهای است که خطای داخل آن نادیده گرفته میشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.