
سری زمانی چیست و چرا مدلی که در آزمون ۹۹ درصد دقت داشت، در عمل از پیشبینی سادهی «فردا مثل امروز» بدتر شد؟ پاسخ معمولاً یک کلمه است: نشت. در سری زمانی، مدل خیلی راحت میتواند بیآنکه بفهمید، اطلاعاتی از آینده ببیند. نتیجهی آزمون عالی میشود و نتیجهی واقعی فاجعه.
در قسمتهای قبل با دادههایی کار کردیم که ترتیب ردیفها اهمیتی نداشت. در سری زمانی ترتیب همه چیز است. در این قسمت ویژگیهای سری زمانی را با دادهی واقعی مصرف برق میشناسیم. بعد یاد میگیریم داده را درست تقسیم کنیم و خط پایهای بسازیم که هر مدل پیشرفتهتر باید از آن بهتر باشد.
سری زمانی چیست؟ سه تعریف نزدیک
اصطلاح سری زمانی در سه معنای نزدیک به کار میرود. شناختن تفاوتشان کمک میکند بدانید در هر پروژه دقیقاً چه کاری انجام میدهید.
سری، تحلیل و پیشبینی
خود سری زمانی دنبالهای از نقطههای داده است که به ترتیب زمانی ثبت شدهاند؛ معمولاً در فاصلههای مساوی. مصرف ساعتی برق، قیمت روزانهی سهام و تعداد ثبتنام هفتگی نمونههایی از آناند.
تحلیل سری زمانی یعنی بررسی همین داده برای فهمیدن ساختارش؛ روند، فصلی بودن و رابطه با متغیرهای دیگر. پیشبینی سری زمانی یعنی استفاده از یک مدل برای تخمین مقادیر آینده بر اساس الگوهای گذشته. این قسمت و دو قسمت بعدی روی پیشبینی تمرکز دارند.
چرا سری زمانی با رگرسیون معمولی فرق دارد؟
در رگرسیون معمولی فرض میکنیم نمونهها از هم مستقلاند. ترتیبشان را میشود بر هم زد و چیزی عوض نمیشود. در سری زمانی، هر مشاهده به مشاهدههای قبلی وابسته است. مصرف برق ساعت ۶ عصر به مصرف ساعت ۵ عصر بسیار نزدیک است.
همین وابستگی هم فرصت است و هم خطر. فرصت، چون گذشتهی نزدیک اطلاعات زیادی دربارهی آینده دارد. خطر، چون اگر مراقب نباشید، مدل از آینده برای پیشبینی گذشته استفاده میکند.
شش ویژگی داده سری زمانی
وقتی به نمودار یک سری زمانی نگاه میکنید، باید دنبال چند الگوی مشخص باشید. هر الگو روی انتخاب مدل و روش ارزیابی اثر میگذارد. جدول زیر شش ویژگی اصلی را خلاصه میکند.
| ویژگی | تعریف | مثال |
|---|---|---|
| روند | افزایش یا کاهش پایدار در طول زمان | رشد تدریجی تعداد کاربران |
| فصلی بودن | نوسان تکرارشونده با دورهی ثابت | اوج مصرف برق هر عصر |
| چرخهی بلندمدت | نوسان طولانیتر از یک سال و بدون دورهی ثابت | رکود و رونق اقتصادی |
| واریانس ثابت یا متغیر | پراکندگی نوسان در طول زمان | نوسان بیشتر مصرف در تابستان |
| دادهی پرت | مقداری دور از الگوی معمول | قطعی سراسری برق در یک روز |
| تغییر ناگهانی | جابهجایی پایدار سطح داده | کاهش حضور پس از همهگیری |
روند و فصلی بودن
روند و فصلی بودن دو ویژگیایاند که تقریباً در هر سری زمانی دیده میشوند. روند میگوید داده در بلندمدت به کدام سمت میرود. فصلی بودن میگوید چه الگوهایی با دورهی ثابت تکرار میشوند.
یک سری میتواند چند فصلی بودن همزمان داشته باشد. مصرف برق الگوی روزانه دارد؛ شب کم و عصر زیاد. الگوی هفتگی هم دارد؛ روزهای تعطیل کمتر. الگوی سالانه هم دارد؛ تابستان به خاطر سرمایش بیشتر. مدل خوب باید همهی این الگوها را ببیند.
تغییر ناگهانی؛ دشمن پنهان
تغییر ناگهانی خطرناکترین ویژگی برای پیشبینی است. مثلاً پس از همهگیری کووید، الگوی حضور در کلاسها ناگهان عوض شد. مدلی که روی دادهی پیش از آن آموزش دیده بود، دیگر معتبر نبود.
در دستیار آموزشی هم تغییرهای مشابهی رخ میدهد. تغییر رابط کاربری، شروع یک کمپین تبلیغاتی یا یک دورهی جدید میتواند الگوی پرسشها را بهکلی عوض کند. این رویدادها را در کنار داده ثبت کنید تا هنگام تحلیل بدانید چه اتفاقی افتاده است.
بیشتر بخوانید: کار با شاخص زمانی و resample در pandas را در آموزش pandas برای تحلیل داده با مثال فروش روزانه دیدیم.
داده مصرف برق؛ اولین نگاه
دادهی این قسمت از مسابقهی پیشبینی انرژی GEFCom2014 آمده است. سه سال مصرف ساعتی برق و دما را از ۲۰۱۲ تا ۲۰۱۴ دارد. سؤال ما این است: مصرف ساعت بعد چقدر خواهد بود؟
رسم کل سری و بزرگنمایی
اول کل سری را رسم میکنیم. الگوی سالانه بهوضوح دیده میشود؛ اوج در تابستان و زمستان. بعد روی یک هفته بزرگنمایی میکنیم تا الگوی روزانه دیده شود:
import pandas as pd
import matplotlib.pyplot as plt

energy = pd.read_csv("energy.csv", parse_dates=["timestamp"], index_col="timestamp")[["load"]]
energy.plot(figsize=(12, 4), legend=False)
energy.loc["2014-07-01":"2014-07-07"].plot(figsize=(12, 4), legend=False)
plt.show()
در نمودار یکهفتهای، هر روز یک قله در عصر و یک دره در شب دیده میشود. روزهای آخر هفته هم کمی پایینترند. این همان فصلی بودن چندلایه است که بالاتر گفتیم.
بررسی فاصلهها و مقادیر گمشده
پیش از مدلسازی، مطمئن شوید فاصلهی زمانی بین ردیفها ثابت است. ساعتهای گمشده یا تکراری، مثلاً در تغییر ساعت رسمی، مشکلسازند. با energy.index.to_series().diff().value_counts() میتوانید فاصلهها را بشمارید.
اگر ساعتی گمشده است، با asfreq("h") جایش را باز کنید و با درونیابی پر کنید. هرگز ردیفهای گمشده را بیصدا حذف نکنید. در سری زمانی، حذف یک ردیف یعنی جابهجا شدن همهی ویژگیهای وابسته به زمان.
تقسیم داده بدون نشت آینده
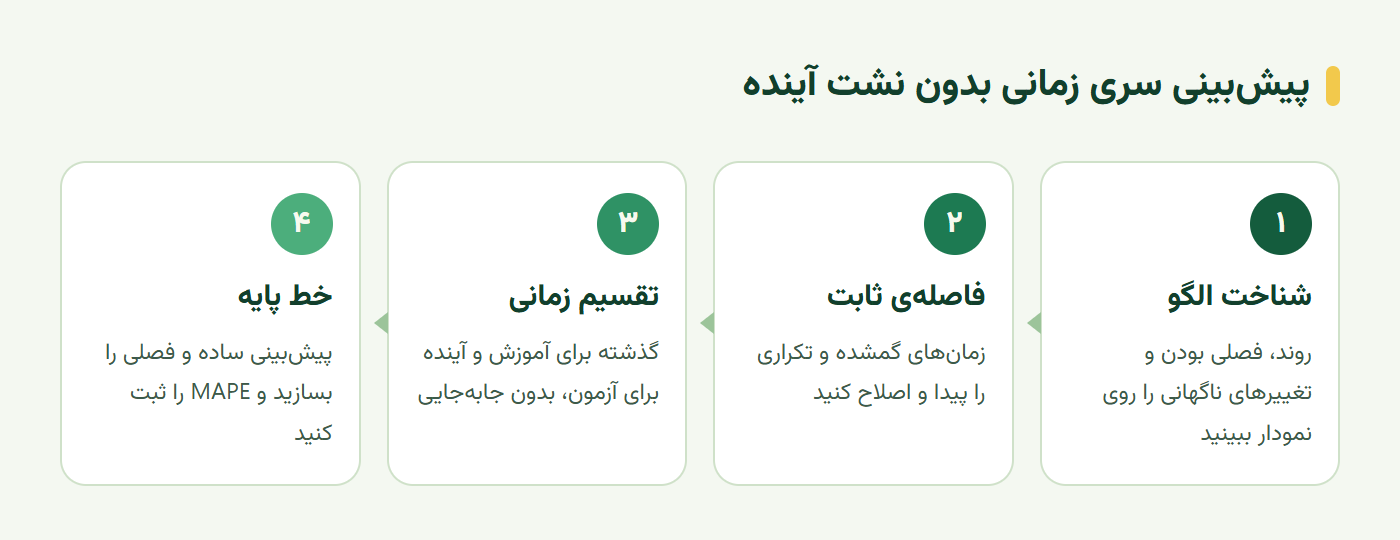
این مهمترین بخش این قسمت است. در سری زمانی، تقسیم تصادفی آموزش و آزمون ممنوع است. نمودار زیر روش درست کار با سری زمانی را در چهار قدم نشان میدهد.
تقسیم زمانی
در تقسیم تصادفی، مدل ساعت ۵ و ۷ عصر را در آموزش میبیند و ساعت ۶ را در آزمون پیشبینی میکند. این کار بسیار آسان است و هیچ ربطی به پیشبینی واقعی آینده ندارد. دقت آزمون فوقالعاده میشود و کاملاً گمراهکننده است.
روش درست تقسیم زمانی است. دادهی قدیمیتر برای آموزش و دادهی جدیدتر برای آزمون. مثلاً آموزش تا پایان سپتامبر ۲۰۱۴ و آزمون از اول نوامبر. فاصلهی یکماهه بین این دو هم مجموعهی اعتبارسنجی است.
ویژگیهای تأخیری فقط از گذشته
ویژگیهای رایج سری زمانی، مقادیر تأخیریاند؛ مثلاً مصرف یک ساعت قبل یا ۲۴ ساعت قبل. این ویژگیها با shift ساخته میشوند و فقط به گذشته نگاه میکنند. اما ویژگیهایی مثل «میانگین کل ماه» اگر شامل ساعتهای بعدی باشند، نشت آیندهاند.
قاعدهی ساده این است: برای هر ردیف بپرسید آیا این مقدار در لحظهی پیشبینی واقعاً در دسترس بود؟ اگر نه، آن ویژگی را حذف کنید. برای اعتبارسنجی متقابل هم از TimeSeriesSplit در scikit-learn استفاده کنید که همیشه آموزش را پیش از آزمون نگه میدارد.
خط پایه؛ فردا مثل امروز
پیش از هر مدل پیشرفته، دو خط پایهی ساده بسازید. این خطهای پایه در سری زمانی بهطرز شگفتآوری قویاند. بسیاری از مدلهای پیچیده در عمل از آنها بهتر نیستند.
خط پایهی ساده و فصلی
خط پایهی ساده میگوید مقدار بعدی برابر آخرین مقدار دیدهشده است. خط پایهی فصلی میگوید مقدار این ساعت برابر همین ساعت در دیروز است. برای مصرف برق که الگوی روزانهی قوی دارد، خط پایهی فصلی معمولاً بسیار خوب کار میکند.
train, test = energy.loc[:"2014-10-31"], energy.loc["2014-11-01":]
naive = energy["load"].shift(1).loc[test.index]
seasonal = energy["load"].shift(24).loc[test.index]

def mape(y, p):
    return ((y - p).abs() / y).mean() * 100

print("naive MAPE:", round(mape(test["load"], naive), 2))
print("seasonal MAPE:", round(mape(test["load"], seasonal), 2))
معیار MAPE
MAPE یا میانگین درصد خطای مطلق، خطا را بهصورت درصدی از مقدار واقعی نشان میدهد. برای گزارش به مدیر بسیار گویاست؛ «پیشبینیها بهطور میانگین سه درصد خطا دارند». اما یک ضعف دارد؛ وقتی مقدار واقعی نزدیک صفر است، MAPE منفجر میشود.
برای دادههایی مثل تعداد پرسش در ساعتهای شب که ممکن است صفر باشند، از MAE یا RMSE استفاده کنید. معیار را پیش از ساخت مدل انتخاب کنید و برای همهی مدلها، از جمله خطهای پایه، همان را گزارش دهید.
تمرین عملی؛ خط پایهی سری زمانی
یک سری زمانی از پروژهی خودتان انتخاب کنید؛ مثلاً تعداد پرسش ساعتی یا روزانهی کاربران. این کارها را انجام دهید:
- رسم و الگوها: کل سری و یک بازهی کوتاه را رسم کنید و روند و فصلی بودن را توضیح دهید.
- فاصلهها: ساعتها یا روزهای گمشده و تکراری را پیدا کنید.
- رویدادها: دستکم یک تغییر ناگهانی را با تاریخ و علت احتمالی ثبت کنید.
- تقسیم زمانی: آموزش، اعتبارسنجی و آزمون را بر اساس تاریخ جدا کنید.
- دو خط پایه: خط پایهی ساده و فصلی را بسازید و MAE یا MAPE هرکدام را گزارش کنید.
این دو عدد را نگه دارید. در دو قسمت بعدی، ARIMA و SVR باید از آنها بهتر باشند.
سخن پایانی
سری زمانی دنبالهای از مشاهدات مرتب در زمان است و ترتیبش اطلاعات دارد. روند، فصلی بودن، چرخه، واریانس، دادهی پرت و تغییر ناگهانی شش الگوییاند که باید در آن جستجو کنید. دادهی مصرف برق نشان داد یک سری میتواند چند فصلی بودن همزمان داشته باشد.
مهمترین درس این قسمت اما جلوگیری از نشت آینده است. داده را فقط بر اساس زمان تقسیم کنید، ویژگیها را فقط از گذشته بسازید و همیشه با خط پایهی ساده و فصلی مقایسه کنید. مدلی که از «فردا مثل امروز» بهتر نیست، هنوز چیزی یاد نگرفته است.
این آموزش بر پایهی درس Introduction to time series forecasting از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
سری زمانی چیست؟
سری زمانی مجموعهای از مشاهدات است که به ترتیب زمانی و معمولاً در فاصلههای مساوی ثبت شدهاند؛ مثل مصرف ساعتی برق، فروش روزانه یا تعداد پرسشهای هفتگی کاربران. ترتیب در سری زمانی اطلاعات دارد و نباید به هم بخورد.
تفاوت روند و فصلی بودن چیست؟
روند تغییر بلندمدت و پایدار سطح داده است؛ مثل رشد تدریجی تعداد کاربران. فصلی بودن نوسان تکرارشونده با دورهی ثابت است؛ مثل بالا رفتن مصرف برق هر روز عصر یا فروش بیشتر پیش از نوروز.
چرا نباید داده سری زمانی را تصادفی تقسیم کرد؟
چون در تقسیم تصادفی، مدل هنگام آموزش نمونههایی از آینده را میبیند و روی گذشته آزمون میشود. این نشت آینده است و دقت آزمون را غیرواقعی بالا میبرد. همیشه دادهی قدیمیتر برای آموزش و دادهی جدیدتر برای آزمون باشد.
خط پایه ساده در سری زمانی چیست؟
سادهترین خط پایه این است که مقدار بعدی را برابر آخرین مقدار دیدهشده پیشبینی کنید. خط پایهی فصلی هم مقدار همان ساعت یا همان روز در دورهی قبل را برمیگرداند. هر مدل پیشرفته باید از این خطهای پایه بهتر باشد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.