
یادگیری تقویتی چیست و چه فرقی با همهی روشهایی دارد که تا اینجا دیدیم؟ در یادگیری نظارتشده، برای هر نمونه پاسخ درست را داشتیم. در یادگیری بدون نظارت، هیچ پاسخی نداشتیم. اما در یادگیری تقویتی، پاسخ درست را نداریم، ولی بازخورد داریم. عامل کاری انجام میدهد و میفهمد نتیجه خوب بود یا بد.
این همان روشی است که کودک دوچرخهسواری یاد میگیرد. کسی به او نمیگوید در هر لحظه فرمان را دقیقاً چند درجه بچرخاند. او امتحان میکند، زمین میخورد و بهتدریج یاد میگیرد. در این قسمت با قصهی موسیقایی پیتر و گرگ، مفاهیم اصلی یادگیری تقویتی و الگوریتم Q-Learning را یاد میگیریم.
یادگیری تقویتی چیست؟ پنج مفهوم پایه
یادگیری تقویتی روشی برای یادگیری رفتار بهینهی یک عامل در یک محیط است. عامل با آزمایشهای زیاد یاد میگیرد کدام رفتار بیشترین پاداش را میدهد. پنج مفهوم پایه این چارچوب را میسازند.
عامل، محیط، حالت، عمل و پاداش
عامل تصمیمگیرنده است؛ در قصهی ما پیتر. محیط دنیایی است که عامل در آن عمل میکند؛ یک صفحهی شطرنجی با زمین، آب، درخت، سیب و گرگ. حالت وضعیت فعلی است؛ اینجا موقعیت پیتر روی صفحه.
عمل کاری است که عامل انجام میدهد؛ پیتر میتواند بالا، پایین، چپ یا راست برود. پاداش بازخوردی است که محیط پس از هر عمل میدهد. رسیدن به سیب پاداش بزرگ دارد و رسیدن به گرگ یا افتادن در آب جریمهی بزرگ.
سیاست؛ آنچه عامل یاد میگیرد
سیاست تابعی است که در هر حالت میگوید چه عملی انجام شود. خروجی یادگیری تقویتی همین سیاست است. سیاست خوب سیاستی است که در بلندمدت بیشترین پاداش را جمع کند.
سادهترین سیاست، گام تصادفی است. پیتر در هر حالت یکی از چهار جهت را تصادفی انتخاب میکند. در آزمایشها، گام تصادفی گاهی به سیب میرسد، اما مسیر بسیار طولانی است و اغلب به گرگ یا آب ختم میشود. سیاست یادگرفته باید بسیار بهتر باشد.
طراحی تابع پاداش
تابع پاداش مهمترین تصمیم طراحی در یادگیری تقویتی است. عامل دقیقاً همان چیزی را بهینه میکند که پاداش میدهید، نه چیزی که در ذهن دارید. اگر پاداش بد طراحی شود، عامل راههای عجیبی برای جمع کردن آن پیدا میکند.
پاداش پراکنده و جریمهی حرکت
در مثال پیتر، پاداش اینطور تعریف میشود. رسیدن به سیب پاداش ده، رسیدن به گرگ یا آب جریمهی منفی ده، و هر حرکت معمولی جریمهی کوچک منفی ۰٫۱. این جریمهی کوچک پیتر را تشویق میکند که کوتاهترین مسیر را پیدا کند.
نکتهی مهم این است که پاداش معنادار فقط در پایان میآید. در شطرنج هم تا پایان بازی نمیدانید برندهاید یا بازنده. به این پاداش پراکنده میگویند. چالش اصلی این است که عامل بفهمد کدام حرکتهای میانی به نتیجهی خوب پایانی کمک کردند.
وقتی عامل تقلب میکند
مثالهای مشهوری از پاداش بد طراحیشده وجود دارد. عاملی در یک بازی قایقرانی، به جای تمام کردن مسابقه، یاد گرفت دور یک نقطه بچرخد و بارها امتیاز جمع کند. از نظر ریاضی کار درستی کرد؛ پاداش را بیشینه کرد.
همین پدیده در دستیارهای هوش مصنوعی هم دیده میشود. اگر دستیار را برای «رضایت کاربر» پاداش دهید، ممکن است یاد بگیرد با هر چیزی که کاربر میگوید موافقت کند. طراحی پاداش یعنی فکر کردن به همهی راههایی که ممکن است به اشتباه بیشینه شود.
بیشتر بخوانید: قسمت اول این مجموعه، هوش مصنوعی چیست؟، نشان داد برنامههای مدرن شطرنج با یادگیری تقویتی و بازی در برابر خودشان قوی شدند.
Q-Learning و معادله بلمن
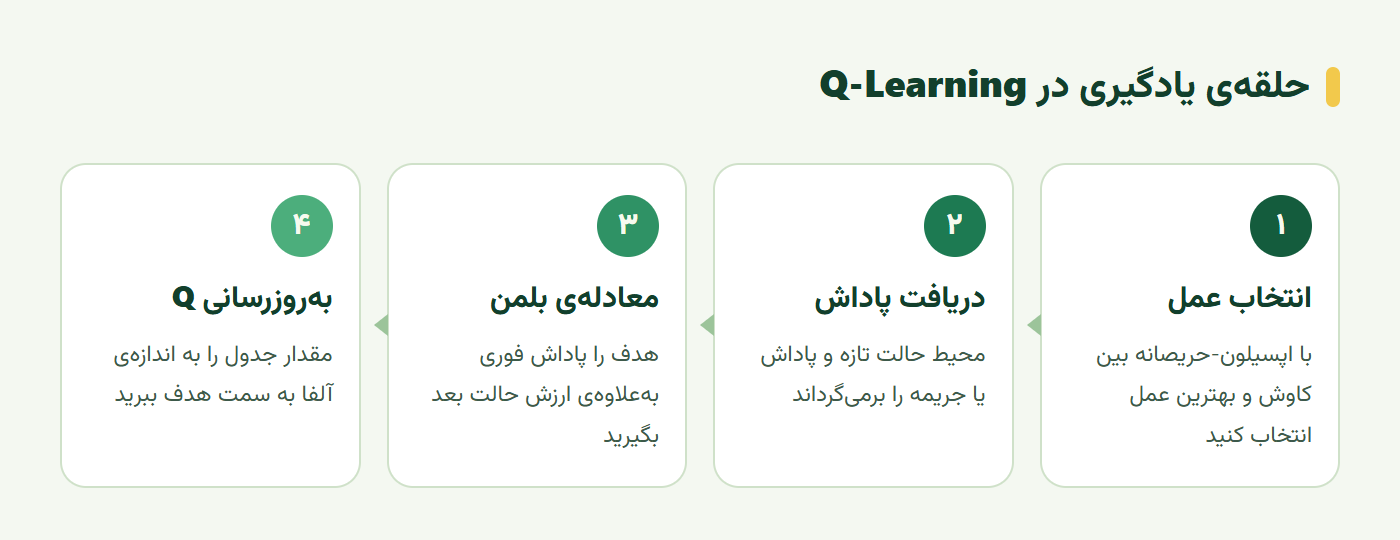
Q-Learning یکی از پایهایترین الگوریتمهای یادگیری تقویتی است. ایدهاش ساده است. جدولی نگه میداریم که برای هر حالت و هر عمل، یک عدد دارد. این عدد تخمین میزند انجام آن عمل در آن حالت در بلندمدت چقدر ارزش دارد. نمودار زیر حلقهی یادگیری را نشان میدهد.
جدول Q
در مثال پیتر با صفحهی هشت در هشت و چهار عمل، جدول Q آرایهای با ۲۵۶ خانه است. در ابتدا همهی خانهها مقدار یکسان دارند؛ یعنی پیتر هیچ ترجیحی ندارد. با هر تجربه، این مقادیر تغییر میکنند.
پس از یادگیری، سیاست ساده است. در هر حالت، عملی را انتخاب کن که بیشترین مقدار Q را دارد. اگر مقادیر Q را به شکل پیکان روی صفحه رسم کنید، مسیر پیتر به سمت سیب دیده میشود.
معادلهی بلمن و ضریب تخفیف
سؤال اصلی این است که مقدار Q را چطور بهروز کنیم. پاسخ از معادلهی بلمن میآید. ارزش یک عمل برابر است با پاداش فوری آن، بهعلاوهی بهترین ارزش ممکن در حالت بعدی. این ایده پاداش پایانی را بهتدریج به حرکتهای قبلی منتقل میکند.
ضریب تخفیف که با گاما نشان داده میشود، عددی بین صفر و یک است. تعیین میکند پاداش آینده چقدر ارزش دارد. گامای نزدیک یک یعنی عامل آیندهنگر است. گامای نزدیک صفر یعنی فقط پاداش فوری برایش مهم است. نرخ یادگیری آلفا هم تعیین میکند هر تجربهی تازه چقدر مقدار قبلی را تغییر دهد.
کاوش و بهرهبرداری
یک مشکل مهم باقی مانده است. اگر پیتر همیشه بهترین عمل شناختهشده را انتخاب کند، ممکن است هرگز مسیر بهتری را کشف نکند. اگر همیشه تصادفی حرکت کند، هرگز از دانستههایش استفاده نمیکند. این معمای کاوش و بهرهبرداری است.
سیاست اپسیلون-حریصانه
راهحل رایج سیاست اپسیلون-حریصانه است. با احتمال اپسیلون، مثلاً ده درصد، عمل تصادفی انتخاب میشود. با احتمال باقیمانده، بهترین عمل طبق جدول Q. در ابتدای یادگیری اپسیلون بزرگ است تا کاوش زیاد باشد و بهتدریج کوچک میشود.
این معما فقط در بازیها نیست. سیستم پیشنهاد دوره در دستیار آموزشی هم با آن روبهروست. اگر همیشه دورههای محبوب را پیشنهاد دهد، هرگز نمیفهمد دورهی تازهای شاید برای کاربری مناسبتر باشد.
پیادهسازی Q-Learning با پایتون
کد زیر یک عامل را در یک راهروی ساده آموزش میدهد. خانهی سمت چپ گرگ و خانهی سمت راست سیب است. عامل از وسط شروع میکند:
import numpy as np
N, actions = 7, [-1, +1] # خانهها و دو عمل: چپ و راست
Q = np.zeros((N, len(actions)))
alpha, gamma, eps = 0.5, 0.9, 0.2
rng = np.random.default_rng(0)
def step(s, a):
s2 = s + actions[a]
if s2 == 0:
return s2, -10, True # گرگ
if s2 == N - 1:
return s2, 10, True # سیب
return s2, -0.1, False
for episode in range(300):
s, done = N // 2, False
while not done:
a = rng.integers(2) if rng.random() < eps else int(np.argmax(Q[s]))
s2, r, done = step(s, a)
target = r if done else r + gamma * Q[s2].max()
Q[s, a] += alpha * (target - Q[s, a])
s = s2
print(["LR"[int(np.argmax(q))] for q in Q[1:-1]])پس از آموزش، خروجی برای همهی خانههای میانی «R» است؛ یعنی حرکت به سمت سیب. خط target همان معادلهی بلمن است. اگر حالت پایانی باشد، فقط پاداش فوری حساب میشود.
تمرین عملی؛ آزمایش با پارامترها
روی کد بالا این آزمایشها را انجام دهید و نتیجه را یادداشت کنید:
- ضریب تخفیف: گاما را ۰٫۱ کنید و ببینید آیا عامل هنوز مسیر سیب را پیدا میکند.
- جریمهی حرکت: جریمهی ۰٫۱ را صفر کنید و تعداد قدمها تا سیب را مقایسه کنید.
- کاوش: اپسیلون را صفر کنید و ببینید عامل در شروع چه رفتاری دارد.
- محیط بزرگتر: راهرو را به یک صفحهی دوبعدی پنج در پنج با یک مانع گسترش دهید.
پیش از هر آزمایش، نتیجهای را که انتظار دارید بنویسید. بعد با نتیجهی واقعی مقایسه کنید.
سخن پایانی
یادگیری تقویتی روشی برای یادگیری از تجربه است. عامل در محیط عمل میکند، پاداش میگیرد و بهتدریج سیاستی یاد میگیرد که در بلندمدت بیشترین پاداش را بدهد. طراحی تابع پاداش مهمترین و خطرناکترین بخش آن است.
Q-Learning با جدولی از ارزشها و معادلهی بلمن، پاداش پایانی را به حرکتهای قبلی منتقل میکند. سیاست اپسیلون-حریصانه هم تعادل کاوش و بهرهبرداری را حفظ میکند. همین ایدهها، در مقیاس بسیار بزرگتر، پشت تنظیم مدلهای زبانی با بازخورد انسانی هم هستند.
این آموزش بر پایهی درس Introduction to Reinforcement Learning and Q-Learning از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
یادگیری تقویتی چیست؟
یادگیری تقویتی شاخهای از یادگیری ماشین است که در آن یک عامل با انجام عمل در یک محیط و دریافت پاداش یا جریمه، یاد میگیرد چه رفتاری در بلندمدت بیشترین پاداش را میدهد. دادهی برچسبخورده ندارد و از تجربهی خودش یاد میگیرد.
Q-Learning چیست؟
Q-Learning الگوریتمی برای یادگیری تقویتی است که جدولی به نام جدول Q نگه میدارد. هر خانهی این جدول ارزش انجام یک عمل در یک حالت را تخمین میزند. عامل با هر تجربه این ارزشها را با معادلهی بلمن بهروز میکند و در پایان در هر حالت عملی با بیشترین ارزش را انتخاب میکند.
تعادل کاوش و بهرهبرداری یعنی چه؟
عامل باید بین امتحان کردن عملهای تازه برای یافتن گزینهی بهتر، یعنی کاوش، و استفاده از بهترین عملی که تا الان میشناسد، یعنی بهرهبرداری، تعادل برقرار کند. روش رایج اپسیلون-حریصانه است که با احتمال کمی عمل تصادفی انجام میدهد.
یادگیری تقویتی چه کاربردهایی دارد؟
بازیها مثل شطرنج و Go، رباتیک، کنترل سیستمهایی مثل سرمایش مراکز داده، سیستمهای پیشنهاددهنده و تنظیم مدلهای زبانی بزرگ با بازخورد انسانی. در همهی اینها تصمیمها پشت سر هماند و نتیجهی نهایی با تأخیر معلوم میشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.