
ساخت شبکه عصبی امروز به لطف کتابخانههایی مثل Keras و PyTorch کار چند دقیقه است. اما شبکهای که روی دادهی آموزش ۹۹ درصد دقت دارد و روی دادهی تازه ۸۵ درصد، شبکهی خوبی نیست. بخش سخت کار نوشتن لایهها نیست؛ فهمیدن این است که شبکه واقعاً یاد گرفته یا فقط حفظ کرده است.
در قسمت ششم ریاضی پرسپترون، نزول گرادیان و پسانتشار را از صفر دیدیم. حالا با آن پایه، اولین شبکهی عصبی واقعی را روی دادهی واقعی میسازیم. در این قسمت ارقام دستنویس MNIST را تشخیص میدهیم و یاد میگیریم بیشبرازش را ببینیم و درمانش کنیم.
از نورون تا شبکه؛ مرور کوتاه
شبکهی عصبی مصنوعی از تعداد زیادی نورون ساده ساخته شده است. هر نورون ورودیهایش را با وزنهایی جمع میکند و حاصل را از یک تابع فعالسازی عبور میدهد. نورونها در لایههایی کنار هم قرار میگیرند و خروجی هر لایه، ورودی لایهی بعد است.
چرا به چارچوب نیاز داریم؟
برای آموزش مؤثر شبکه، دو کار باید سریع انجام شود. اول، عملیات روی تنسورها؛ یعنی ضرب ماتریس، جمع و توابعی مثل سیگموید و softmax. دوم، محاسبهی گرادیان همهی این عبارتها برای نزول گرادیان. در قسمت ششم این دو را دستی نوشتیم.
چارچوبهایی مثل PyTorch و TensorFlow هر دو را خودکار انجام میدهند. گرادیانها را با مشتقگیری خودکار حساب میکنند و محاسبات را روی پردازندهی گرافیکی اجرا میکنند. Keras رابط سطح بالایی است که ساخت شبکه را به چند خط کد تبدیل میکند.
دادهی MNIST
MNIST مجموعهای از ۷۰ هزار تصویر ارقام دستنویس صفر تا نه است. هر تصویر ۲۸ در ۲۸ پیکسل سیاهوسفید است. ۶۰ هزار تصویر برای آموزش و ۱۰ هزار برای آزمون جدا شدهاند.
این داده «سلام دنیا»ی یادگیری عمیق است. به اندازهی کافی ساده است که روی لپتاپ در چند دقیقه آموزش ببیند. اما به اندازهی کافی واقعی است که همهی مشکلات مهم مثل بیشبرازش در آن دیده شود.
ساخت شبکه عصبی چندلایه با Keras
اولین شبکهی ما سه لایه دارد. لایهی اول تصویر ۲۸ در ۲۸ را به یک بردار ۷۸۴ تایی تخت میکند. لایهی پنهان ۱۲۸ نورون با تابع فعالسازی ReLU دارد. لایهی خروجی ۱۰ نورون با softmax دارد که احتمال هر رقم را میدهد.
کد شبکه
پیش از آموزش، مقدار پیکسلها را از بازهی صفر تا ۲۵۵ به صفر تا یک میبریم. این کار آموزش را پایدارتر میکند:
import keras
from keras import layers

(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()
x_train, x_test = x_train / 255.0, x_test / 255.0

model = keras.Sequential([
    layers.Input(shape=(28, 28)),
    layers.Flatten(),
    layers.Dense(128, activation="relu"),
    layers.Dense(10, activation="softmax"),
])
model.compile(optimizer="adam", loss="sparse_categorical_crossentropy", metrics=["accuracy"])
history = model.fit(x_train, y_train, epochs=20, batch_size=128, validation_split=0.1)
معنای هر بخش
Dense یک لایهی کاملاً متصل است؛ هر نورون به همهی ورودیها وصل است. تابع خطای sparse_categorical_crossentropy برای دستهبندی چندکلاسه با برچسب عددی مناسب است. بهینهساز Adam نسخهی هوشمندتری از نزول گرادیان است که نرخ یادگیری را برای هر وزن تنظیم میکند.
validation_split=0.1 ده درصد دادهی آموزش را برای اعتبارسنجی کنار میگذارد. این مهمترین پارامتر این کد است. بدون آن، نمیتوانید بیشبرازش را ببینید. دادهی آزمون را تا آخر کار دست نزنید.
بیشتر بخوانید: نزول گرادیان، نرخ یادگیری و پسانتشار خطا را که پشت model.fit کار میکنند، در شبکه عصبی چیست؟ از صفر ساختیم.
تشخیص بیشبرازش از نمودار آموزش
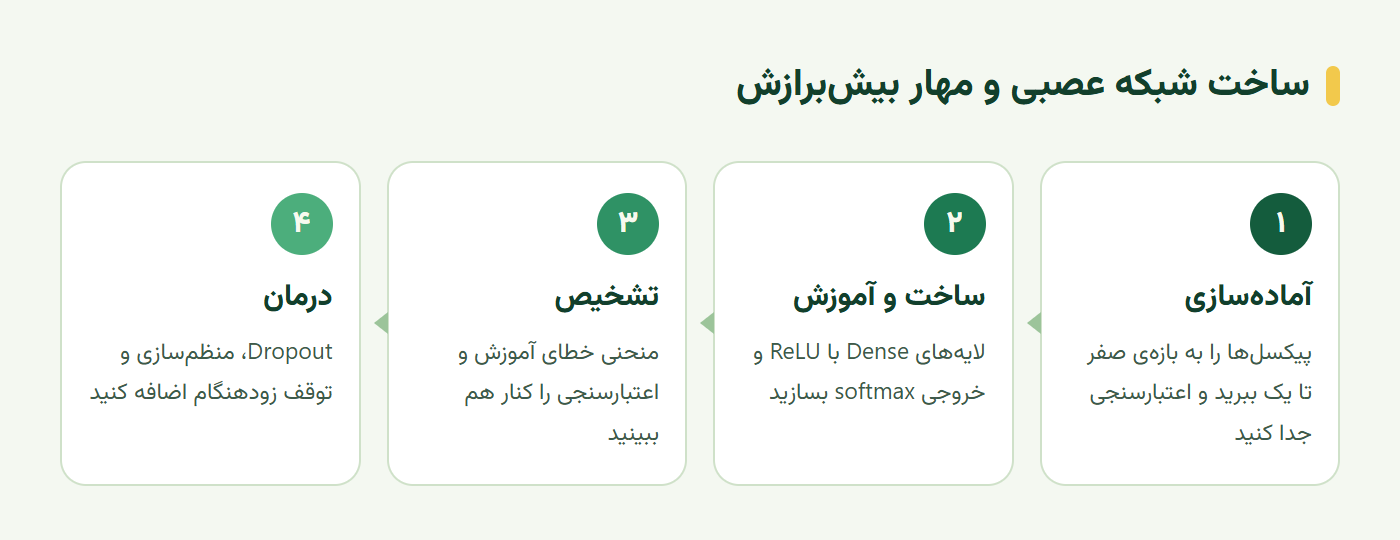
شیء history خطا و دقت آموزش و اعتبارسنجی را برای هر دوره نگه میدارد. رسم این دو منحنی کنار هم مهمترین ابزار تشخیص است. نمودار زیر چهار قدم تشخیص و درمان بیشبرازش را نشان میدهد.
شکل منحنیها
در دورههای اول، هر دو خطا کم میشوند. مدل در حال یادگیری الگوهای واقعی است. از جایی به بعد، خطای آموزش همچنان کم میشود، اما خطای اعتبارسنجی ثابت میماند یا حتی بالا میرود. از این نقطه، مدل در حال حفظ کردن دادهی آموزش است.
در شبکهی سادهی ما روی MNIST، معمولاً پس از چند دوره این جدایی دیده میشود. دقت آموزش به نزدیک صد درصد میرسد و دقت اعتبارسنجی حدود ۹۸ درصد میماند. فاصله کم است، اما با شبکهی بزرگتر یا دادهی کمتر بهسرعت زیاد میشود.
تعادل بایاس و واریانس
بیشبرازش یک حالت از مسئلهی کلیتری به نام تعادل بایاس و واریانس است. خطای مدل دو منبع اصلی دارد. خطای بایاس از ساده بودن بیش از حد مدل میآید؛ مدل الگو را نمیگیرد. خطای واریانس از حساسیت زیاد به نویز دادهی آموزش میآید.
در طول آموزش، بایاس کم میشود و واریانس بالا میرود. بهترین نقطه جایی است که مجموع این دو کمترین است. همان جایی که خطای اعتبارسنجی به کمینه میرسد. آموزش بعد از آن نقطه فقط واریانس را زیاد میکند.
جلوگیری از بیشبرازش
وقتی بیشبرازش را دیدید، سه راه اصلی دارید. دادهی آموزش را بیشتر کنید، پیچیدگی مدل را کم کنید، یا از روشهای منظمسازی استفاده کنید. در عمل معمولاً ترکیبی از اینها به کار میرود.
Dropout و منظمسازی وزن
Dropout در هر گام آموزش، درصدی از نورونها را تصادفی خاموش میکند. شبکه نمیتواند به یک نورون خاص تکیه کند و مجبور است الگوهای مقاومتری یاد بگیرد. نرخ ۰٫۲ تا ۰٫۵ رایج است. در زمان پیشبینی، Dropout خودکار غیرفعال میشود.
منظمسازی وزن، مثل L2، وزنهای بزرگ را جریمه میکند. وزنهای کوچکتر یعنی مدل هموارتر که کمتر به جزئیات نویزی واکنش نشان میدهد. در Keras با پارامتر kernel_regularizer در هر لایه اضافه میشود.
توقف زودهنگام
سادهترین و مؤثرترین روش، توقف زودهنگام است. خطای اعتبارسنجی را در هر دوره میپاییم. اگر چند دوره پشت سر هم بهتر نشد، آموزش را متوقف میکنیم و بهترین وزنها را برمیگردانیم:
model = keras.Sequential([
    layers.Input(shape=(28, 28)),
    layers.Flatten(),
    layers.Dense(256, activation="relu"),
    layers.Dropout(0.3),
    layers.Dense(10, activation="softmax"),
])
model.compile(optimizer="adam", loss="sparse_categorical_crossentropy", metrics=["accuracy"])
stop = keras.callbacks.EarlyStopping(monitor="val_loss", patience=3, restore_best_weights=True)
model.fit(x_train, y_train, epochs=50, batch_size=128, validation_split=0.1, callbacks=[stop])
print(model.evaluate(x_test, y_test, verbose=0))
patience=3 یعنی سه دوره بدون بهبود صبر میکند. restore_best_weights=True هم مطمئن میشود مدل نهایی همان بهترین مدل است، نه مدل آخرین دوره. حالا میشود تعداد دورهها را بزرگ گذاشت و نگران بیشبرازش نبود.
تمرین عملی؛ سه شبکه، یک نمودار
روی MNIST این سه آزمایش را انجام دهید و منحنی خطای اعتبارسنجی هر سه را روی یک نمودار رسم کنید:
- شبکهی کوچک: یک لایهی پنهان با ۳۲ نورون.
- شبکهی بزرگ: سه لایهی پنهان با ۵۱۲ نورون و بدون Dropout.
- شبکهی منظم: همان شبکهی بزرگ با Dropout و توقف زودهنگام.
برای هر شبکه، دقت آموزش، دقت اعتبارسنجی و فاصلهی این دو را بنویسید. بعد تشخیص دهید کدام کمبرازش، کدام بیشبرازش و کدام متعادل است. در پایان، فقط شبکهی منتخب را روی دادهی آزمون بسنجید.
سخن پایانی
ساخت شبکه عصبی با Keras چند خط کد است؛ لایهی تختکننده، لایهی پنهان با ReLU و لایهی خروجی با softmax. چارچوبها محاسبهی تنسور و گرادیان را خودکار انجام میدهند. اما کار اصلی، فهمیدن رفتار شبکه در طول آموزش است.
نمودار خطای آموزش و اعتبارسنجی مهمترین ابزار شماست. جدایی این دو منحنی نشانهی بیشبرازش است و Dropout، منظمسازی و توقف زودهنگام درمان آن. همیشه با دادهی اعتبارسنجی تصمیم بگیرید و دادهی آزمون را برای قضاوت نهایی نگه دارید.
این آموزش بر پایهی درسهای Introduction to Neural Networks و Neural Network Frameworks از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
برای ساخت شبکه عصبی با پایتون از کدام کتابخانه استفاده کنیم؟
دو چارچوب اصلی PyTorch و TensorFlow هستند. Keras رابط سطح بالای TensorFlow است و برای شروع سادهتر است. PyTorch انعطاف بیشتری دارد و در پژوهش رایجتر است. مفاهیم در هر دو یکساناند و یادگیری یکی، دیگری را آسان میکند.
چطور بفهمیم شبکه عصبی بیشبرازش دارد؟
در نمودار آموزش، اگر خطای آموزش همچنان کم میشود اما خطای اعتبارسنجی از جایی ثابت میماند یا بالا میرود، مدل در حال حفظ کردن دادهی آموزش است. فاصلهی زیاد بین دقت آموزش و اعتبارسنجی نشانهی روشن بیشبرازش است.
Dropout چیست؟
Dropout روشی برای جلوگیری از بیشبرازش است که در هر گام آموزش، درصدی از نورونها را تصادفی خاموش میکند. این کار شبکه را مجبور میکند به یک نورون خاص وابسته نشود و الگوهای مقاومتری یاد بگیرد. در زمان پیشبینی Dropout غیرفعال است.
تعادل بایاس و واریانس یعنی چه؟
خطای مدل دو منبع اصلی دارد. بایاس خطای ناشی از ساده بودن بیش از حد مدل است که الگو را نمیگیرد. واریانس خطای ناشی از حساسیت زیاد به نویز دادهی آموزش است. مدل خوب بین این دو تعادل برقرار میکند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.