
عیبیابی مدل وقتی لازم میشود که مدل با دقت ۹۰ درصد مستقر شده، اما شکایتها ادامه دارد. عدد دقت کلی درست است، اما هیچچیز دربارهی ده درصد خطا نمیگوید. آیا این خطاها تصادفیاند یا روی یک گروه از کاربران متمرکز شدهاند؟ ناشی از دادهی کماند یا ویژگی نادرست؟ عیبیابی به همین سؤالها پاسخ میدهد.
در قسمتهای قبل دهها مدل ساختیم و با معیارهای مختلف سنجیدیم. این قسمت پایان بخش یادگیری ماشین کلاسیک است. در این قسمت یاد میگیریم وقتی مدل خوب کار نمیکند، چطور علت را پیدا کنیم. ابزارهایمان تحلیل خطا، مقایسهی گروهها، اهمیت ویژگی و منحنی یادگیریاند.
چرا یک عدد دقت کافی نیست؟
معیارهای سنتی مثل دقت، دقت مثبت و MAE همه میانگیناند. میانگین روی کل داده حساب میشود و همهی تفاوتها را صاف میکند. مدلی که روی ۹۰ درصد داده بینقص و روی ۱۰ درصد کاملاً اشتباه است، همان دقت کلی مدلی را دارد که خطاهایش همهجا پخش شده است.
اما این دو مدل از نظر عملی کاملاً متفاوتاند. در اولی، یک گروه مشخص از کاربران همیشه نتیجهی بد میگیرند. در دومی، خطا قابل پیشبینی نیست. راهحل هر کدام هم متفاوت است. عیبیابی یعنی فهمیدن اینکه با کدام حالت روبهرو هستیم.
چهار سؤال عیبیابی
هر فرایند عیبیابی به این چهار سؤال پاسخ میدهد:
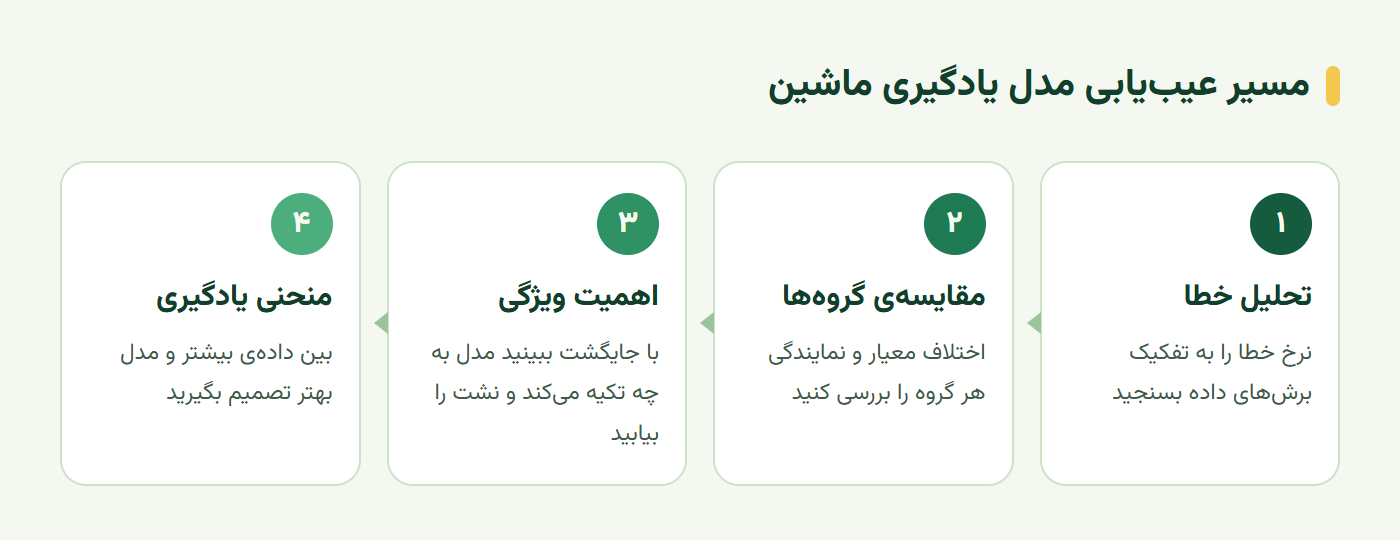
- کجا: نرخ خطا در کدام بخش از داده بیشتر است؟
- برای چه کسی: آیا عملکرد بین گروههای مختلف کاربران تفاوت دارد؟
- چرا در داده: آیا بخش ضعیف در دادهی آموزش کمنماینده است؟
- چرا در مدل: مدل به کدام ویژگیها بیشتر تکیه میکند؟
ترتیب مهم است. اول محل خطا را پیدا کنید، بعد علتش را. بدون دانستن محل، جستجوی علت مثل گشتن در تاریکی است.
تحلیل خطا؛ خطاها کجا جمع شدهاند؟
تحلیل خطا نمونههای آزمون را بر اساس ویژگیها گروهبندی میکند و نرخ خطای هر گروه را حساب میکند. هدف پیدا کردن گروههایی است که نرخ خطایشان بهوضوح از میانگین بالاتر است. نمودار زیر مسیر کامل عیبیابی را نشان میدهد.
برش داده با pandas
سادهترین راه، برش داده بر اساس چند ویژگی و محاسبهی نرخ خطاست. فرض کنید مدلی موضوع پیامهای پشتیبانی را تشخیص میدهد. کد زیر نرخ خطا را به تفکیک طول پیام و نوع کاربر نشان میدهد:
import pandas as pd

test = X_test.copy()
test["error"] = model.predict(X_test) != y_test
test["length_bin"] = pd.cut(test["length"], [0, 20, 60, 200, 10_000])

report = (test.groupby(["length_bin", "user_type"], observed=True)["error"]
              .agg(error_rate="mean", n="size")
              .sort_values("error_rate", ascending=False))
print(report.head(8))
نتیجه ممکن است نشان دهد پیامهای کوتاهتر از بیست نویسه از کاربران تازه، نرخ خطای سه برابر میانگین دارند. حالا میدانید کجا را بررسی کنید.
درخت تصمیم روی خطاها
وقتی ویژگیها زیادند، بررسی همهی ترکیبها با دست ممکن نیست. یک ترفند هوشمندانه، آموزش یک درخت تصمیم کوچک است که پیشبینی کند مدل اصلی کجا اشتباه میکند. شاخههایی از درخت که نرخ خطای بالا دارند، گروههای مشکلدار را خودکار پیدا میکنند.
داشبورد هوش مصنوعی مسئولانه مایکروسافت همین کار را با یک نقشهی درختی تعاملی انجام میدهد. رنگ قرمزتر یعنی نرخ خطای بالاتر و ضخامت بیشتر یعنی نمونههای بیشتر. این ابزار برای تیمهایی که زیاد عیبیابی میکنند، زمان زیادی صرفهجویی میکند.
بیشتر بخوانید: ارزیابی تفکیکی برای گروههای کاربران و آسیب کیفیت خدمات را در سوگیری در هوش مصنوعی با مثال دیدیم.
مقایسه گروهها و نمایندگی داده
وقتی گروه مشکلدار پیدا شد، دو سؤال پیش میآید. آیا تفاوت عملکرد بین گروهها معنادار است؟ و آیا این گروه در دادهی آموزش به اندازهی کافی حضور داشت؟
اختلاف عملکرد و نرخ انتخاب
برای مقایسهی گروهها، معیار را برای هر گروه جداگانه حساب کنید و بیشترین اختلاف را گزارش دهید. این اختلاف میتواند در دقت، نرخ خطا، بازیابی یا MAE باشد. در مسائلی که مدل تصمیم مثبت یا منفی میگیرد، نرخ انتخاب هم مهم است؛ یعنی چه نسبتی از هر گروه پیشبینی مثبت گرفتهاند.
مثلاً اگر مدل پیشنهاد بورسیه برای یک گروه ۴۰ درصد و برای گروه دیگر ۱۰ درصد مثبت پیشبینی کند، این اختلاف نیاز به بررسی دارد. شاید توجیه داشته باشد، شاید نه. اما باید دیده و توضیح داده شود.
نمایندگی داده
رونالد کوز، اقتصاددان، جملهی مشهوری دارد: اگر داده را به اندازهی کافی شکنجه کنید، به هر چیزی اعتراف میکند. داده میتواند نتیجهی گمراهکننده بدهد، مخصوصاً وقتی یک گروه در آن کمنماینده است.
پس برای گروه مشکلدار، تعداد نمونههای آموزش را بشمارید. اگر گروهی که نرخ خطای بالا دارد فقط دو درصد دادهی آموزش است، علت احتمالاً کمبود داده است. راهحل هم جمعآوری دادهی بیشتر از همان گروه است، نه تغییر الگوریتم.
اهمیت ویژگی؛ مدل به چه چیزی تکیه میکند؟
دانستن اینکه مدل به کدام ویژگیها تکیه میکند، دو فایده دارد. اول، اگر مدل به ویژگی بیربط یا نشتدار تکیه کند، فوراً معلوم میشود. دوم، میتوانید تصمیم مدل را برای کاربر یا مدیر توضیح دهید.
اهمیت ویژگی جایگشتی
اهمیت ویژگی جایگشتی ساده و مستقل از نوع مدل است. مقادیر یک ستون را در دادهی آزمون تصادفی به هم میریزیم و افت عملکرد را میسنجیم. هرچه افت بیشتر، ویژگی مهمتر:
from sklearn.inspection import permutation_importance

result = permutation_importance(model, X_test, y_test, n_repeats=10,
                                random_state=0, scoring="f1_macro")
imp = pd.Series(result.importances_mean, index=X_test.columns).sort_values()
print(imp.tail(10))
اگر مهمترین ویژگی «شمارهی ردیف» یا «تاریخ ثبت» باشد، زنگ خطر است. احتمالاً نشت داده دارید؛ مثلاً ترتیب ردیفها با برچسب مرتبط است. این یکی از بهترین آزمونهای سلامت هر مدل است.
اهمیت سراسری و محلی
اهمیت جایگشتی سراسری است؛ یعنی برای کل داده. گاهی لازم است بدانید چرا مدل برای یک نمونهی خاص یک تصمیم خاص گرفت. به این توضیح محلی میگویند. روشهایی مثل SHAP سهم هر ویژگی را در یک پیشبینی مشخص نشان میدهند.
توضیح محلی برای پاسخ به شکایت کاربر بسیار کاربردی است. اگر کاربری بپرسد چرا پیامش به بخش پرداخت رفت، میتوانید نشان دهید کلمهی «قسط» بیشترین اثر را داشت. این شفافیت اعتماد میسازد.
منحنی یادگیری؛ داده بیشتر یا مدل بهتر؟
آخرین ابزار به سؤالی پاسخ میدهد که هر تیم میپرسد. برای بهتر شدن، دادهی بیشتر جمع کنیم یا مدل را عوض کنیم؟ منحنی یادگیری خطای آموزش و اعتبارسنجی را در برابر اندازهی دادهی آموزش نشان میدهد.
خواندن منحنی
اگر خطای آموزش و اعتبارسنجی هر دو بالا و نزدیک به هماند، مدل کمبرازش دارد. یعنی حتی دادهی آموزش را یاد نگرفته است. دادهی بیشتر کمکی نمیکند. به ویژگی بهتر یا مدل انعطافپذیرتر نیاز دارید.
اگر خطای آموزش پایین و خطای اعتبارسنجی بالاست و فاصله با دادهی بیشتر کم میشود، مدل بیشبرازش دارد. اینجا دادهی بیشتر احتمالاً کمک میکند. تنظیم قویتر یا مدل سادهتر هم گزینههای دیگرند.
رسم منحنی با scikit-learn
تابع learning_curve کار را ساده میکند. مدل را روی درصدهای مختلف دادهی آموزش با اعتبارسنجی متقابل آموزش میدهد و امتیازها را برمیگرداند:
import numpy as np
from sklearn.model_selection import learning_curve

sizes, tr, va = learning_curve(model, X_train, y_train, cv=5, scoring="f1_macro",
                               train_sizes=np.linspace(0.1, 1.0, 6))
for s, a, b in zip(sizes, tr.mean(1), va.mean(1)):
print(f"n={s:5d} train={a:.3f} valid={b:.3f}")تمرین عملی؛ گزارش عیبیابی
یکی از مدلهایی که در قسمتهای قبل ساختید را انتخاب کنید و این گزارش را تهیه کنید:
- تحلیل خطا: سه گروه با بالاترین نرخ خطا و تعداد نمونهی هرکدام.
- اختلاف گروهها: بیشترین اختلاف معیار اصلی بین گروههای کاربران.
- نمایندگی: سهم گروههای ضعیف در دادهی آموزش.
- اهمیت ویژگی: ده ویژگی مهم و بررسی اینکه آیا هیچکدام نشانهی نشت دارد.
- منحنی یادگیری: تشخیص کمبرازش یا بیشبرازش و پیشنهاد قدم بعد.
در پایان، یک اقدام مشخص بنویسید؛ مثلاً «جمعآوری ۳۰۰ پیام کوتاه از کاربران تازه». عیبیابی خوب به اقدام مشخص میرسد، نه به یک فهرست مشاهده.
سخن پایانی
عیبیابی مدل از چهار سؤال شروع میشود؛ کجا، برای چه کسی، چرا در داده و چرا در مدل. تحلیل خطا محل خطاها را پیدا میکند و مقایسهی گروهها اختلاف عملکرد را نشان میدهد. بررسی نمایندگی میگوید آیا کمبود داده علت است و اهمیت ویژگی میگوید مدل به چه تکیه میکند.
منحنی یادگیری هم به سؤال همیشگی پاسخ میدهد: دادهی بیشتر یا مدل بهتر؟ با این ابزارها، به جای حدس زدن، با شواهد تصمیم میگیرید. مدلی که عیبهایش را میشناسید، از مدلی با دقت بالاتر اما ناشناخته قابل اعتمادتر است.
این آموزش بر پایهی درس Model Debugging in Machine Learning using Responsible AI dashboard components از مجموعهی آزاد ML for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
عیبیابی مدل یادگیری ماشین یعنی چه؟
یعنی پیدا کردن اینکه مدل کجا، برای چه کسانی و چرا اشتباه میکند. به جای یک عدد دقت کلی، خطا را به تفکیک گروهها، ویژگیها و نوع داده بررسی میکنیم تا علت اصلی را بیابیم و راهحل مشخصی مثل دادهی بیشتر یا ویژگی تازه انتخاب کنیم.
تحلیل خطا چیست؟
تحلیل خطا روشی است که نمونههای اشتباه مدل را گروهبندی میکند تا ببینیم نرخ خطا در کدام بخش از داده بیشتر است. مثلاً ممکن است مدل برای کاربران جدید یا پیامهای کوتاه نرخ خطای بسیار بالاتری داشته باشد.
اهمیت ویژگی جایگشتی چیست؟
روشی برای سنجیدن اهمیت هر ویژگی است. مقادیر یک ستون را تصادفی جابهجا میکنیم و میبینیم عملکرد مدل چقدر افت میکند. هرچه افت بیشتر، آن ویژگی برای مدل مهمتر است. این روش مستقل از نوع مدل است.
منحنی یادگیری چه چیزی را نشان میدهد؟
منحنی یادگیری خطای آموزش و اعتبارسنجی را در برابر اندازهی دادهی آموزش رسم میکند. اگر هر دو خطا بالا و نزدیک هم باشند، مدل کمبرازش دارد. اگر فاصلهی زیادی دارند، بیشبرازش دارد و دادهی بیشتر احتمالاً کمک میکند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.