
PyTorch یا TensorFlow؛ این سؤالی است که تقریباً هر کسی که یادگیری عمیق را شروع میکند میپرسد. پاسخ کوتاه این است که مهم نیست کدام را اول یاد بگیرید. مفاهیم در هر دو یکساناند و با فهمیدن یکی، دیگری را در چند روز یاد میگیرید. اما دانستن تفاوتهایشان کمک میکند برای هر پروژه انتخاب درستی کنید.
در قسمت قبل با Keras شبکهای برای ارقام دستنویس ساختیم و همهی جزئیات پشت model.fit پنهان بود. حالا پرده را کنار میزنیم. در این قسمت تنسور و مشتقگیری خودکار را میشناسیم، یک حلقهی آموزش کامل را دستی در PyTorch مینویسیم و معادلش را در Keras میبینیم.
دو کار اصلی هر چارچوب یادگیری عمیق
هر چارچوب یادگیری عمیق دو کار اصلی انجام میدهد. اول، عملیات سریع روی تنسورها؛ مثل ضرب ماتریس و توابع فعالسازی، ترجیحاً روی پردازندهی گرافیکی. دوم، محاسبهی خودکار گرادیان برای نزول گرادیان. در قسمت ششم هر دو را دستی نوشتیم و دیدیم چقدر زحمت دارد.
تنسور؛ آرایهی هوشمند
تنسور آرایهای چندبعدی از عددهاست. یک عدد تنسور صفربعدی است، یک بردار یکبعدی و یک ماتریس دوبعدی. تصویر رنگی تنسور سهبعدی است؛ ارتفاع، عرض و کانال رنگ. یک دسته تصویر هم تنسور چهاربعدی است.
تنسور شبیه آرایهی NumPy است، با دو تفاوت مهم. میتواند روی پردازندهی گرافیکی اجرا شود که محاسبات را دهها برابر سریعتر میکند. و چارچوب همهی عملیات روی آن را ثبت میکند تا بعداً گرادیان را حساب کند.
مشتقگیری خودکار
وقتی روی تنسورها محاسبه میکنید، چارچوب یک گراف محاسباتی میسازد. این گراف نشان میدهد هر عدد از کدام عملیات روی کدام عددها به دست آمده است. برای محاسبهی گرادیان، چارچوب از خطا شروع میکند و با قاعدهی زنجیرهای به عقب میرود.
این همان پسانتشار خطاست که در قسمت ششم با دست نوشتیم. در PyTorch کافی است روی خطا backward() را صدا بزنید. در TensorFlow محاسبات را داخل یک GradientTape انجام میدهید و بعد گرادیان را از آن میخواهید.
PyTorch و TensorFlow؛ مقایسهی عملی
هر دو چارچوب بالغ، سریع و پرکاربردند. تفاوتهایشان بیشتر در سبک کار و اکوسیستم است تا در توانایی. جدول زیر مهمترین تفاوتها را خلاصه میکند.
| معیار | PyTorch | TensorFlow با Keras |
|---|---|---|
| سبک کد | نزدیک به پایتون معمولی | رابط سطح بالای ساده با Keras |
| حلقهی آموزش | معمولاً دستی و انعطافپذیر | معمولاً fit آماده |
| پژوهش و مقالهها | رایجتر | کمتر |
| مدلهای زبانی و Hugging Face | پشتیبانی اصلی | پشتیبانی محدودتر |
| استقرار موبایل و مرورگر | ExecuTorch، ONNX | TensorFlow Lite، TensorFlow.js |
کدام را انتخاب کنیم؟
اگر هدفتان کار با مدلهای زبانی، Hugging Face یا پیادهسازی مقالههای تازه است، PyTorch انتخاب طبیعیتری است. بیشتر مدلهای باز امروز اول برای PyTorch منتشر میشوند. اگر به استقرار روی گوشی یا مرورگر فکر میکنید، ابزارهای TensorFlow هنوز بسیار قویاند.
Keras 3 هم امکان جالبی دارد. میتواند روی PyTorch، TensorFlow یا JAX اجرا شود. پس کدی که با Keras مینویسید، به یک چارچوب زیرین قفل نیست. برای شروع و نمونهسازی سریع، این انعطاف ارزشمند است.
رابط سطح بالا و سطح پایین
هر دو چارچوب دو سطح دارند. در سطح بالا، مدل را با چند لایه تعریف میکنید و با یک دستور آموزش میدهید. در سطح پایین، حلقهی آموزش را خودتان مینویسید و کنترل کامل دارید.
سطح بالا برای مسائل رایج سریعتر است. سطح پایین وقتی لازم میشود که کاری غیرمعمول انجام دهید؛ مثلاً دو مدل را همزمان آموزش دهید یا خطای سفارشی داشته باشید. درک سطح پایین حتی اگر همیشه از سطح بالا استفاده کنید، در عیبیابی بسیار کمک میکند.
بیشتر بخوانید: شبکهی MNIST و روشهای جلوگیری از بیشبرازش را که امروز در PyTorch بازسازی میکنیم، در ساخت شبکه عصبی با پایتون دیدیم.
حلقه آموزش در PyTorch از صفر
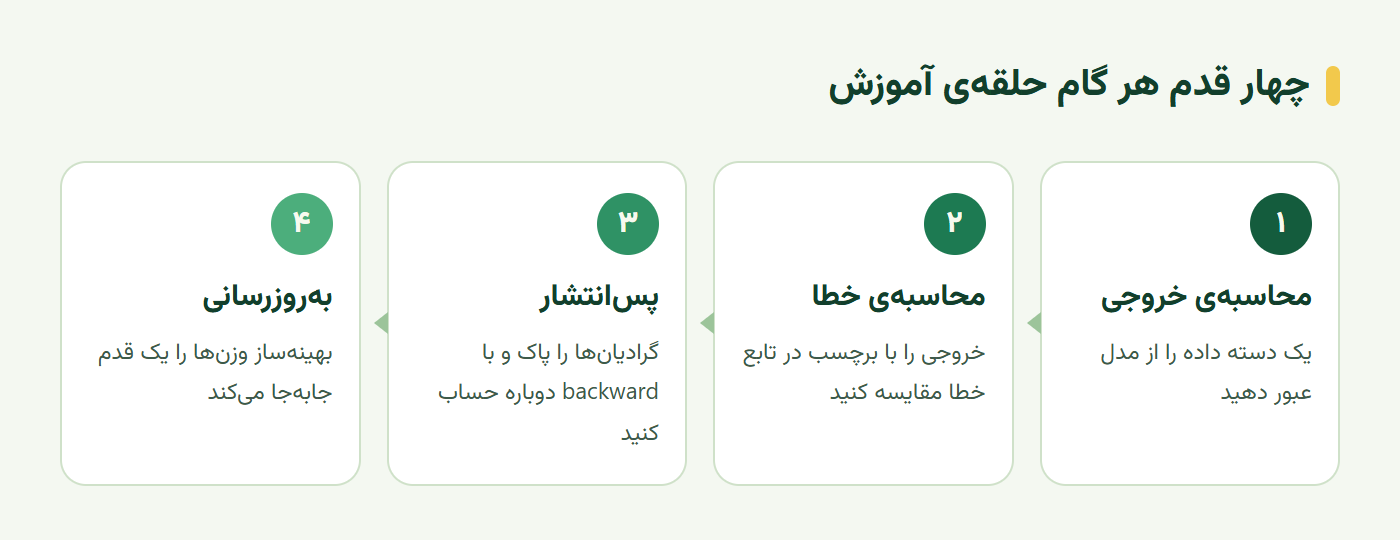
حالا همان شبکهی قسمت قبل را در PyTorch با حلقهی آموزش دستی میسازیم. این کد همهی چیزهایی را نشان میدهد که fit در Keras پنهان میکرد. نمودار زیر چهار قدم هر گام آموزش را نشان میدهد.
تعریف مدل و داده
در PyTorch، مدل یک کلاس است که از nn.Module ارث میبرد. داده هم با DataLoader به دستههای کوچک تقسیم میشود:
import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

tf = transforms.ToTensor()
train = datasets.MNIST("data", train=True, download=True, transform=tf)
train_dl = DataLoader(train, batch_size=128, shuffle=True)

device = "cuda" if torch.cuda.is_available() else "cpu"
model = nn.Sequential(nn.Flatten(), nn.Linear(784, 256), nn.ReLU(),
                      nn.Dropout(0.3), nn.Linear(256, 10)).to(device)
loss_fn = nn.CrossEntropyLoss()
opt = torch.optim.Adam(model.parameters(), lr=1e-3)
به یک تفاوت دقت کنید. لایهی آخر softmax ندارد. CrossEntropyLoss در PyTorch خودش softmax را داخلی اعمال میکند. اگر softmax را دو بار بزنید، آموزش کند و ناپایدار میشود. این یکی از خطاهای رایج مهاجران از Keras است.
چهار قدم هر گام آموزش
حلقهی آموزش در هر گام چهار کار انجام میدهد. خروجی را حساب میکند، خطا را میسنجد، گرادیان را با پسانتشار حساب میکند و وزنها را بهروز میکند:
for epoch in range(5):
model.train()
for x, y in train_dl:
x, y = x.to(device), y.to(device)
logits = model(x) # ۱. محاسبهی خروجی
loss = loss_fn(logits, y) # ۲. محاسبهی خطا
opt.zero_grad()
loss.backward() # ۳. پسانتشار
opt.step() # ۴. بهروزرسانی وزنها
print(epoch, round(loss.item(), 4))zero_grad گرادیانهای گام قبل را پاک میکند؛ چون PyTorch بهطور پیشفرض گرادیانها را جمع میکند. فراموش کردن این خط یکی از رایجترین باگهاست. model.train() هم Dropout را فعال میکند. در ارزیابی باید model.eval() و torch.no_grad() را به کار ببرید.
همان حلقه در Keras و Hugging Face
در Keras، همهی این چهار قدم داخل fit انجام میشود. اگر به کنترل بیشتری نیاز داشته باشید، میتوانید train_step را بازنویسی کنید. این ترکیبی از سادگی و انعطاف است.
رابط Trainer در Hugging Face
در دنیای مدلهای زبانی، کتابخانهی Transformers یک رابط سطح بالا به نام Trainer دارد. این رابط روی PyTorch ساخته شده و حلقهی آموزش، ارزیابی، ذخیرهی نقطهی بازیابی و آموزش روی چند پردازندهی گرافیکی را آماده دارد.
در قسمتهای بعدی این مجموعه، هنگام تنظیم مدلهای ترنسفورمر، از Trainer استفاده میکنیم. اما چون حالا حلقهی دستی را میشناسید، میدانید دقیقاً چه اتفاقی داخل آن میافتد.
کدام سطح برای کدام کار؟
برای مسائل رایج مثل دستهبندی تصویر یا متن، رابط سطح بالا کافی و سریعتر است. برای پژوهش، خطای سفارشی یا معماریهای غیرمعمول، حلقهی دستی کنترل لازم را میدهد.
قاعدهی سرانگشتی این است؛ با سطح بالا شروع کنید. هر وقت به دیواری خوردید که سطح بالا اجازهی عبور نداد، سطح پایین را باز کنید. این مسیر هم سریع است و هم وقتی لازم شد، کنترل کامل را از دست نمیدهید.
تمرین عملی؛ یک مدل در دو چارچوب
این تمرین کمک میکند تفاوتها را از نزدیک ببینید:
- PyTorch: حلقهی آموزش بالا را کامل کنید و یک حلقهی ارزیابی با
model.eval()وtorch.no_grad()اضافه کنید. - Keras: همان معماری را با
Sequentialوfitبسازید. - مقایسه: دقت آزمون، زمان آموزش هر دوره و تعداد خط کد را در یک جدول بنویسید.
- باگ عمدی: خط
zero_gradرا حذف کنید و ببینید منحنی خطا چه تغییری میکند.
آخرین آزمایش ارزش زیادی دارد. دیدن اثر یک باگ رایج، دفعهی بعد تشخیصش را بسیار سریعتر میکند.
سخن پایانی
PyTorch و TensorFlow هر دو دو کار اصلی را خودکار میکنند؛ محاسبات تنسوری روی پردازندهی گرافیکی و مشتقگیری خودکار. PyTorch در پژوهش و مدلهای زبانی رایجتر است و TensorFlow در استقرار موبایل و مرورگر قوی است. Keras 3 هم روی هر دو اجرا میشود.
حلقهی آموزش در هر دو چهار قدم دارد؛ خروجی، خطا، پسانتشار و بهروزرسانی. وقتی این چهار قدم را بشناسید، رابطهای سطح بالا دیگر جعبهی سیاه نیستند و عیبیابی بسیار آسانتر میشود.
این آموزش بر پایهی درس Neural Network Frameworks از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) و بخش Fine-tuning a model with the Trainer API از دورهی Hugging Face (مجوز Apache 2.0) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
PyTorch بهتر است یا TensorFlow؟
هیچکدام مطلقاً بهتر نیست. PyTorch در پژوهش و مدلهای زبانی و Hugging Face رایجتر است و کدش به پایتون معمولی نزدیکتر است. TensorFlow با Keras رابط سادهتری برای شروع دارد و ابزارهای استقرار موبایل و مرورگر آن قویاند. مفاهیم در هر دو یکساناند.
تنسور چیست؟
تنسور آرایهای چندبعدی از عددهاست؛ مثل بردار برای یک بعد، ماتریس برای دو بعد و آرایهی سهبعدی برای یک تصویر رنگی. تفاوتش با آرایهی NumPy این است که میتواند روی پردازندهی گرافیکی اجرا شود و گرادیانش خودکار حساب شود.
مشتقگیری خودکار چیست؟
قابلیتی است که چارچوب همهی عملیات روی تنسورها را ثبت میکند و بعد با قاعدهی زنجیرهای، گرادیان خطا نسبت به هر پارامتر را خودکار حساب میکند. در PyTorch با دستور backward و در TensorFlow با GradientTape انجام میشود.
حلقه آموزش در یادگیری عمیق چه مراحلی دارد؟
در هر گام، یک دسته داده به مدل داده میشود، خروجی و خطا حساب میشود، گرادیانها با پسانتشار محاسبه میشوند و بهینهساز وزنها را بهروز میکند. پس از هر دوره هم مدل روی دادهی اعتبارسنجی سنجیده میشود.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.