
بینایی کامپیوتر چیست و چرا مدلی که روی عکسهای آزمایشگاه عالی بود، روی عکسهای گوشی کاربران شکست میخورد؟ گاهی دلیلش پیچیده نیست. عکسها با ترتیب رنگ اشتباه خوانده شدهاند، اندازهشان با شکل غلط تغییر کرده یا نرمالسازی با آموزش یکی نیست. بسیاری از مشکلات بینایی کامپیوتر پیش از رسیدن تصویر به مدل رخ میدهند.
در قسمتهای قبل شبکهی عصبی ساختیم و حلقهی آموزش را شناختیم. از این قسمت وارد بینایی کامپیوتر میشویم. در این قسمت یاد میگیریم کامپیوتر تصویر را چطور میبیند و آن را چطور برای مدل آماده کنیم. ابزار اصلیمان کتابخانهی OpenCV است.
بینایی کامپیوتر چیست؟
بینایی کامپیوتر شاخهای از علم است که هدفش این است که کامپیوتر از تصویر دیجیتال درک سطح بالا پیدا کند. یعنی وقتی عکسی میبیند، بتواند بگوید چه چیزی در آن هست، کجاست و چه اتفاقی در حال رخ دادن است.
امروز بیشتر وظایف بینایی کامپیوتر با شبکههای عصبی انجام میشود. اما پیش از آن، دههها روشهای پردازش تصویر کلاسیک توسعه یافت. این روشها هنوز ارزش دارند؛ هم برای پیشپردازش و هم برای کارهایی که بدون شبکهی عصبی سادهتر حل میشوند.
وظایف اصلی بینایی کامپیوتر
بینایی کامپیوتر چند وظیفهی اصلی دارد که هرکدام سؤال متفاوتی میپرسد:
- طبقهبندی تصویر: کل تصویر چیست؟ گربه یا سگ؟
- تشخیص شیء: چه اشیایی در تصویر هست و هرکدام کجاست؟
- بخشبندی: هر پیکسل متعلق به کدام شیء یا ناحیه است؟
- ردیابی و حرکت: در ویدئو چه چیزی حرکت میکند و به کجا؟
در دستیار آموزشی، طبقهبندی میتواند تشخیص دهد عکس ارسالی گواهینامه است یا کارت شناسایی. تشخیص شیء میتواند محل امضا را در یک سند پیدا کند. هرکدام را در قسمتهای بعدی جداگانه میبینیم.
کتابخانههای پردازش تصویر در پایتون
چند کتابخانهی اصلی برای کار با تصویر وجود دارد. imageio برای خواندن و نوشتن قالبهای مختلف تصویر ساده و مناسب است. Pillow عملیات پایه مثل تغییر اندازه و برش را پشتیبانی میکند.
OpenCV قدرتمندترین و سریعترین آنهاست و به C++ نوشته شده است. استاندارد عملی پردازش تصویر به حساب میآید و صدها الگوریتم دارد. dlib هم برای کارهایی مثل تشخیص نقطههای کلیدی چهره کاربرد دارد.
کامپیوتر تصویر را چطور میبیند؟
برای کامپیوتر، تصویر فقط یک آرایه از عددهاست. تصویر سیاهوسفید یک ماتریس دوبعدی است که هر خانه روشنایی یک پیکسل است. تصویر رنگی یک آرایهی سهبعدی است؛ ارتفاع، عرض و سه کانال رنگ.
تصویر بهعنوان آرایهی NumPy
با OpenCV، خواندن تصویر یک خط است و نتیجه یک آرایهی NumPy است. شکل این آرایه برای یک عکس ۶۴۰ در ۴۸۰ رنگی، ۴۸۰ در ۶۴۰ در ۳ است. دقت کنید؛ اول ارتفاع و بعد عرض.
import cv2
import matplotlib.pyplot as plt

im = cv2.imread("certificate.jpg")          # BGR
print(im.shape, im.dtype, im.min(), im.max())
im = cv2.cvtColor(im, cv2.COLOR_BGR2RGB)
plt.imshow(im)
plt.show()
مقدار هر پیکسل عددی صحیح بین صفر و ۲۵۵ است. صفر یعنی بدون نور و ۲۵۵ یعنی بیشترین شدت. سه عدد هر پیکسل با هم رنگ آن را میسازند.
دام BGR و RGB
OpenCV به دلایل تاریخی رنگها را به ترتیب آبی، سبز، قرمز یا BGR میخواند. تقریباً همهی کتابخانههای دیگر، از Matplotlib تا PyTorch، ترتیب RGB را انتظار دارند. اگر تبدیل را فراموش کنید، رنگ پوست آبی و آسمان نارنجی دیده میشود.
این خطا در نمایش واضح است. اما در آموزش مدل بیصداست. مدلی که با RGB آموزش دیده و در استقرار BGR میگیرد، خطا نمیدهد؛ فقط دقتش پایین میآید. پس ترتیب رنگ را در قرارداد ورودی مدل صریح بنویسید.
بیشتر بخوانید: کار با تنسور و ترتیب ابعاد در PyTorch را که تصویر پس از پیشپردازش به آن تبدیل میشود، در PyTorch یا TensorFlow؟ دیدیم.
پیشپردازش تصویر با OpenCV
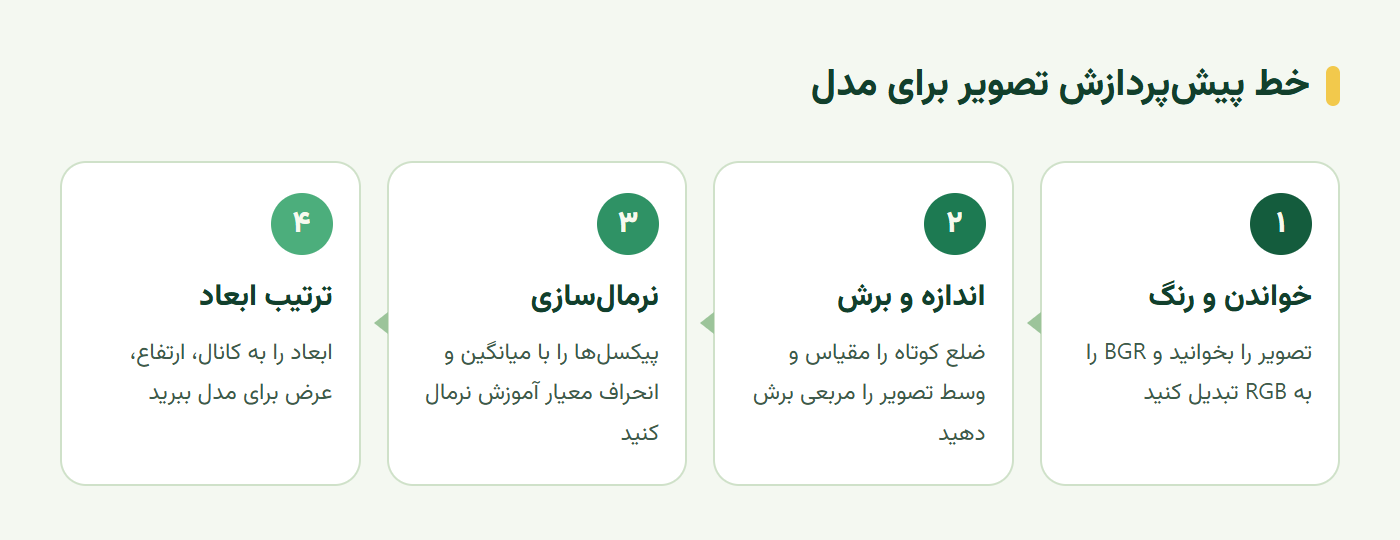
پیش از دادن تصویر به شبکهی عصبی، معمولاً چند قدم پیشپردازش لازم است. این قدمها تصویرها را یکدست میکنند و گاهی کار مدل را بسیار سادهتر. نمودار زیر خط پیشپردازش استاندارد را نشان میدهد.
تغییر اندازه و برش
شبکهی عصبی معمولاً ورودی با اندازهی ثابت میخواهد؛ مثلاً ۲۲۴ در ۲۲۴. تغییر اندازه با cv2.resize انجام میشود. اما اگر تصویر مستطیلی را مستقیم به مربع تبدیل کنید، شکل اشیا کشیده میشود.
راه بهتر این است که اول ضلع کوتاهتر را به اندازهی مطلوب برسانید و بعد وسط تصویر را مربعی برش دهید. روش دیگر افزودن حاشیه است. هر روشی که انتخاب کردید، دقیقاً همان را در آموزش و استقرار به کار ببرید.
نرمالسازی و ترتیب ابعاد
پس از تغییر اندازه، مقدار پیکسلها را از بازهی صفر تا ۲۵۵ به عددهای کوچکتر میبریم. سادهترین روش تقسیم بر ۲۵۵ است. مدلهای آمادهای که روی ImageNet آموزش دیدهاند، نرمالسازی دقیقتری با میانگین و انحراف معیار هر کانال میخواهند.
قدم آخر ترتیب ابعاد است. OpenCV و NumPy ترتیب ارتفاع، عرض، کانال دارند. PyTorch ترتیب کانال، ارتفاع، عرض را انتظار دارد. با transpose یا permute ترتیب را عوض کنید:
import numpy as np

MEAN = np.array([0.485, 0.456, 0.406])
STD = np.array([0.229, 0.224, 0.225])

def preprocess(path, size=224):
    im = cv2.cvtColor(cv2.imread(path), cv2.COLOR_BGR2RGB)
    h, w = im.shape[:2]
    s = size / min(h, w)
    im = cv2.resize(im, (round(w * s), round(h * s)), interpolation=cv2.INTER_AREA)
    h, w = im.shape[:2]
    top, left = (h - size) // 2, (w - size) // 2
    im = im[top:top + size, left:left + size] / 255.0
    return ((im - MEAN) / STD).transpose(2, 0, 1).astype("float32")
پردازش تصویر کلاسیک؛ بدون شبکه عصبی
همهی کارهای بینایی کامپیوتر به شبکهی عصبی نیاز ندارند. گاهی چند عملیات کلاسیک کار را سادهتر، سریعتر و قابل توضیحتر انجام میدهند.
آستانهگذاری و تشخیص لبه
آستانهگذاری تصویر خاکستری را به سیاه و سفید تبدیل میکند. پیکسلهای روشنتر از آستانه سفید و بقیه سیاه میشوند. این کار برای جدا کردن متن از پسزمینه در عکس یک سند بسیار مفید است. آستانهگذاری تطبیقی با نور ناهمگون عکسهای گوشی هم کنار میآید.
در یکی از مثالهای درس اصلی، عکس یک کتاب بریل با آستانهگذاری، تشخیص نقطه و تبدیل پرسپکتیو پردازش میشود. نتیجه نقطههای برجستهی بریل است که با یک قاعدهی ساده به حروف تبدیل میشوند. هیچ شبکهی عصبی لازم نبود.
تشخیص حرکت و جریان نوری
در ویدئوی دوربین ثابت، فریمهای پشت سر هم باید تقریباً یکسان باشند. تفاوت دو فریم پشت سر هم، ناحیههای در حال حرکت را نشان میدهد. این سادهترین روش تشخیص حرکت است.
جریان نوری یک قدم جلوتر میرود. برای هر پیکسل یا نقطهی کلیدی، جهت و اندازهی حرکت را حساب میکند. نسخهی متراکم برای همهی پیکسلها و نسخهی پراکنده فقط برای نقطههای متمایز کار میکند. با آن میشود مثلاً حرکت دست را در ویدئو ردیابی کرد.
تمرین عملی؛ قرارداد ورودی تصویر
برای یک کاربرد بینایی در پروژهی خودتان، مثل تشخیص نوع سند ارسالی، این کارها را انجام دهید:
- ده تصویر واقعی: از منبع واقعی، مثلاً گوشی کاربران، جمع کنید و شکل و اندازهشان را ثبت کنید.
- خط پیشپردازش: تابع
preprocessرا برای آنها اجرا و خروجی را نمایش دهید. - آزمون رنگ: یک تصویر را بدون تبدیل BGR به RGB نمایش دهید و تفاوت را ببینید.
- قرارداد ورودی: اندازه، ترتیب رنگ، ترتیب ابعاد و نرمالسازی را در یک سند کوتاه بنویسید.
- روش کلاسیک: یک تصویر سند را با آستانهگذاری تطبیقی سیاهوسفید کنید.
قرارداد ورودی را کنار کد مدل نگه دارید. هر کسی که مدل را مستقر میکند، باید دقیقاً همان را پیاده کند.
سخن پایانی
بینایی کامپیوتر به کامپیوتر یاد میدهد از تصویر معنا بیرون بکشد. برای کامپیوتر، تصویر فقط آرایهای از عددهاست؛ ارتفاع، عرض و کانال رنگ. OpenCV ابزار اصلی خواندن و پردازش این آرایههاست.
بیشتر خطاهای بیصدای بینایی کامپیوتر در پیشپردازش رخ میدهند؛ ترتیب رنگ، تغییر اندازه، نرمالسازی و ترتیب ابعاد. یک قرارداد ورودی مکتوب این خطاها را از بین میبرد. و یادتان باشد، گاهی چند عملیات کلاسیک از یک شبکهی عصبی کارآمدتر است.
این آموزش بر پایهی درس Introduction to Computer Vision از مجموعهی آزاد AI for Beginners مایکروسافت (مجوز MIT) به فارسی بازنویسی و تکمیل شده است.
پرسشهای پرتکرار
بینایی کامپیوتر چیست؟
بینایی کامپیوتر شاخهای از هوش مصنوعی است که به کامپیوتر یاد میدهد از تصویر و ویدئو معنا استخراج کند؛ مثل تشخیص اینکه در عکس چه چیزی هست، اشیا کجا قرار دارند یا چه حرکتی در ویدئو رخ داده است.
وظایف اصلی بینایی کامپیوتر کداماند؟
طبقهبندی تصویر که میگوید کل تصویر چیست، تشخیص شیء که محل اشیا را با کادر مشخص میکند، بخشبندی که برای هر پیکسل برچسب میزند، و وظایفی مثل تشخیص چهره، خواندن متن و ردیابی حرکت.
OpenCV چیست؟
OpenCV کتابخانهی متنباز و بسیار سریع پردازش تصویر و ویدئو است که به C++ نوشته شده و رابط پایتون دارد. برای خواندن تصویر، تغییر اندازه، تبدیل رنگ، فیلتر، آستانهگذاری، تشخیص لبه و جریان نوری استفاده میشود.
چرا باید تصویر را پیش از مدل نرمال کرد؟
چون مقدار پیکسلها بین صفر و ۲۵۵ است و شبکهی عصبی با عددهای کوچک و هممقیاس بهتر آموزش میبیند. همچنین مدلهای آماده با نرمالسازی خاصی آموزش دیدهاند و اگر ورودی را متفاوت نرمال کنید، دقتشان بهشدت افت میکند.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. شروعکننده باشید — پرسش و اصلاح را با آغوش باز میپذیریم.